 andreyglauzer/vigilantonion
🐍 - टोर नेटवर्क साइटों पर क्रॉलर, कीवर्ड खोजता है।



टोर नेटवर्क साइटों पर क्रॉलर, कीवर्ड खोजता है।
VigilantOnion को Cyber Threat Intelligence टीमों द्वारा पूरक बनाया गया है ताकि वे टोर नेटवर्क पर की गई परामर्शों की निगरानी कर सकें और सर्वोत्तम परिणाम प्राप्त कर सकें।
इसके पहले संस्करण में प्रशासन और डैशबोर्ड के निर्माण के लिए django का उपयोग किया गया था, जिसके उपयोग में बहुत कठिनाई थी। इस नए संस्करण में, परामर्श और झूठे सकारात्मक (false positives) को खत्म करने के लिए उपयोग की जाने वाली कार्यप्रणाली बेहतर है।
झूठे सकारात्मक को खत्म करने और सटीकता का स्तर बेहतर बनाने के लिए, मैं yararule और नोट्स का उपयोग कर रहा हूँ, उन नियमों के लिए उच्च मान निर्धारित कर रहा हूँ जिन्हें मैं सबसे प्रासंगिक मानता हूँ, जैसा कि नीचे दिए गए चित्र में दिखाया गया है:
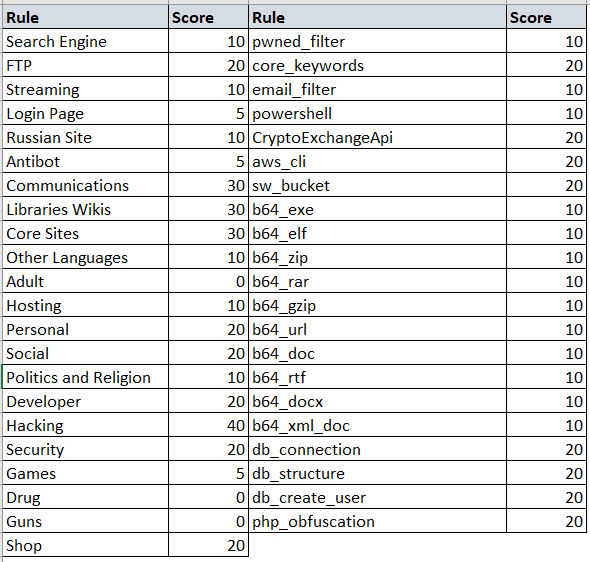
ये मान गतिशील हैं और आपकी आवश्यकता के अनुसार बदल सकते हैं।
नए yararules को श्रेणियों और कीवर्ड फ़ाइलों दोनों में जोड़ा जा सकता है, ताकि आप झूठे सकारात्मक को खत्म कर सकें और अधिक सुखद परिणाम प्राप्त कर सकें।
सेटिंग्स फ़ाइल में कुछ चीज़ें बदलने की आवश्यकता है, हालाँकि वे स्क्रिप्ट का उपयोग करने के लिए बहुत महत्वपूर्ण हैं।
नीचे दिए गए फ़ील्ड टोर नेटवर्क प्रॉक्सी को कॉन्फ़िगर करने के लिए हैं, यदि आप Windows स्क्रिप्ट चला रहे हैं तो पोर्ट आमतौर पर 9051 में बदल जाता है
server_proxy:  localhost
port_proxy:  9050
type_proxy:  socks5h
timeout सर्वर फ़ील्ड आपके लिए अनुरोधों की प्रतीक्षा करने का समय निर्धारित करने के लिए है, समय जितना अधिक होगा, स्क्रिप्ट को उतना ही अधिक समय लग सकता है।
timeout: 30
score सर्वर फ़ील्ड आपके लिए URL के क्रॉल किए जाने और syslog में भेजे जाने के लिए न्यूनतम स्कोर मान निर्धारित करने के लिए हैं।
score_categorie:  20
score_keywords:  40
कुछ urls ऑफ़लाइन होंगे और यह जानना कठिन है कि वे वापस आएंगे या नहीं, इसलिए मैंने एक काउंटर बनाया है, जिससे आप अधिकतम प्रयासों की संख्या निर्धारित कर सकते हैं, जो एक बार पूरी हो जाने पर स्क्रिप्ट उस url तक पहुँचने का प्रयास नहीं करेगी।
count_categories: 5
जब भी url में क्रॉलर किया जाता है तो इसे उस अंतिम स्कैन की तारीख के साथ सहेजा जाता है, और आप उसी url में एक स्कैन और दूसरे स्कैन के बीच दिनों की समय सीमा निर्धारित कर सकते हैं।
daystime: 10
और अंत में मैं अब django का उपयोग नहीं करता, अब अपने परिणाम देखने के लिए आपको Splunk या ELK जैसे syslog की आवश्यकता है, और आपको बस उन्हें यहाँ परिभाषित करना है
sendlog:  True
logport:  5151
logip:  "localhost"
इसका उपयोग सरल है, आपको बस tor और python लाइब्रेरीज़ इंस्टॉल करने की आवश्यकता है, ऐसा करने के लिए नीचे दिया गया कमांड चलाएँ:
pip install -r requirements.txt
tor क्लाइंट और इंस्टॉल की गई लाइब्रेरीज़ के बाद इसके उपयोग के विवरण प्राप्त करने के लिए --help कमांड का उपयोग करें।
➜  python3 observer.py -h
usage: observer.py [-h] [--config CONFIG] [--crawler] [--url URL] [--search]
                   [--engines ENGINES] [--find FIND] [--pastebin PASTEBIN]

VigilantOnion is a script to collect as many sites from the onion network as
possible and add them to a database. With all possible sites collected, a
crawler will be created so that we can monitor the search for keywords defined
by you.

optional arguments:
  -h, --help            show this help message and exit
  --config CONFIG, -c CONFIG
                        Configuration file in yaml format
  --crawler             Starts the TOR network URL crawler process.
  --url URL, -u URL     Specifies the URL to crawl.
  --search              Start the URL search process on the surface. Select a
                        framework where you want to search for urls.
  --engines ENGINES, -e ENGINES
                        Validates the available engines for searching URLs.
  --find FIND, -f FIND  Search for arguments on .onion network research sites
  --pastebin PASTEBIN   Search for .onion urls in pastebin paste.

You can also develop new framework so that the database has more urls onions.
स्क्रिप्ट के काम करने के लिए आपको नए URL चाहिए, और उसके लिए मैंने एक विधि बनाई है जो सतह पर URL खोजती है, जैसे नीचे दिए गए उदाहरण में:
python3.6 observer.py --config config/config.yml --search -e "gist,reddit,cybersecuritynews,discoverdarkwebservice"
आप pastebin फ़ाइलों से सीधे URL भी प्राप्त कर सकते हैं, जैसे नीचे दिए गए उदाहरण में:
python3.6 observer.py --config config/config.yml --search --pastebin "s7TPZCKz,kSaYqtVX,0GYEEApe,3qkqyqiM,RfgBLg5Q,gtksBij4,FpPzQKHg,wB0uh00r,jDGJhQCC,q6DZ9U,ac2TnUjY,pv4xRWXQ,PgLUE7pF,9XW5Pc7R,hqyGMi7e,UZRM2z8y,7tQvV5CU,9JhVq3H3,Cb5HTydt,kMW5wp3N,v5Yq66sH,2q3SsR3a,gnd8jx97,QwSJYhYF,iNydrDfe"
कुछ URL एकत्र करने के बाद, आप क्रॉलर प्रक्रिया शुरू कर सकते हैं। ध्यान रखें कि पहली बार सबसे अधिक समय लगेगा क्योंकि वहीं वेबसाइट सामग्री का वर्गीकरण और श्रेणीकरण किया जाएगा।
python3.6 observer.py --config config/config.yml --crawler
यदि आप किसी एकल URL को क्रॉल करना चाहते हैं, तो उपयोग करें:
python3.6 observer.py --config config/config.yml --crawler --url "76qugh5bey5gum7l.onion"
परिणाम का आउटपुट json है, और उसी प्रारूप में इसे चुने गए syslog पर भेजा जाता है।
{
  "lastscan": "2020-06-29",
  "id": 10760,
  "type": "URI",
  "url": "lolitmhfkpif7sky.onion",
  "title": "Lolita Club",
  "baseurl": "vyqi2nm36otufrgg.onion",
  "status": "Online",
  "count_status": 0,
  "source": "Script",
  "categorie": [
    {
      "full_categorie": [
        "no_match"
      ],
      "score_categorie": 0
    }
  ],
  "keywords": [
    {
      "full_keywords": [
        "no_match"
      ],
      "score_keywords": 0
    }
  ],
  "discovery_date": "2020-06-29 14:24"
}
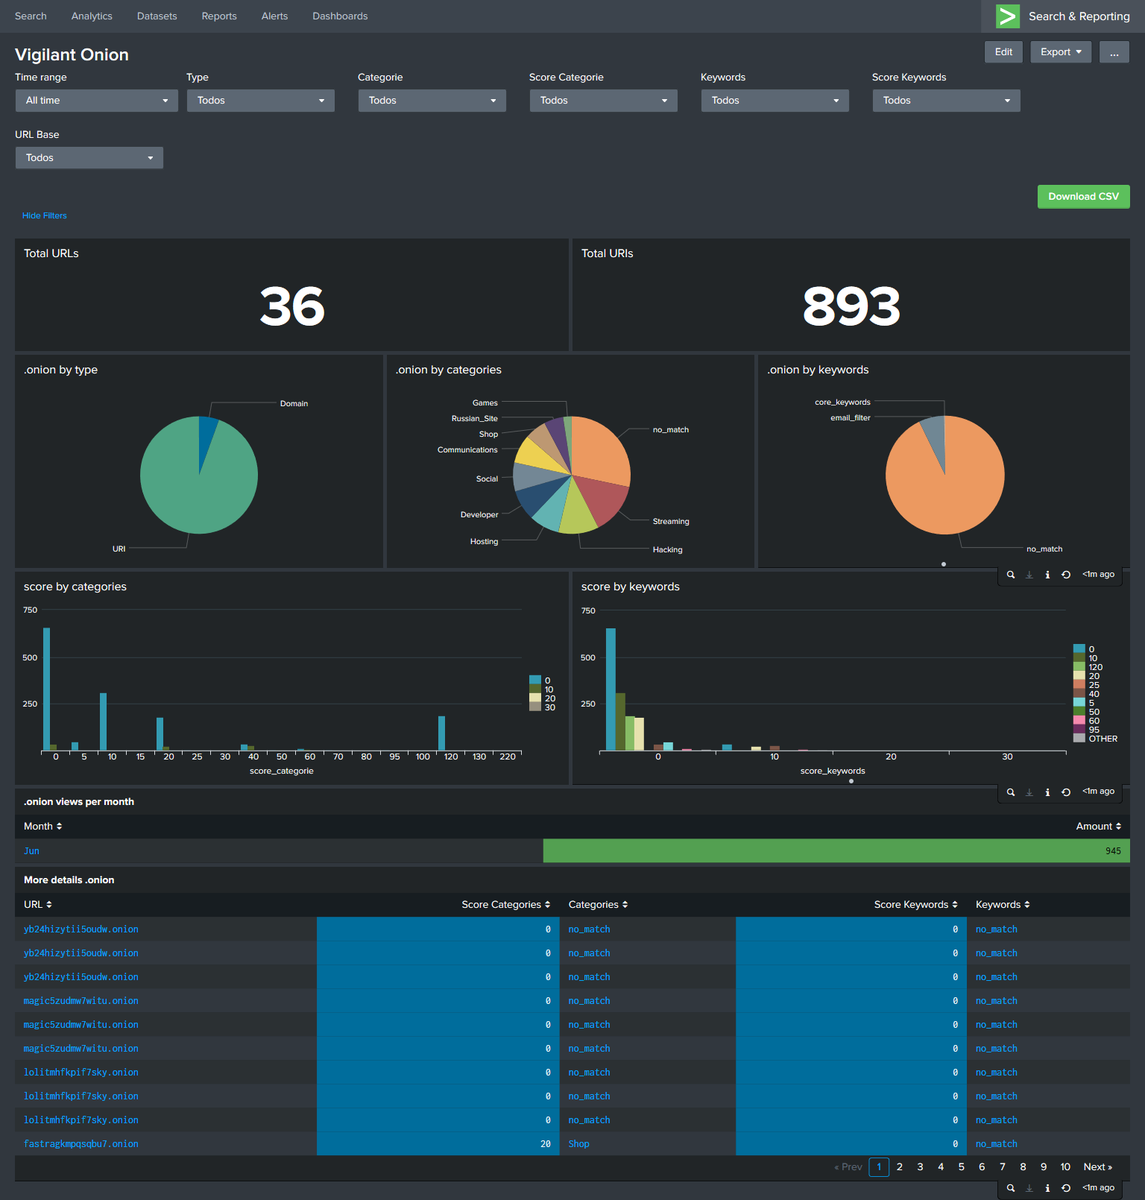
मैं splunk का उपयोग करता हूँ, और आप अपना डैशबोर्ड मेरे जैसा बना सकते हैं:
परियोजना में सहयोग करने के लिए बेझिझक fork करें या issue खोलें।
