 suraj-ranganath/stealthrl
StealthRL : framework de RL pour la reformulation adverse de textes d'IA afin de tester la robustesse des détecteurs.

Article (arXiv)
Démo
Modèle (Hugging Face)
Jeu de données de référence (Hugging Face)
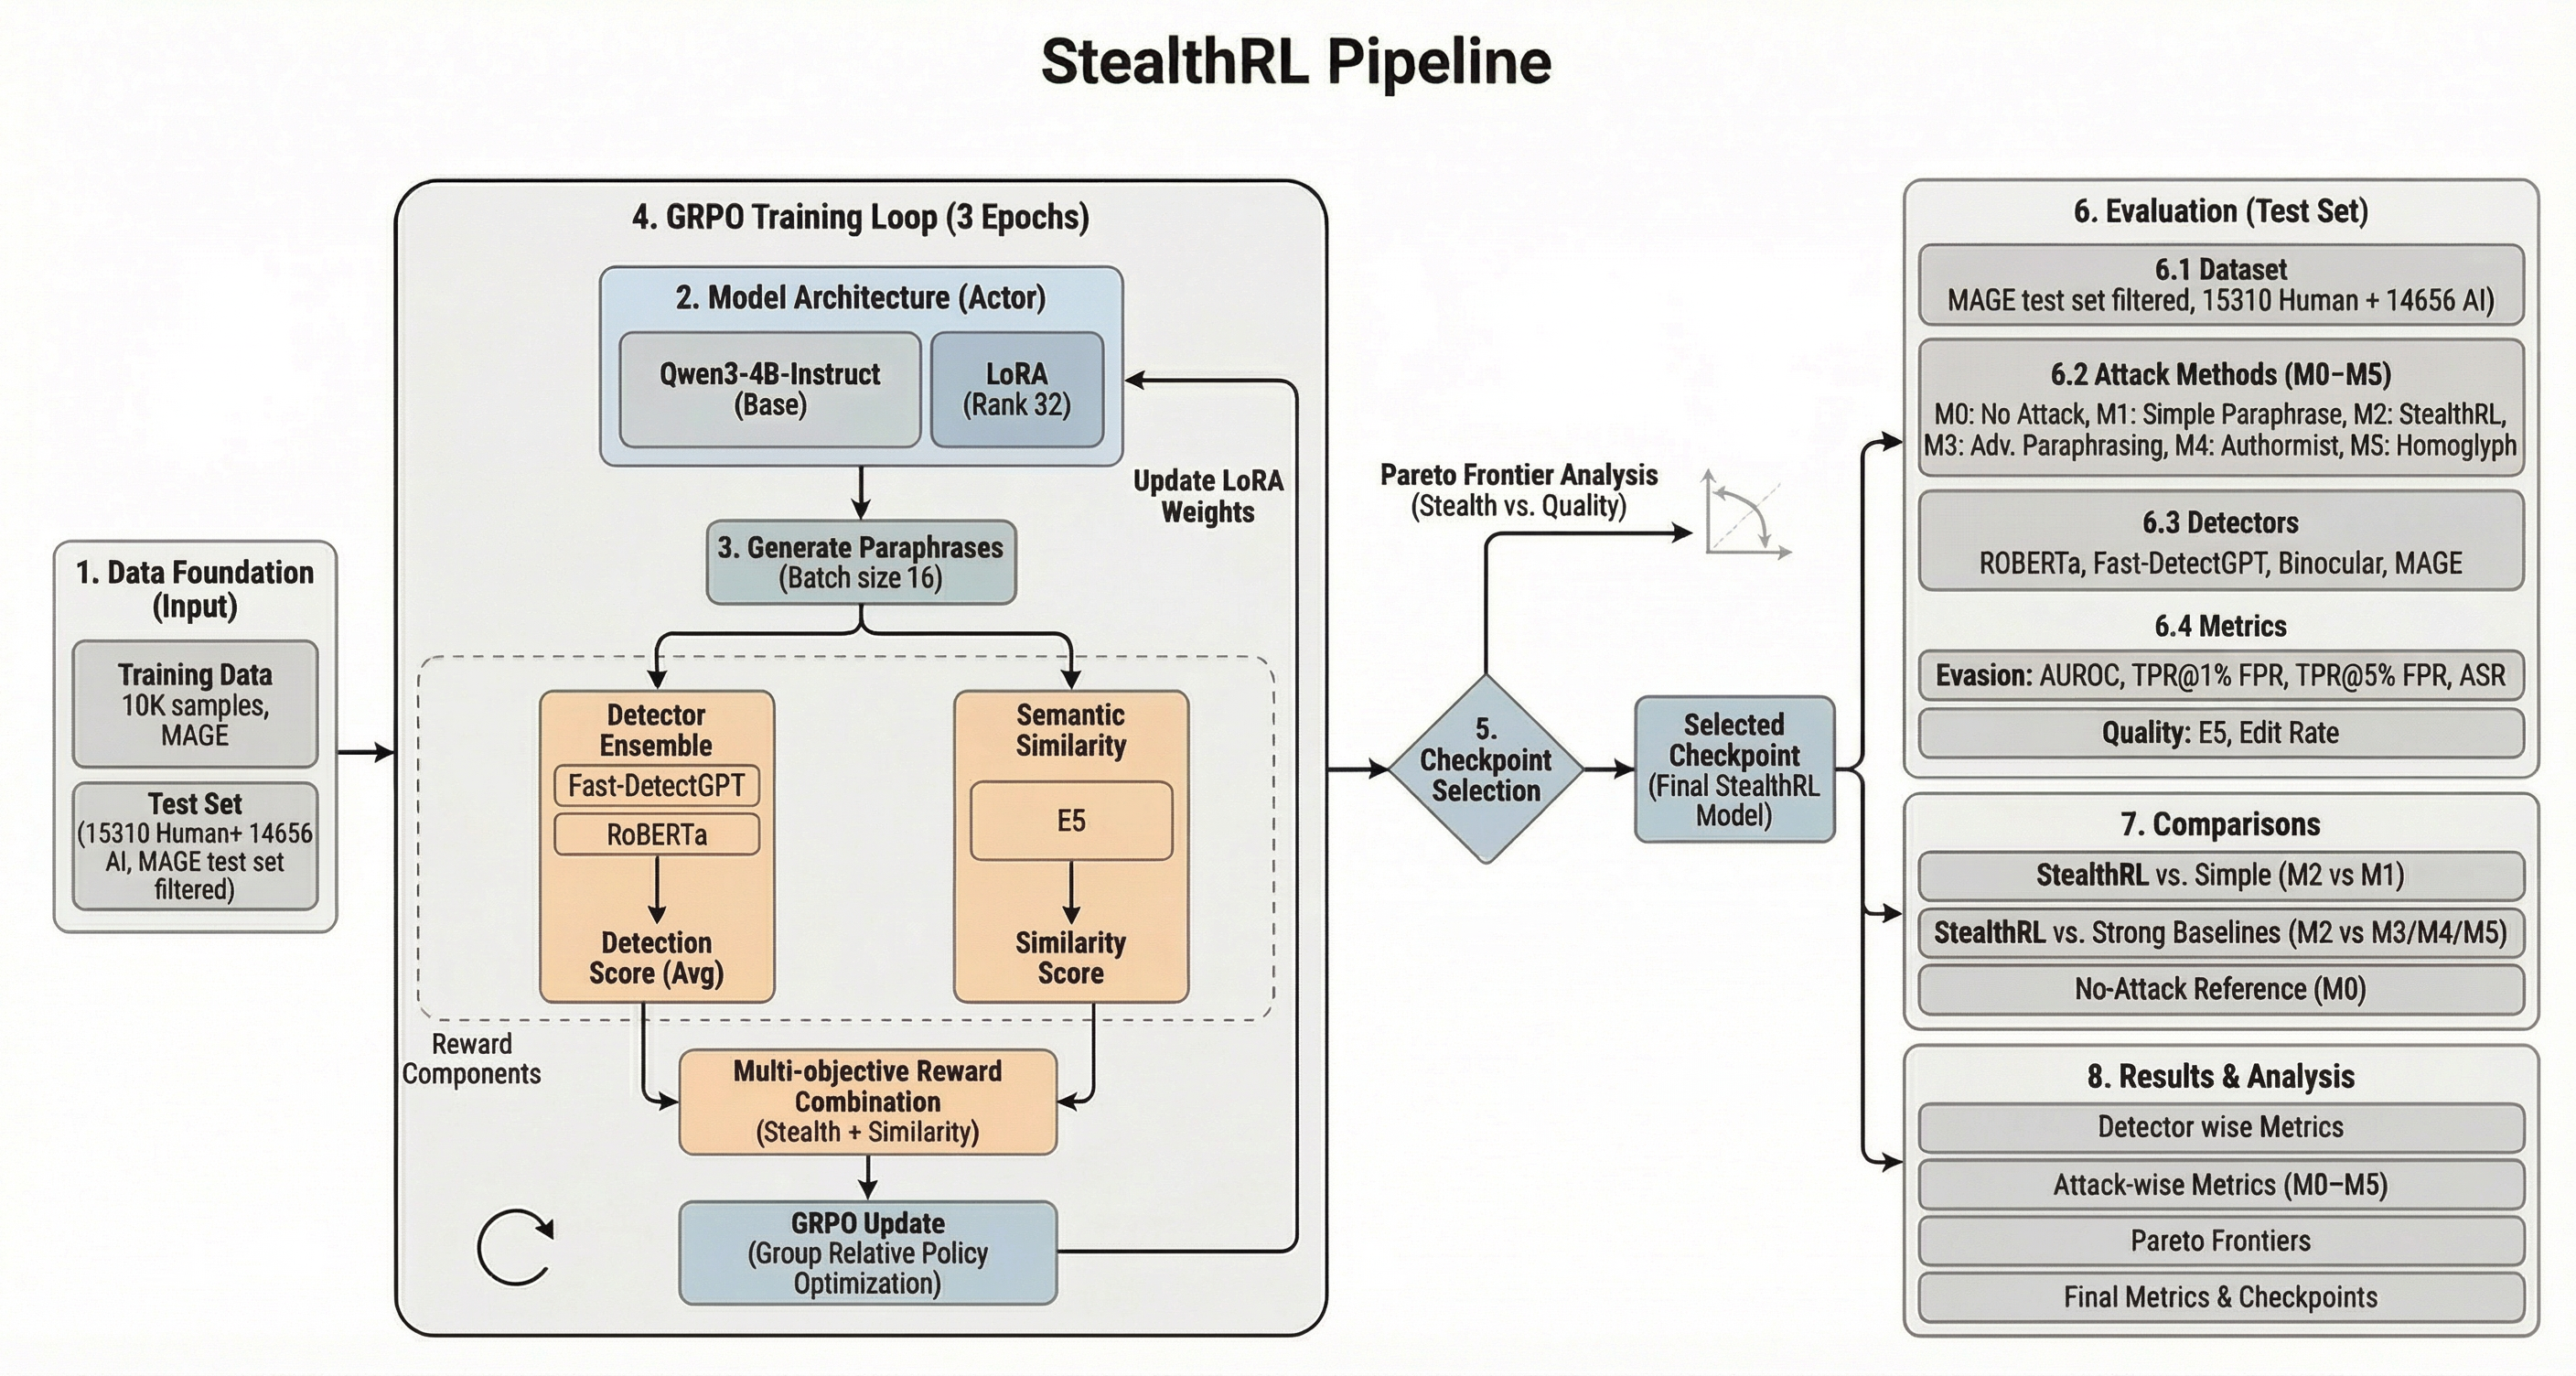
Les détecteurs de texte IA sont de plus en plus utilisés dans des contextes à forts enjeux, mais leur robustesse face à la réécriture adversarial préservant le sens reste incertaine. Nous introduisons StealthRL, un cadre d'apprentissage par renforcement pour tester la robustesse des détecteurs de texte IA avec des attaques par paraphrase adaptatives. StealthRL entraîne une politique de paraphrase contre un ensemble de détecteurs tout en préservant le contenu sémantique, puis évalue le transfert vers des familles de détecteurs non vues. Sur le pool de test MAGE complet filtré (15 310 textes humains / 14 656 textes IA), StealthRL réduit l'AUROC moyen de 0,79 à 0,43 et atteint un TPR@1%FPR moyen de 0,024 sur RoBERTa, Fast-DetectGPT, Binoculars et MAGE. L'attaque se transfère à deux détecteurs non utilisés lors de l'entraînement, exposant des vulnérabilités partagées plutôt qu'une défaillance d'un seul détecteur. Nous analysons en outre les distributions des scores des détecteurs et évaluons la qualité avec E5, BERTScore et des évaluations Likert basées sur LLM. Nos résultats montrent que les détecteurs de texte IA actuels restent fragiles sous une pression de paraphrase réaliste et fournissent un protocole reproductible pour l'évaluation de la robustesse adversarial.
Ce dépôt est la base de code de recherche et d'ingénierie derrière StealthRL. Il contient :
Ce dépôt est destiné à servir de point de départ utile aux chercheurs qui souhaitent :
stealthrl/ : code d'entraînement, wrappers de détecteurs, récompenses, utilitaires de données et le package StealthBench d'origineeval/ : harnais d'évaluation de niveau recherche utilisé pour les résultats de l'articlescripts/ : points d'entrée exécutables pour l'entraînement, l'évaluation, l'orchestration, la génération de graphiques et les utilitairesconfigs/ : configurations YAML pour l'entraînement, l'évaluation et les ablationsfigures/ : schémas du pipeline et ressources statiquestests/ : vérifications d'intégration et de cohérenceanalysis/ : aides à l'analyse ad hoc et utilitaires ponctuelspython -m venv venv
source venv/bin/activate
pip install --upgrade pip
pip install -r requirements.txt
Selon les parties du projet que vous souhaitez exécuter, vous pouvez également avoir besoin de :
pip install tinker
pip install openai
pip install vllm
Notes :
tinker est requis pour le chemin d'inférence de checkpoint StealthRL basé sur le cloud utilisé par M2.openai n'est requis que pour l'étape d'évaluation de qualité GPT/Likert.vllm est recommandé pour la génération locale rapide dans les lignes de base de l'article.Variables d'environnement typiquement utilisées par le dépôt :
export HF_HOME=$HOME/.cache/huggingface
export TRANSFORMERS_CACHE=$HF_HOME
export OPENAI_API_KEY=...
export TINKER_API_KEY=...
Pour le pipeline d'évaluation par étapes de l'article, nous avons utilisé un fichier d'environnement ainsi qu'un JSON descripteur de checkpoint. Les scripts publics vous permettent de remplacer explicitement les deux chemins :
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json
python scripts/run_eval.py --quick
python scripts/run_stealthbench.py --config configs/stealthbench.yaml
Ce script charge désormais les fichiers texte configurés, exécute les détecteurs configurés, enregistre les sorties CSV et génère des graphiques de comparaison. L'ancien stub ne contenant que des TODO a été supprimé.
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json \
  --run-root outputs/eval_runs/full_mage_public \
  --gpus 0 1 2 3
Le dépôt inclut un site de démonstration basé sur FastAPI dans demo/. Il sert une interface statique soignée et expose POST /api/paraphrase avec prise en charge de clé API ainsi qu'un quota public de 20/jour pour les utilisateurs non authentifiés.
pip install -r demo/requirements.txt
uvicorn demo.stealthrl_demo.app:app --reload --port 8080
Par défaut, la démo s'exécute en mode mock sans coût pour les tests d'interface. Pour utiliser le véritable échantillonneur StealthRL, définissez STEALTHRL_DEMO_INFERENCE_BACKEND=tinker, STEALTHRL_DEMO_CHECKPOINT_JSON et TINKER_API_KEY. Voir demo/README.md pour les notes sur la clé API, le quota, Docker et le déploiement AWS.
L'article rapporte des résultats sur le pool d'évaluation MAGE complet filtré :
Le pipeline d'évaluation de niveau recherche est implémenté dans le module eval/ ainsi que dans les scripts par étapes sous scripts/.
Préparez les informations d'identification et les métadonnées du checkpoint.
Créez un fichier d'environnement contenant OPENAI_API_KEY et TINKER_API_KEY, ainsi qu'un JSON de checkpoint décrivant le chemin de l'échantillonneur StealthRL Tinker.
Exécutez la vérification préalable (preflight).
python scripts/preflight_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json \
  --run-root outputs/eval_runs/full_mage_repro \
  --gpus 0 1 2 3
Inspectez les sorties générées des méthodes, les scores des détecteurs, les métriques et les graphiques dans le répertoire d'exécution choisi.
Si vous devez uniquement relancer l'évaluation de qualité basée sur GPT sur les sorties en cache :
python scripts/run_gpt_quality_only.py \
  --run-root outputs/eval_runs/full_mage_repro \
  --env-file ~/.config/stealthrl/eval.env
python scripts/compute_bertscore_for_run.py \
  --run-dir outputs/eval_runs/full_mage_repro/assembled \
  --device cuda:0 \
  --batch-size 16 \
  --chunk-size 512
