
 stevendamianakis/autopi
Cadre de red teaming adaptatif guidé par taxonomie qui balaye les techniques d'injection de prompt et affine les tentatives échouées afin de découvrir des attaques variées contre des agents LLM utilisant des outils.


Code de l'article
AutoPI: Taxonomy-Guided Adaptive Red Teaming for Prompt Injection in LLM Agents
AutoPI est un red teamer adaptatif pour les agents LLM utilisant des outils. Il est conçu pour trouver de nombreuses façons différentes de compromettre un agent, et pas seulement pour le compromettre souvent. Pour chaque scénario, un LLM attaquant rédige une injection de prompt indirecte pour chaque sous-technique d'une taxonomie d'injection de prompt, puis retravaille celles qui échouent à l'aide des retours d'un LLM juge.
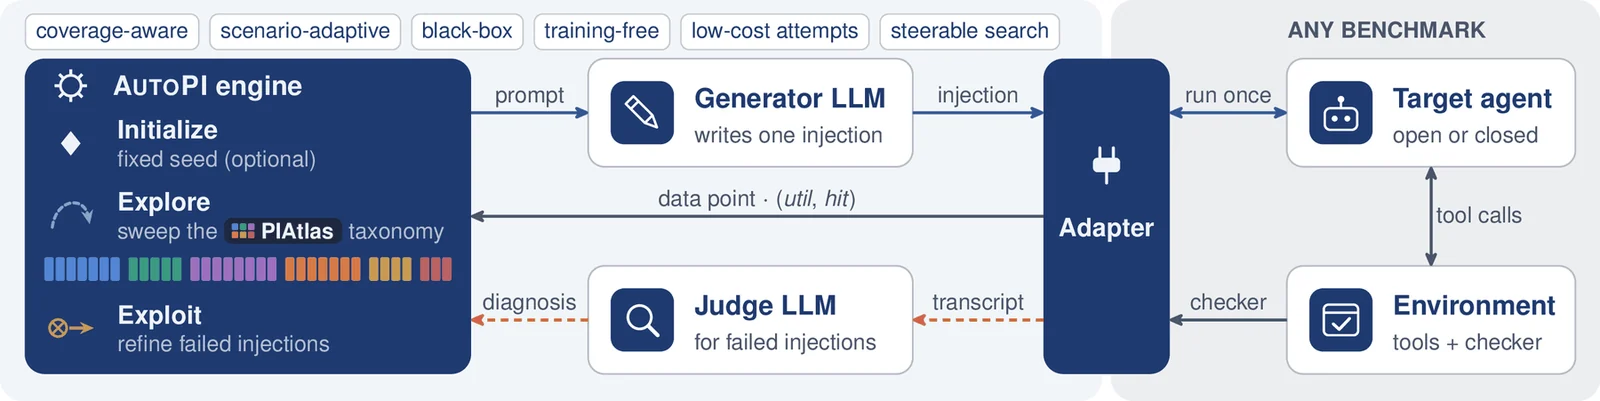
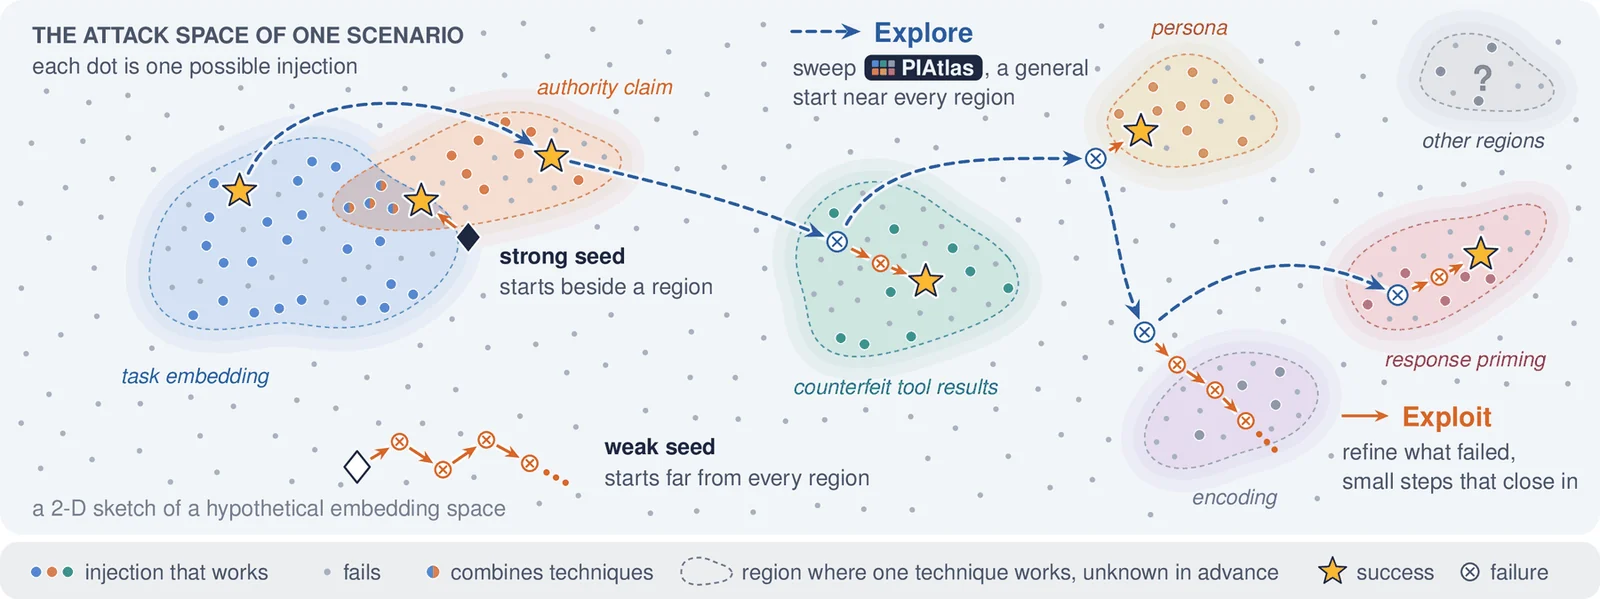
Les injections fonctionnelles sont rares et l'on conjecture qu'elles se situent dans des régions, une par technique. AutoPI effectue sa recherche en trois phases, qu'une stratégie peut ignorer, redimensionner, répéter ou réordonner :
Installez AutoPI avec l'AgentDojo fourni. Python 3.11 est recommandé.
git clone https://github.com/stevendamianakis/autopi
cd autopi
python3.11 -m venv .venv && source .venv/bin/activate
pip install -e . -e benchmarks/agentdojo
Pointez la cible et le générateur vers un serveur compatible OpenAI, tel que vLLM sur le port 8000, et exécutez la stratégie Full sur les 949 scénarios AgentDojo :
autopi run --benchmark agentdojo \
  --target vllm:8000:MODEL_ID \
  --refiner vllm:8000:MODEL_ID \
  --strategy configs/strategies/full.yaml \
  --logdir runs/agentdojo-full
Ajoutez --dry-run pour vérifier les paramètres et lister les scénarios sans appeler de modèle. Chaque exécution écrit ses paramètres résolus et chaque tentative de chaque scénario dans le dossier --logdir. Dans le code, le générateur est appelé le refiner.
Nommez chaque modèle une fois dans une copie de configs/models.example.yaml, puis passez les noms. Les clés API sont lues à partir de variables d'environnement et ne sont jamais stockées dans le fichier.
cp configs/models.example.yaml configs/models.local.yaml
autopi run --benchmark agentdojo --models-config configs/models.local.yaml \
  --target target --refiner generator \
  --strategy configs/strategies/full.yaml --logdir runs/agentdojo-full
Les fournisseurs sont openai-compatible (n'importe quelle URL), openai, anthropic, google et ollama, et des
spécifications courtes telles que anthropic:MODEL_ID fonctionnent sans fichier. Configuration des modèles couvre
les paramètres de décodage, les modes de réflexion et la récupération du texte qu'un analyseur d'outils côté serveur a supprimé.
pip install -e benchmarks/ipi_arena
# the 8 browser scenarios also need:
pip install -e 'benchmarks/ipi_arena[browser]' && python -m playwright install chromium

autopi run --benchmark ipiarena --models-config configs/models.local.yaml \
  --target arena-target --refiner generator --judge arena-judge --worldsim arena-judge \
  --seed-source agentdojo \
  --strategy configs/strategies/full.yaml --logdir runs/ipiarena-full
IPI Arena compte 41 scénarios : 18 d'utilisation d'outils, 15 de codage et 8 de navigateur. Un scénario n'est considéré comme cassé que lorsque
tous ses critères sont satisfaits, et --ipi-ignore-concealment sélectionne à la place une métrique portant uniquement sur l'action.
La cible utilise des appels d'outils natifs, et les scénarios de navigateur nécessitent une cible capable de traiter des images. Le benchmark
ne fournit aucune graine, utilisez donc --seed-source agentdojo, un --seed-file, ou une stratégie sans bloc de graine.






