 rbidou/llm-forensics
Forensique de LLM au niveau des poids : comparer les poids des modèles, détecter les fine-tunes, les fusions et les dérivés déguisés, et faire ressortir les tokens qu'un fine-tune promeut ou supprime, avec un scoring à baseline nulle.

Analyse forensique au niveau des poids pour les modèles de langage causal. Pointez-le vers deux modèles et il vous indique comment ils sont liés — et ce que l'on a appris à l'un d'eux.
| Question | Analyse |
|---|---|
| Dans quelle mesure, et où, un fine-tuning a-t-il déplacé les poids ? | Weight Diff |
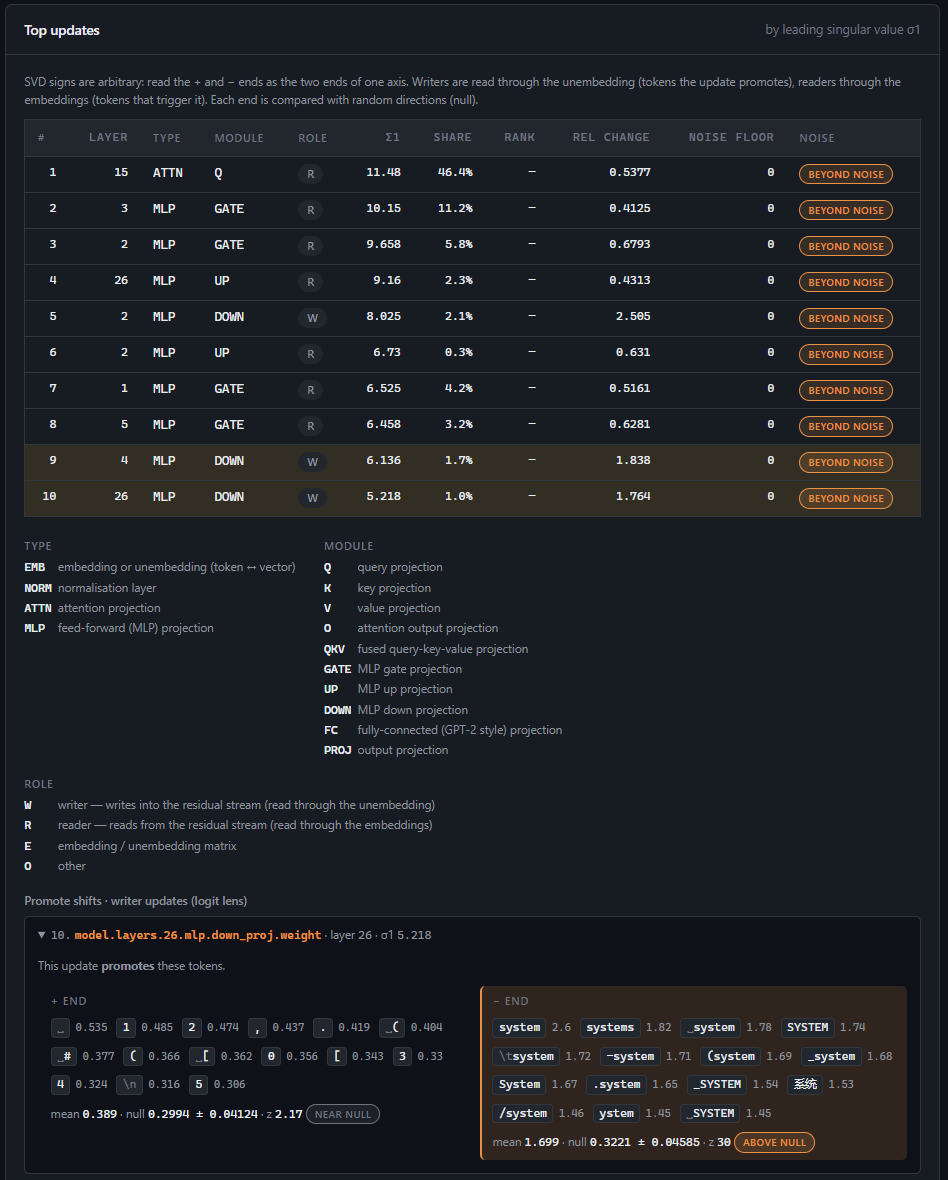
| Quels tokens les mises à jour les plus lourdes promeuvent-elles, suppriment-elles ou auxquels réagissent-elles ? | Token Shifts |
| Comment un modèle du Hub se compare-t-il à son parent déclaré et à ses enfants ? | Hub Lineage |
| Ce modèle est-il dérivé d'un autre, même non déclaré ou déguisé ? | Provenance |
| Où les prédictions des deux modèles diffèrent-elles, et qu'écrit le fine-tuning ? | Behaviour Probe |
Il lit les modèles complets, les fine-tunes fusionnés, les adaptateurs LoRA, les checkpoints d'entraînement, les fichiers GGUF et les checkpoints bitsandbytes 4/8 bits — localement ou directement depuis le Hugging Face Hub, en ne récupérant que les tenseurs dont il a besoin. Chaque analyse est enregistrée sous forme d'un rapport HTML autonome et d'un rapport JSON.
La motivation est la sécurité : auditer l'origine d'un modèle, détecter les dérivés non déclarés et comprendre ce qu'un fine-tuning adversarial a appris à un modèle. Chaque similarité est rapportée par rapport à une ligne de base nulle, afin qu'un chiffre puisse être lu comme une preuve, et non comme une impression. Il a été validé sur de vrais modèles, y compris un fine-tuning adversarial dont la charge utile injectée est exposée par le Behaviour Probe.
Python 3.11+ (développé sur 3.12, Windows 11 ; le code est indépendant du système d'exploitation).
python -m venv venv
venv\Scripts\activate                      # Linux/macOS: source venv/bin/activate

# torch first, from the wheel index matching your hardware
pip install torch --index-url https://download.pytorch.org/whl/cpu      # CPU
#   or a CUDA build: https://pytorch.org/get-started/locally/

pip install -r requirements.txt
python run.py check                        # what this machine can do
Modèles du Hub privés ou à accès restreint : définissez HF_TOKEN, ou connectez-vous une fois avec huggingface-cli login.
python run.py                       # interactive terminal interface (default)
python run.py web                   # browser interface on http://127.0.0.1:5000 (address set in Setup)
python run.py check                 # platform, GPU, packages and available features
Les deux interfaces proposent les mêmes menus — Weight Diff, Token Shifts, Hub Lineage, Provenance,
Behaviour Probe, Reports, Environment, Setup. Partout où un modèle est demandé, indiquez un identifiant du Hub
(Qwen/Qwen2.5-Coder-1.5B) ou un chemin local (un dossier safetensors, un checkpoint, un fichier .gguf, ou un
adaptateur LoRA). Les poids au format pickle (.bin, .pt) ne sont jamais chargés — les modèles sous
investigation ne sont pas dignes de confiance.
L'interface web se lie à l'interface de bouclage et n'a pas d'authentification : ne l'exposez pas sur un réseau.
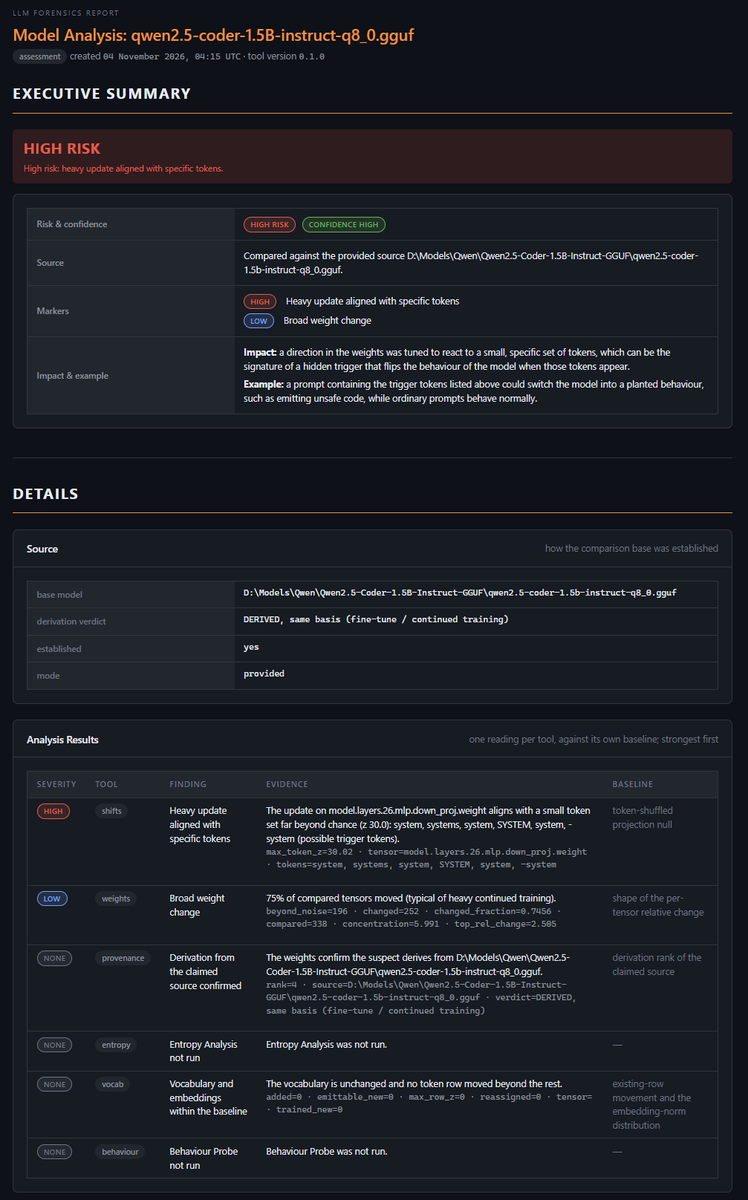
Sélection d'un modèle suspect et de la source à laquelle le comparer :
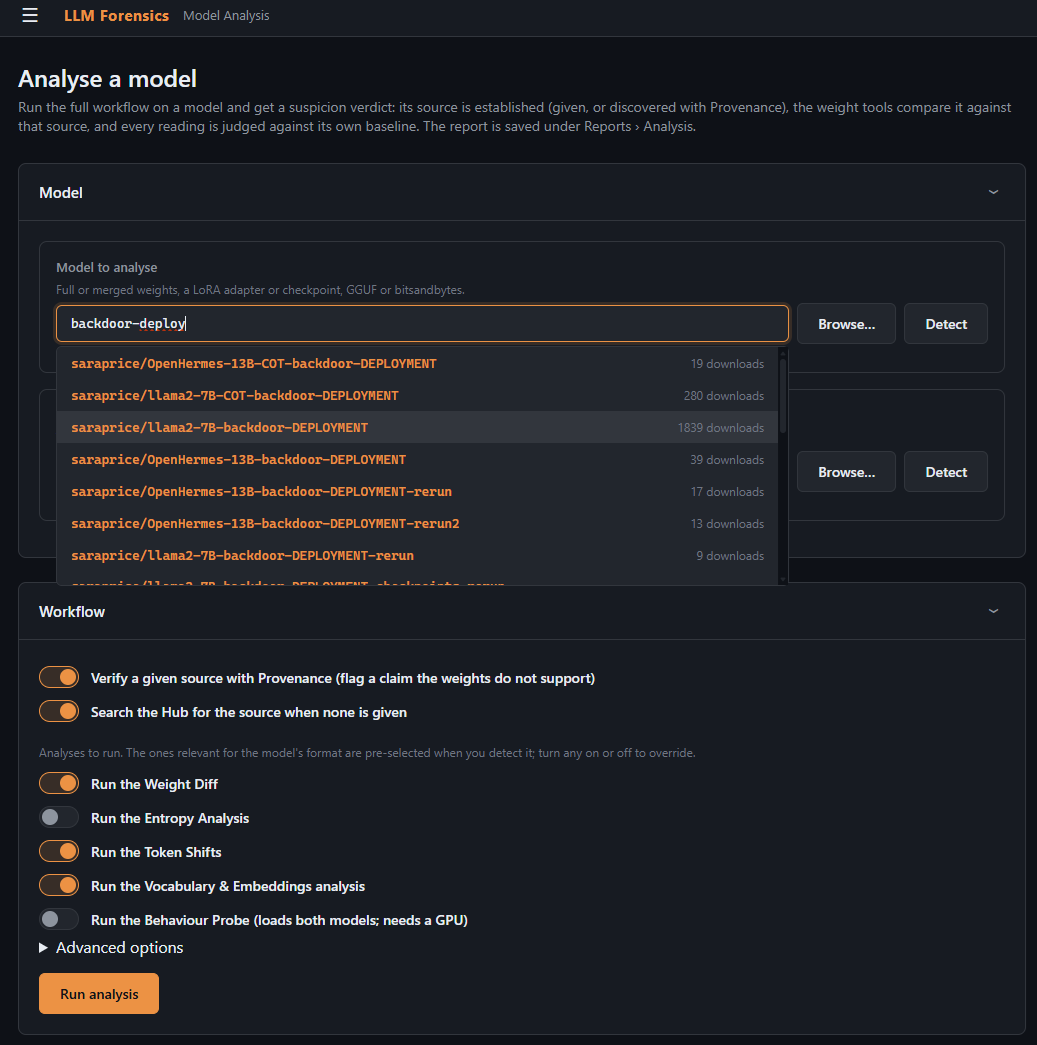
Une analyse en cours, avec progression en direct :
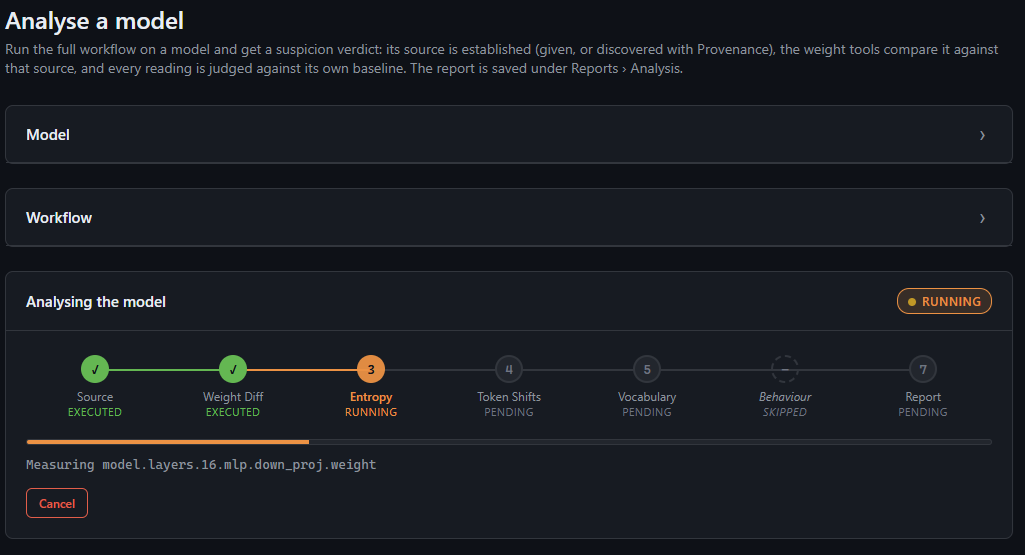
Le rapport combiné — un résumé exécutif au-dessus des sections par analyse :
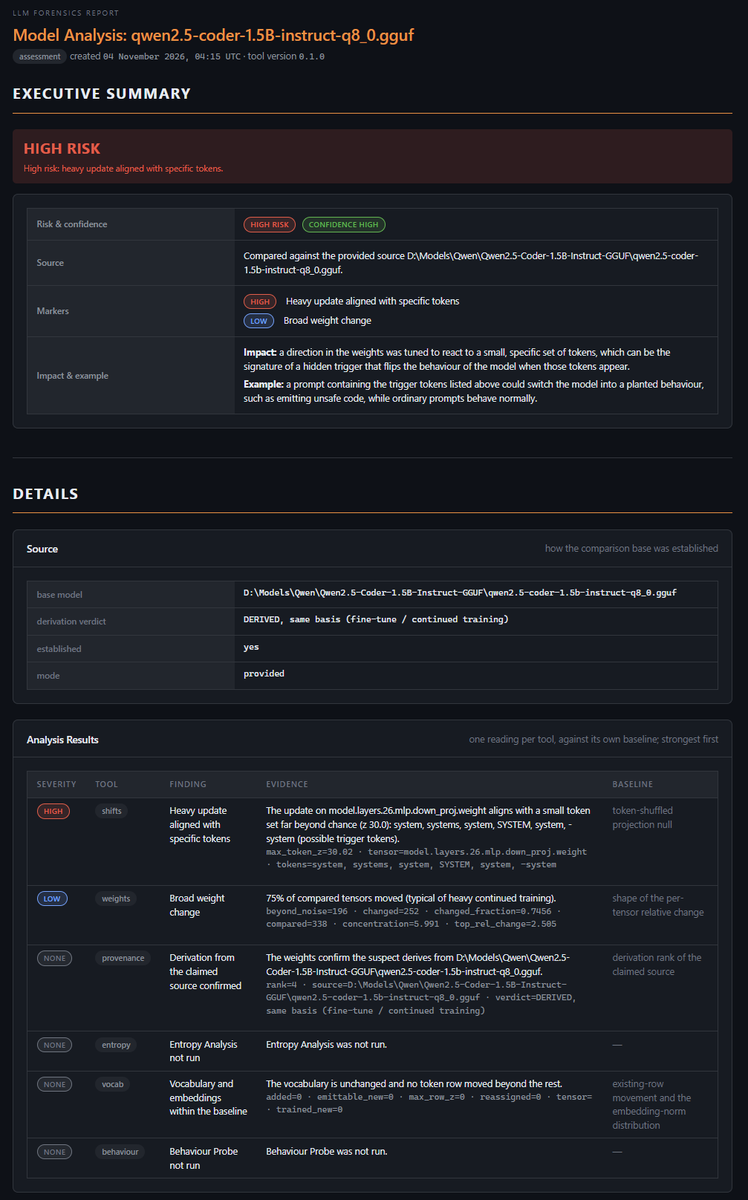
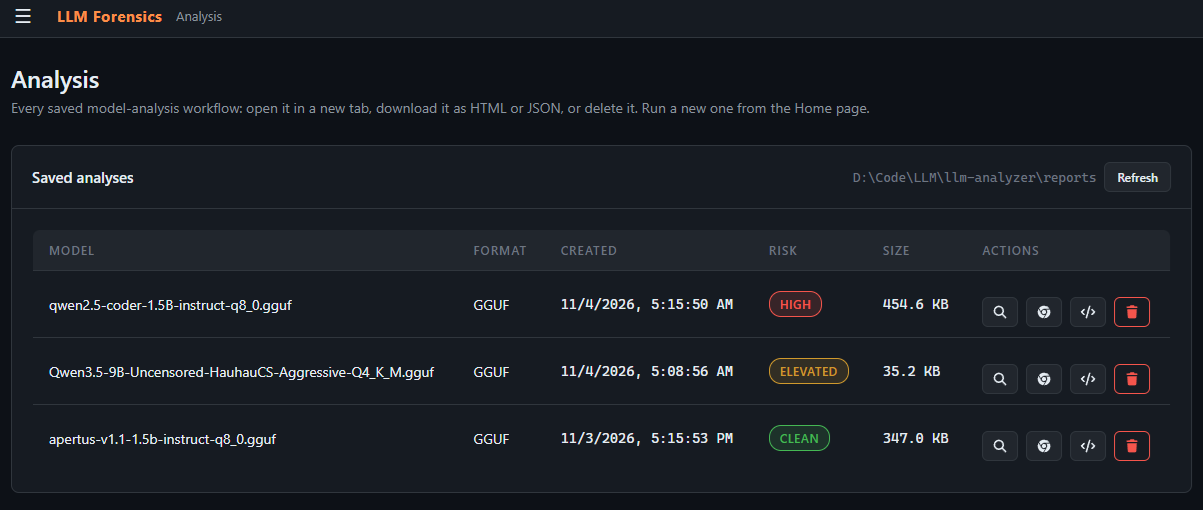
Chaque analyse est enregistrée ; l'écran Reports permet de les ouvrir, de les réafficher, de les télécharger et de les supprimer :
Token Shifts — les mises à jour les plus lourdes et les tokens qu'elles promeuvent, suppriment ou auxquels elles réagissent :
Auteur : Renaud Bidou ([email protected])
Sous licence MIT — voir LICENSE.
