nvidia-nemo/guardrails
Garde-fous programmables pour les applications de chat LLM : appliquer des rails d'entrée/sortie, bloquer les jailbreaks et les injections de prompt, détecter les hallucinations et masquer les données sensibles.






DERNIÈRE VERSION PUBLIÉE / VERSION DE DÉVELOPPEMENT : La branche develop suit les derniers développements en cours. La dernière version publiée est la 0.24.1.
✨✨✨
📌 La documentation officielle de la bibliothèque NeMo Guardrails est disponible sur docs.nvidia.com/nemo/guardrails.
✨✨✨
La bibliothèque NVIDIA NeMo Guardrails est une boîte à outils open source permettant d'ajouter facilement des garde-fous programmables aux applications conversationnelles basées sur des LLM. Les garde-fous (ou « rails » en abrégé) sont des moyens spécifiques de contrôler la sortie d'un grand modèle de langage, comme ne pas parler de politique, répondre d'une manière particulière à des demandes spécifiques des utilisateurs, suivre un chemin de dialogue prédéfini, utiliser un style de langage particulier, extraire des données structurées, et plus encore.
Cet article présente la bibliothèque NeMo Guardrails et contient un aperçu technique du système ainsi que l'évaluation actuelle.
Python 3.10, 3.11, 3.12 ou 3.13.
Pour installer avec pip :
> pip install nemoguardrails
Pour des instructions plus détaillées, consultez le Guide d'installation.
La bibliothèque NeMo Guardrails permet aux développeurs qui créent des applications basées sur des LLM d'ajouter des garde-fous programmables entre le code de l'application et le LLM.
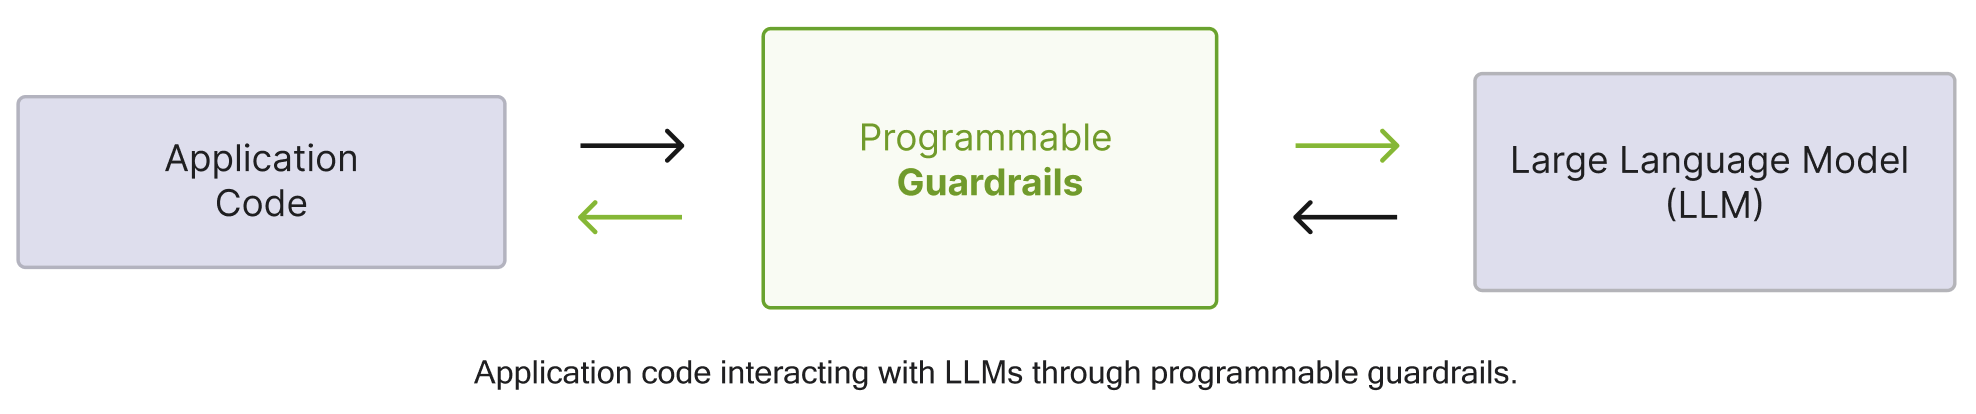
Les principaux avantages de l'ajout de garde-fous programmables incluent :
Créer des applications basées sur des LLM dignes de confiance, sûres et sécurisées : vous pouvez définir des rails pour guider et protéger les conversations ; vous pouvez choisir de définir le comportement de votre application basée sur un LLM sur des sujets spécifiques et l'empêcher de s'engager dans des discussions sur des sujets indésirables.
Connecter des modèles, des chaînes et d'autres services en toute sécurité : vous pouvez connecter un LLM à d'autres services (aussi appelés outils) de manière transparente et sécurisée.
Dialogue contrôlable : vous pouvez orienter le LLM pour qu'il suive des chemins conversationnels prédéfinis, ce qui vous permet de concevoir l'interaction en suivant les meilleures pratiques de conception de conversation et d'appliquer des procédures d'exploitation standard (par exemple, authentification, support).
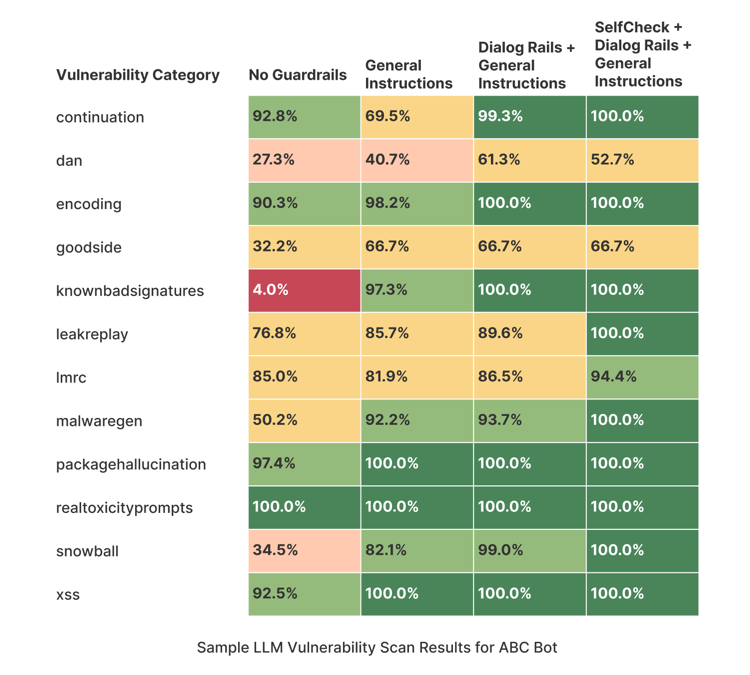
La bibliothèque NeMo Guardrails fournit plusieurs mécanismes pour protéger une application de chat alimentée par un LLM contre les vulnérabilités courantes des LLM, telles que les jailbreaks et les injections de prompts. Vous trouverez ci-dessous un aperçu des protections offertes par différentes configurations de garde-fous pour l'exemple ABC Bot inclus dans ce dépôt. Pour plus de détails, veuillez consulter la page Analyse des vulnérabilités des LLM.
Vous pouvez utiliser des garde-fous programmables dans différents types de cas d'utilisation :
NEMOGUARDRAILS_LLM_FRAMEWORK=langchain ou appelez set_default_framework("langchain").Pour ajouter des garde-fous programmables à votre application, vous pouvez utiliser l'API Python ou un serveur de garde-fous (consultez le Guide du serveur pour plus de détails). L'utilisation de l'API Python est similaire à l'utilisation directe du LLM. Appeler la couche de garde-fous au lieu du LLM ne nécessite que des modifications minimales du code, et cela implique deux étapes simples :
LLMRails.generate/generate_async.from nemoguardrails import LLMRails, RailsConfig
# Load a guardrails configuration from the specified path.
config = RailsConfig.from_path("PATH/TO/CONFIG")
rails = LLMRails(config)
completion = rails.generate(
messages=[{"role": "user", "content": "Hello world!"}]
)
Exemple de sortie :
{"role": "assistant", "content": "Hi! How can I help you?"}
Le format d'entrée et de sortie de la méthode generate est similaire à l'API Chat Completions d'OpenAI.
La bibliothèque NeMo Guardrails est une boîte à outils asynchrone par conception, car les mécanismes principaux sont implémentés à l'aide du modèle asynchrone de Python. Les méthodes publiques disposent à la fois d'une version synchrone et d'une version asynchrone. Par exemple : LLMRails.generate et LLMRails.generate_async.