
Skip to content
KitploitKITPLOIT
OutilsExploitsBlog
Log in
Soumettre
OutilsExploitsBlog
Soumettre

Outils de Hacking, PenTest et Cybersécurité pour votre Arsenal de Sécurité !

Kitploit est un répertoire d'outils de hacking, de cybersécurité et de pentesting. Découvrez les dernières mises à jour des projets pour trouver des vulnérabilités, analyser des systèmes, automatiser les tests et renforcer votre sécurité.

FluxContactConfidentialité© 2026 Kitploit

Répertoire d'outils

Catégories

Voir toutes les catégories
Loading categories
ColonelClustered — Un plugin Burp Java qui effectue un clustering de texte sur les réponses afin d'identifier les valeurs aberrantes/groupes en fonction du contenu réel des réponses du serveur, par exemple à partir d'une exécution d'Intruder. | Kitploit
Outils/GitHubGitHub/hoodoer/colonelclustered
Analyse des VulnérabilitésProxies Web et InterceptionExploitation d'Applications WebSécurité WebFuzzingTests d'IntrusionUtilitaires et FrameworksApprentissage Automatique
GitHubhoodoer/colonelclustered

ColonelClustered

Un plugin Burp Java qui effectue un clustering de texte sur les réponses afin d'identifier les valeurs aberrantes/groupes en fonction du contenu réel des réponses du serveur, par exemple à partir d'une exécution d'Intruder.

12115il y a 1 moisPas encore vérifié
Voir le dépôt

Populaires

Voir tout →

Découvrez les outils les plus utilisés par notre communauté.

Explorer tous les outils

Parcourez notre collection d'outils

Voir tous les outils →
Partager

Colonel Clustered - Clustering par similarité de réponses (v1.0.1)

Une extension Burp Suite pour regrouper les réponses HTTP afin d'identifier les valeurs aberrantes.

Intro

Voici un plugin que j'envisage de développer depuis de nombreuses années, simplement parce que je suis modérément agacé par la façon dont nous analysons les résultats des attaques de fuzzing dans Burp Intruder. Nous cherchons généralement des changements dans les réponses du serveur lors de nos attaques de fuzzing. Et nous recherchons ces différences en examinant les codes de statut, le temps de réponse et la taille des réponses. Tous ces éléments sont des mesures indirectes du contenu de la réponse. Bien sûr, en tant que pentesters, nous n'avons pas le temps de lire le contenu de milliers de serveurs pour rechercher des différences dans le contenu des réponses. Mais nous pouvons certainement confier cette tâche à des algorithmes.

C'est là que ce plugin entre en jeu. Il utilise des techniques de clustering de texte pour analyser le contenu des réponses et les regrouper en clusters en fonction de leur similarité. Cela vous offre une autre façon de visualiser les résultats de vos attaques de fuzzing Intruder et d'identifier rapidement les réponses du serveur qui sont différentes.

Comment ça fonctionne

Colonel Clustered propose deux algorithmes différents pour effectuer le clustering des réponses. L'algorithme par défaut est relativement rapide, avec un algorithme optionnel d'analyse approfondie qui excelle dans la détection des valeurs aberrantes, mais qui ne passe pas bien à l'échelle. Enfin, aucun des deux ne passe bien à l'échelle, j'hésiterais à soumettre 50 000 réponses à ce plugin. L'algorithme rapide/par défaut a une complexité O(n^2), tandis que l'algorithme d'analyse approfondie est en O(n^3). Gardez donc cela à l'esprit lorsque vous lui envoyez des résultats Intruder à traiter.

  1. Tokenisation sensible au contenu : L'extension inspecte d'abord l'en-tête Content-Type de chaque réponse pour appliquer la stratégie de tokenisation la plus intelligente :

    • HTML : Supprime toutes les balises et scripts, puis génère des 5-grammes basés sur les caractères du texte visible. Cela inclut la sanitisation des chiffres pour garantir la résilience aux variations mineures (comme les ID) dans le contenu templatisé.
    • JSON : Extrait toutes les clés et leurs chemins imbriqués comme tokens, en ignorant les valeurs. Pour les tableaux, il analyse la structure de tous les objets contenus.
    • Texte : Génère des 5-grammes basés sur les caractères du contenu en texte brut, en sanitissant également les chiffres pour la résilience aux templates.
    • Binaire/Autre : Si le contenu n'est pas textuel, il génère un ensemble de n-grammes de 5 octets pour trouver des similarités dans les données binaires.
  2. Pré-regroupement : Pour rester rapide même avec des milliers de réponses, l'extension effectue une seule passe pour regrouper toutes les réponses parfaitement identiques. Elle calcule un hash de l'ensemble de tokens de chaque réponse et regroupe tous les éléments partageant le même hash. Cela signifie que l'algorithme de clustering coûteux ne s'exécute que sur l'ensemble beaucoup plus restreint des corps de réponse uniques.

  3. Algorithmes de clustering doubles : Colonel Clustered propose deux algorithmes de clustering distincts :

    • Fast Scan (par défaut) : Un algorithme basé sur DBSCAN à hautes performances s'exécute automatiquement lorsque vous envoyez plusieurs requêtes/réponses à l'extension.

      • Réglage automatique de l'epsilon : Il utilise l'algorithme Kneedle pour déterminer automatiquement l'epsilon optimal (rayon de densité), en s'adaptant aux caractéristiques du jeu de données.
      • Détection des valeurs aberrantes (minPts=2) : minPts est fixé à 2, ce qui le rend très efficace pour identifier les réponses uniques ou ne partageant une similarité qu'avec un seul autre élément, garantissant une détection sensible des valeurs aberrantes.
    • Deep Analysis (déclenchement manuel) : L'algorithme original de clustering hiérarchique, plus gourmand en calcul, est disponible via un bouton « Deep Analysis ». Cette option est conçue pour les scénarios nécessitant une perspective de clustering plus granulaire et potentiellement différente, en utilisant le lien moyen (Average Linkage) pour une meilleure cohésion des clusters.

      • Il construit une matrice de similarité en utilisant la distance de Jaccard entre les réponses uniques.
      • Il fusionne itérativement les clusters les plus similaires, en enregistrant les distances de fusion pour déterminer les seuils optimaux.
  4. Consolidation des valeurs aberrantes : Après le clustering, tout groupe résultant ne contenant qu'un seul membre unique est considéré comme une valeur aberrante. Toutes ces valeurs aberrantes sont ensuite consolidées dans un seul groupe pratique « Outliers » dans l'interface.

Ces deux algorithmes devraient offrir un moyen simple d'identifier automatiquement les réponses du serveur qui diffèrent par leur contenu, même lorsque la taille de la réponse est une mesure peu fiable des différences entre réponses.

Comment l'utiliser

  1. Charger l'extension :

    • Allez dans l'onglet Extensions de Burp Suite.
    • Cliquez sur Add et sélectionnez le fichier ColonelClustered.jar.
    • Un nouvel onglet nommé « Col. Clustered » devrait apparaître.
    • Remarque : J'espère pouvoir le proposer bientôt dans le BAPP store, je mettrai à jour le README s'il est accepté.
  2. Envoyer des réponses pour analyse :

    • Allez dans n'importe quel outil de Burp, comme les résultats d'Intruder ou l'historique du Proxy.
    • Sélectionnez un ou plusieurs éléments requête/réponse.
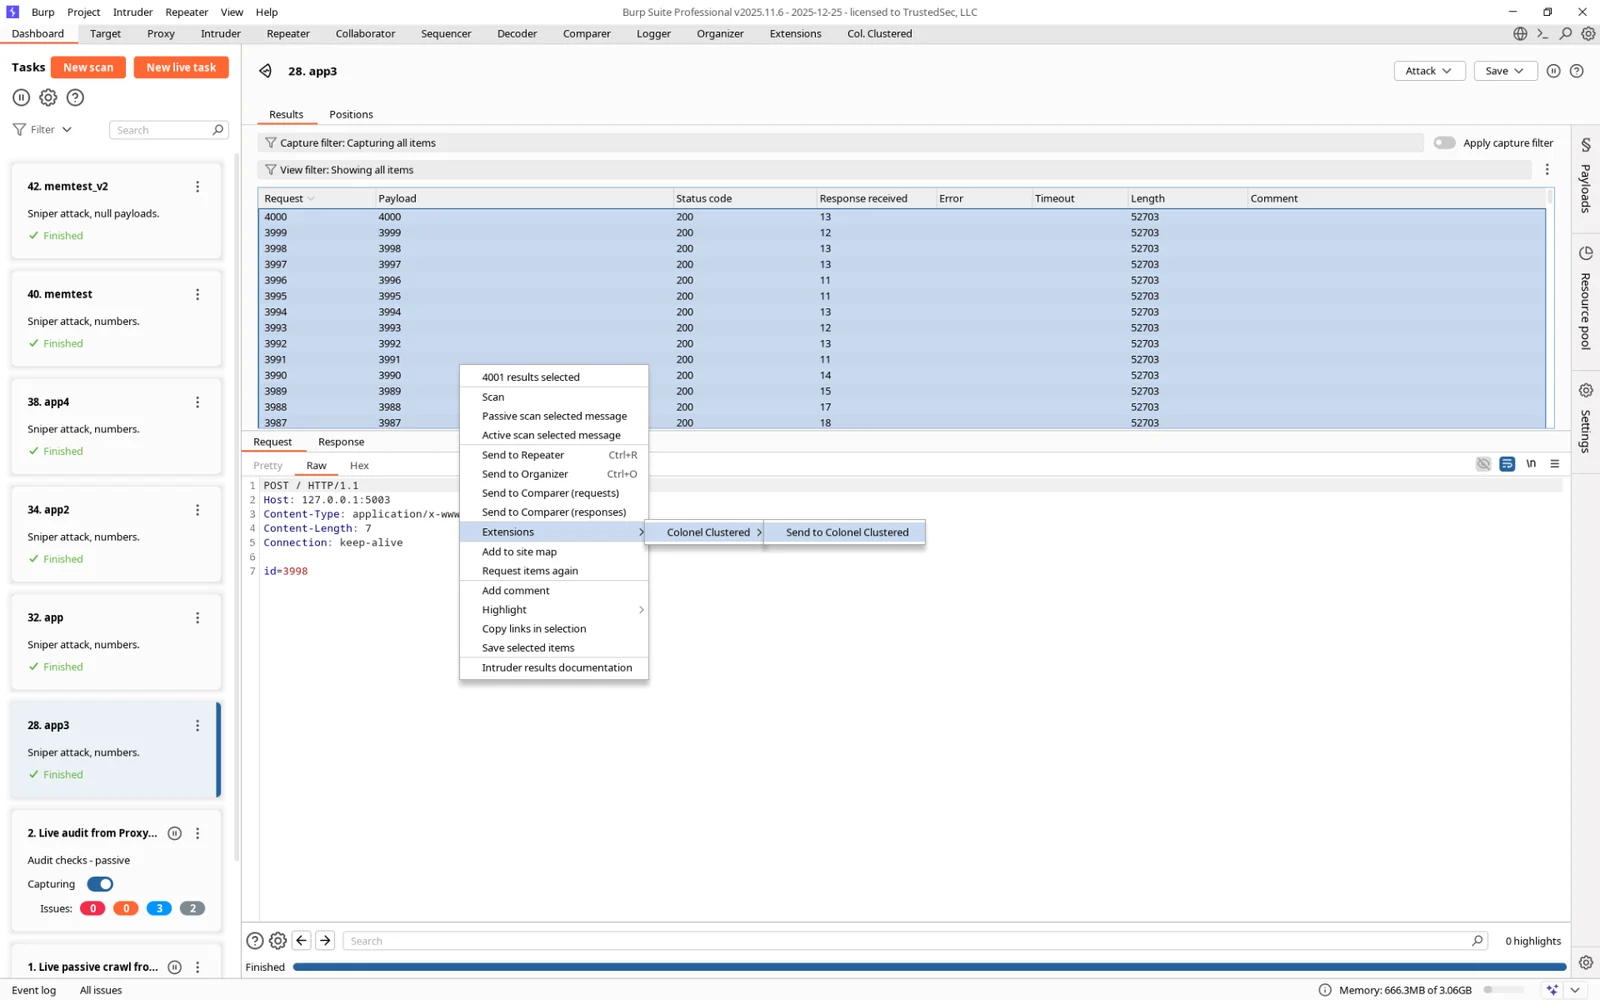
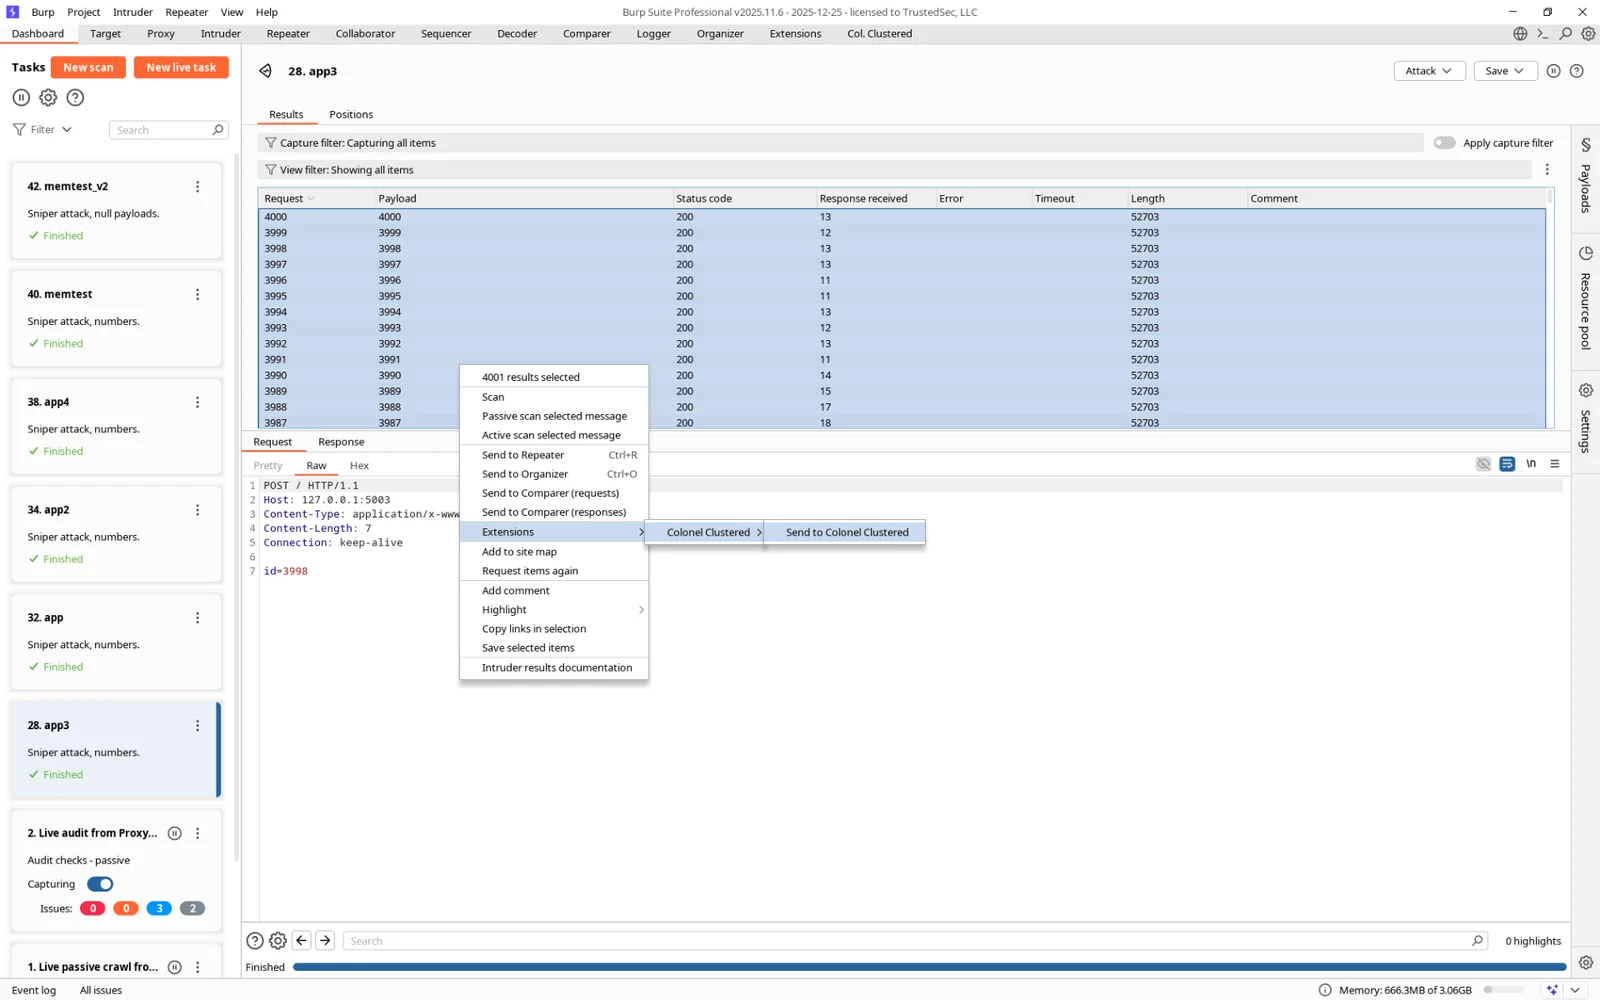
    • Faites un clic droit et sélectionnez « Send to Colonel Clustered ».
    • Un Fast Scan par défaut démarrera automatiquement, et une barre de progression apparaîtra pour suivre l'analyse.
  3. Effectuer une Deep Analysis (facultatif) :

    • Si un clustering hiérarchique plus détaillé est souhaité, cliquez sur le bouton « Deep Analysis ».
    • Remarque : Si vous analysez un grand nombre d'éléments, un avertissement concernant d'éventuels problèmes de performance apparaîtra avant le début de l'analyse.
    • Une barre de progression apparaîtra, vous permettant de suivre l'analyse.
  4. Analyser les résultats dans l'interface à quatre volets :

    • L'onglet « Colonel Clustered » utilise une disposition à quatre volets pour vous aider à naviguer rapidement dans les résultats.
    • En haut à gauche (Clusters) : Ce volet affiche les clusters trouvés, y compris un groupe spécial « Outliers ». Chaque entrée indique le nombre d'éléments dans ce cluster.
    • En bas à gauche (Membres du cluster) : Sélectionnez un cluster dans le volet ci-dessus pour voir tous ses membres affichés dans ce tableau. Le tableau comporte plusieurs colonnes :
      • Request/Response Pair : L'index d'origine de l'élément.
      • Status Code : Le code de statut de la réponse HTTP.
      • Length : La longueur du corps de la réponse en octets.
      • Content-Type : L'en-tête Content-Type de la réponse.
    • Tri : Cliquez sur n'importe quel en-tête de colonne du tableau pour trier les éléments au sein de ce cluster, ce qui vous permet de trouver facilement les réponses les plus grandes/petites, ou de regrouper par code de statut.
    • En haut à droite et en bas à droite (Visionneuses) : Sélectionnez n'importe quelle ligne du tableau pour afficher sa requête et sa réponse complètes dans les visionneuses à droite.

Captures d'écran

image
Télécharger l’outil