 es0j/execaslr-ekoparty
Exploit de preuve de concept qui contourne l'ASLR sur les processeurs Intel en abusant du Branch Target Buffer et de l'exécution spéculative pour divulguer des adresses randomisées via un canal auxiliaire.

L'Address Space Layout Randomization est une mitigation utilisée pour rendre plus difficile l'exploitation des attaques par corruption mémoire. Dans un scénario de vulnérabilité de débordement de tampon, par exemple, un attaquant qui tente de monter une exploitation par Return Oriented Programming a besoin de connaître les adresses des gadgets de la chaîne. Si le segment de code du binaire exploité est randomisé, il est alors beaucoup plus difficile pour un attaquant de choisir la bonne adresse pour l'exploitation, rendant celle-ci irréalisable.
L'exemple suivant montre comment une adresse est randomisée :
#include <stdio.h>
void DoNothing();
void (*codePtr)() = DoNothing;

void DoNothing(){}

int main(int argc,char **argv){

    printf("Destination %p\n",codePtr);
    DoNothing();
}
À chaque exécution, la valeur est randomisée :
Destination 0x563714256149
Destination 0x556d8e2f1149
Destination 0x5618c8bdd149
Destination 0x55ee623b0149
Les 12 derniers bits 149 sont toujours les mêmes, mais la fonction peut se trouver à peu près n'importe où entre 0x550000000000 et 0x570000000000, ce qui signifie que 29 bits sont randomisés, occupant un espace d'adressage possible de 0x200 0000 0000 ou 2,2 To.
Le traitement de chaque instruction est une tâche complexe. Certaines étapes du traitement d'une seule instruction sont :
Afin d'augmenter le débit d'instructions du CPU, chaque tâche de l'instruction est effectuée par une unité spécifique du processeur. Avec toutes les unités travaillant en parallèle, le CPU peut fonctionner à des fréquences d'horloge bien plus élevées ; c'est l'idée du pipeline.
| Opération \ cycle d'horloge | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| Extraction | A | B | C | ||
| Décodage | A | B | C | ||
| Exécution | A | B | C |
Exécution des instructions A, B et C sur les cycles 1 à 5. Au cycle 3, par exemple, les unités d'extraction, de décodage et d'exécution sont simultanément actives
Cependant, les instructions ne sont pas complètement indépendantes les unes des autres. Par exemple, la séquence suivante :
A. add ax,[bx]
B. jz $+1
C. mov dl,[rsi]
D. nop
Dans ce cas, l'instruction A, dans le meilleur des cas, ne se terminera qu'au cycle 3 en exécution. Cependant, l'unité d'extraction doit décider quelle est la prochaine instruction à charger depuis la mémoire, à savoir si l'instruction C (mov dl,[rsi]) doit être ignorée.
Dans ce scénario, le CPU a la possibilité d'attendre la fin de l'instruction A, qui n'aura lieu qu'au troisième cycle d'horloge, pour ensuite charger la bonne instruction en mémoire, si par exemple l'opération add retourne 0 :
| Opération \ cycle d'horloge | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Extraction | A | B | D | |||
| Décodage | A | B | D | |||
| Exécution | A | B | D |
Ceci implique un retard dans le pipeline, car le CPU doit attendre que l'instruction soit exécutée. Dans cet exemple, le retard est d'un seul cycle d'horloge, mais l'instruction add ax,[bx] nécessite une opération mémoire qui, comme vu précédemment, peut prendre jusqu'à des centaines de cycles pour se terminer, engendrant ainsi un coût de performance significatif sur le processeur.
Une option plus rapide consisterait à essayer de « deviner » le bon chemin d'exécution. Le CPU peut spéculer sur la prise ou non de la branche. Après ce point, l'exécution continue sur le chemin spéculé et les valeurs ne sont validées que si le chemin s'avère correct après la fin de l'instruction A. Si le chemin s'avère incorrect, les résultats sont rejetés et l'état est restauré à celui d'avant le point de spéculation.
| Opération \ cycle d'horloge | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Extraction | A | B | (S) C | |||
| Décodage | A | B | (S) C | |||
| Exécution | A | B | (S) C |
Le seul problème lors de l'annulation du chemin emprunté est que l'état microarchitectural du CPU ne peut pas être restauré. Ainsi, si le CPU spécule pour exécuter l'instruction C (mov dl,[rsi]), les données pointées par rsi seront déplacées dans le cache. Cet effet peut être mesuré ultérieurement à l'aide d'une attaque par canal auxiliaire (side channel).
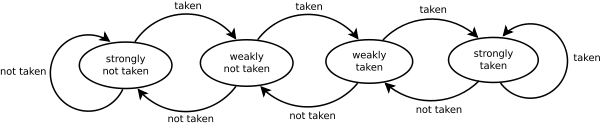
Prédicteur conditionnel à 2 bits. https://en.wikipedia.org/wiki/Branch_predictor
Non seulement les instructions conditionnelles doivent être prédites, mais aussi les branchements indirects. Le CPU doit disposer d'un mécanisme pour deviner les destinations d'une instruction telle que call [rdi].
La vulnérabilité Spectre v2 montre qu'il est possible d'exploiter le prédicteur indirect pour obtenir une exécution transitoire dans d'autres processus :
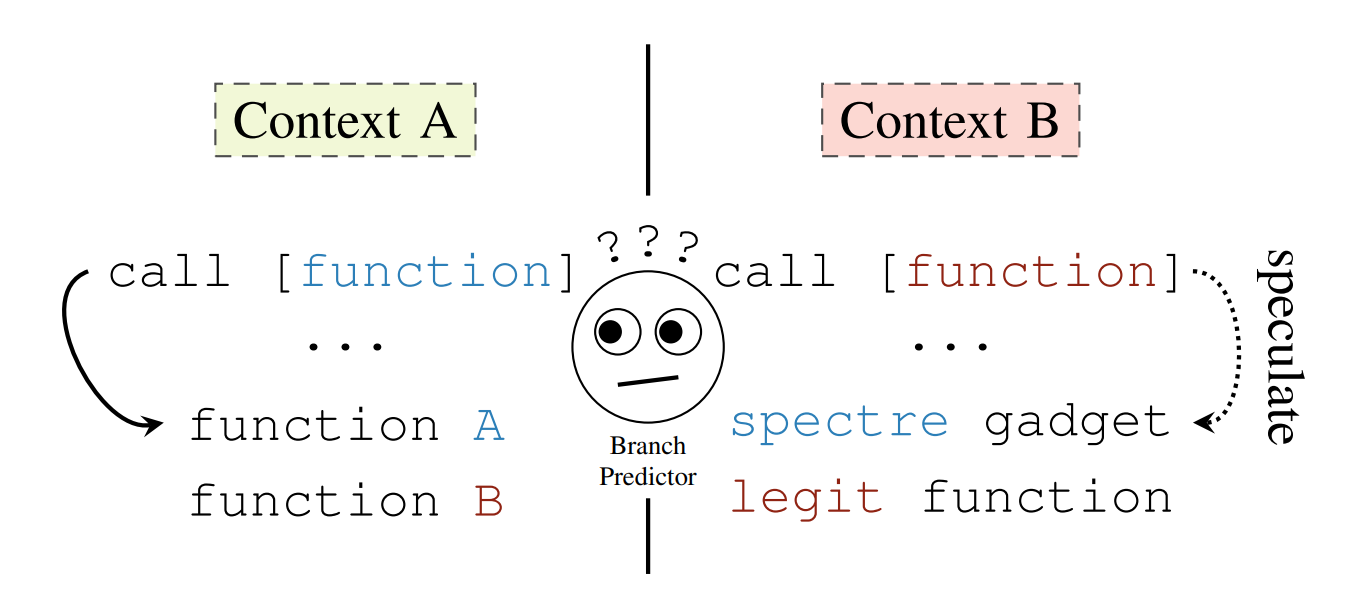 Extrait de https://spectreattack.com/spectre.pdf
En plaçant une instruction call dans le contexte A à la même adresse virtuelle qu'un autre call du contexte B, l'attaquant peut entraîner le CPU à exécuter du code à une position choisie par l'attaquant dans le contexte B, dans une attaque par réutilisation de code, similaire au Return Oriented Programming (ROP).
La victime ciblée doit disposer d'un morceau de code connu sous le nom de « spectre gadget » capable de fuiter un secret à l'aide d'une attaque par canal auxiliaire. Pour qu'une attaque Spectre réussisse, l'attaquant doit également connaître l'emplacement du spectre gadget. Par conséquent, dans les attaques utilisateur-utilisateur, protéger la victime avec l'ASLR était une mitigation pour ce type d'attaque. Cependant, il existe aussi des techniques pour extraire l'ASLR à l'aide d'attaques microarchitecturales comme Jump Over ASLR. Néanmoins, cette technique présente certaines limites quant à la quantité de bits divulgués, car elle repose sur une collision dans le prédicteur direct pour contourner l'ASLR.
Les mécanismes internes de ce prédicteur sont présentés ci-dessous :
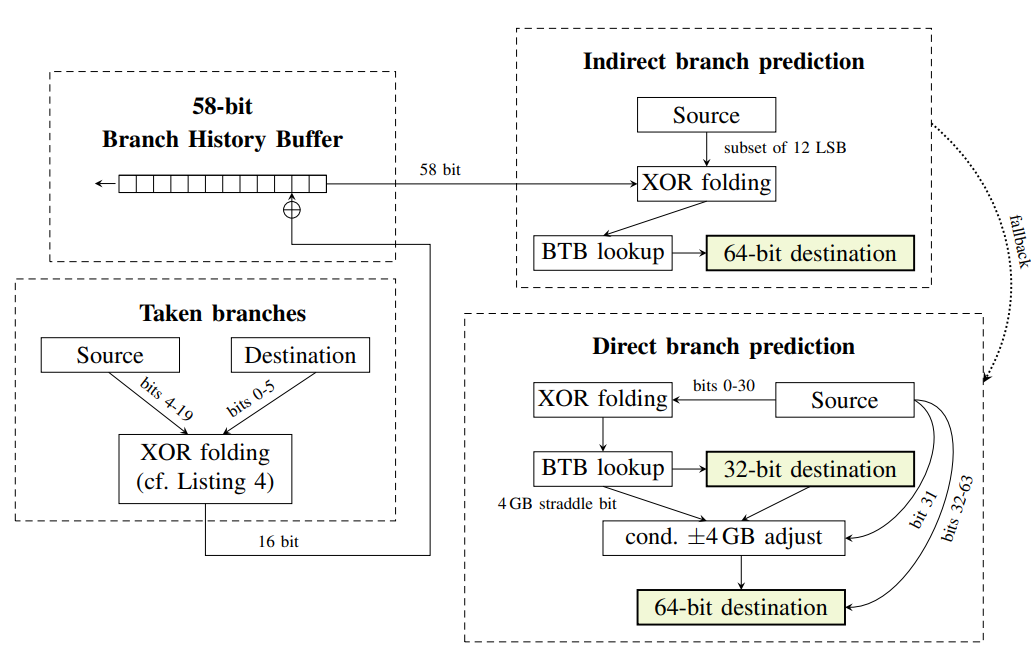
Extrait de https://spectreattack.com/spectre.pdf
Certains de ces composants sont :
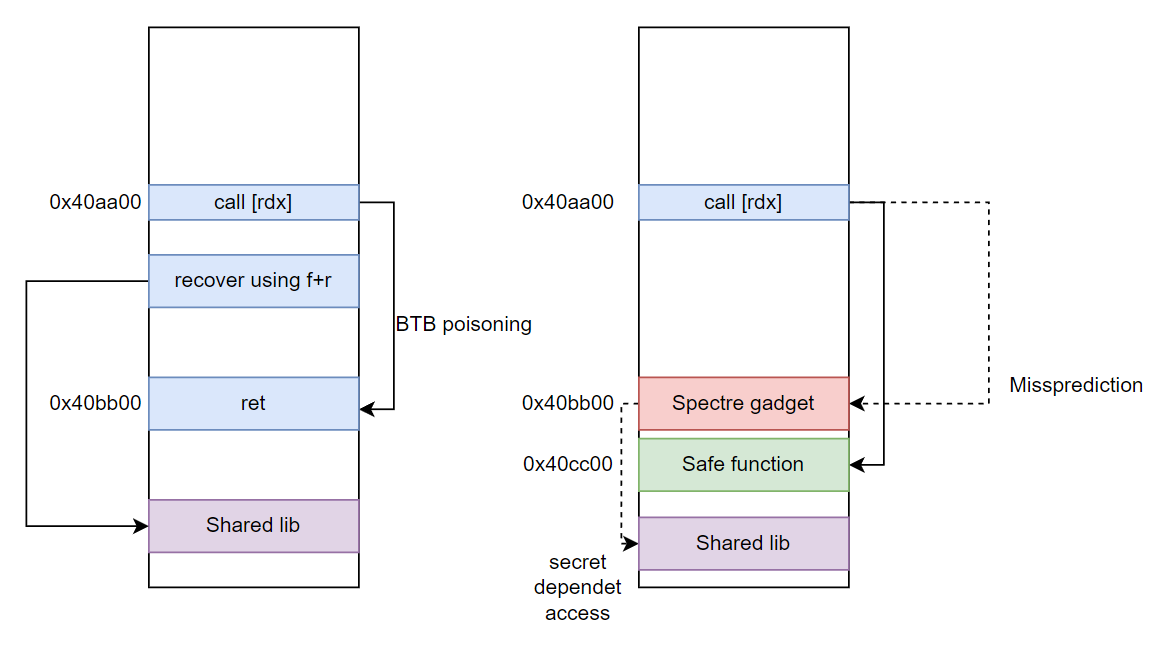
La configuration classique d'une attaque Spectre v2 ressemble à ceci :
