 d-diaa/swordstamp
Filigrane sémantique avec détection robuste à l’ordre sur des unités sous-phrastiques

SwordStamp ajoute une détection robuste à l'ordre et des unités de portée sémantique aux filigranes sémantiques basés sur les embeddings. Cet artefact contient la configuration exacte de l'article, le code de génération et de détection, la suite d'attaques inchangée, l'évaluation de la qualité, ainsi que l'extraction déterministe des résultats et le tracé des graphiques.
Article : Semantic Watermarking with Order-Robust Detection over Sub-sentence Units (arXiv:2608.27666)
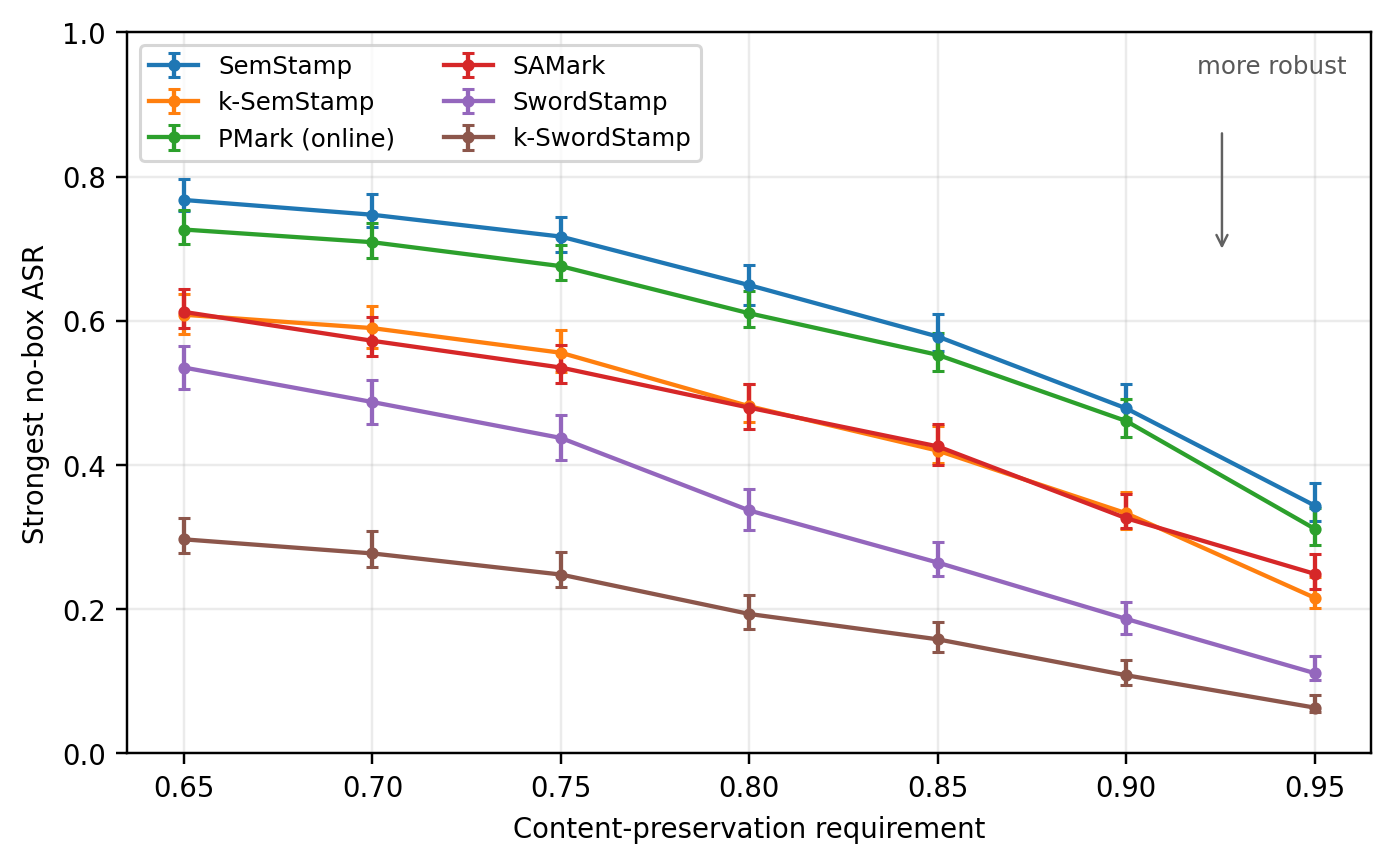
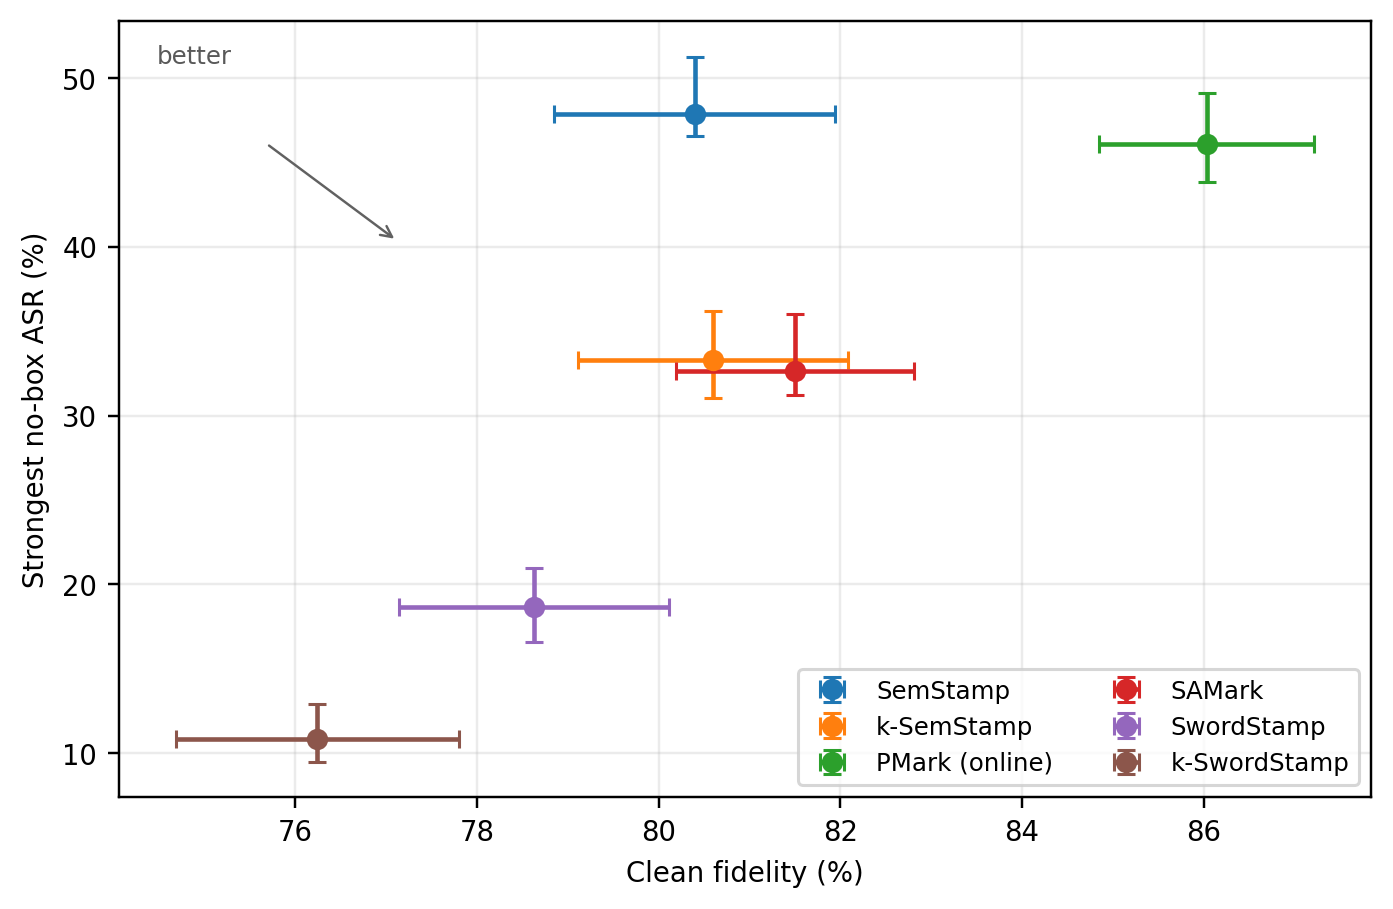
À un taux de faux positifs de 5 % et une exigence de préservation du contenu de 90 %, l'attaque par déplacement d'embedding spécifique au schéma (EDA-S) atteint :
| Filigrane | Taux de réussite de l'attaque EDA-S |
|---|---|
| SemStamp | 47,9 % |
| k-SemStamp | 33,3 % |
| PMark | 46,1 % |
| SAMark | 32,6 % |
| SwordStamp | 18,7 % |
| k-SwordStamp | 10,8 % |
Par rapport à leurs références publiées, SwordStamp et k-SwordStamp réduisent la réussite d'EDA-S de 29,2 et 22,5 points de pourcentage, pour des coûts de fidélité en conditions propres de 1,8 et 4,4 points. Leurs taux de détection en conditions propres sont de 94,9 % et 97,0 %. Sous le test de résistance plus fort EDA-D avec accès au détecteur, la réussite maximale conditionnée par la qualité est de 39,7 % sur k-SwordStamp contre 65,5 % sur k-SemStamp.
Ces résultats couvrent des continuations d'actualités en anglais, un modèle de fournisseur, deux encodeurs de fournisseur, et une paire paraphraseur/surrogate EDA.
visualization ne consomme que le bundle compilé CSV/Parquet. Il échoue en cas de cellules manquantes de l'article plutôt que de dessiner une figure partielle.
uv sync --frozen --only-group plot --no-install-project
uv run --no-sync python -m visualization extract \
  --bundle results/paper --output results/paper
uv run --no-sync python -m visualization render \
  --bundle results/paper --output results/paper
Cela écrit des tables auditables sous results/paper/tables/ et sept figures en
PNG et PDF sous results/paper/figures/. La branche de révision anonyme inclut
le bundle compilé ; une exécution complète sur la branche de release crée les mêmes fichiers
avec python -m visualization compile.
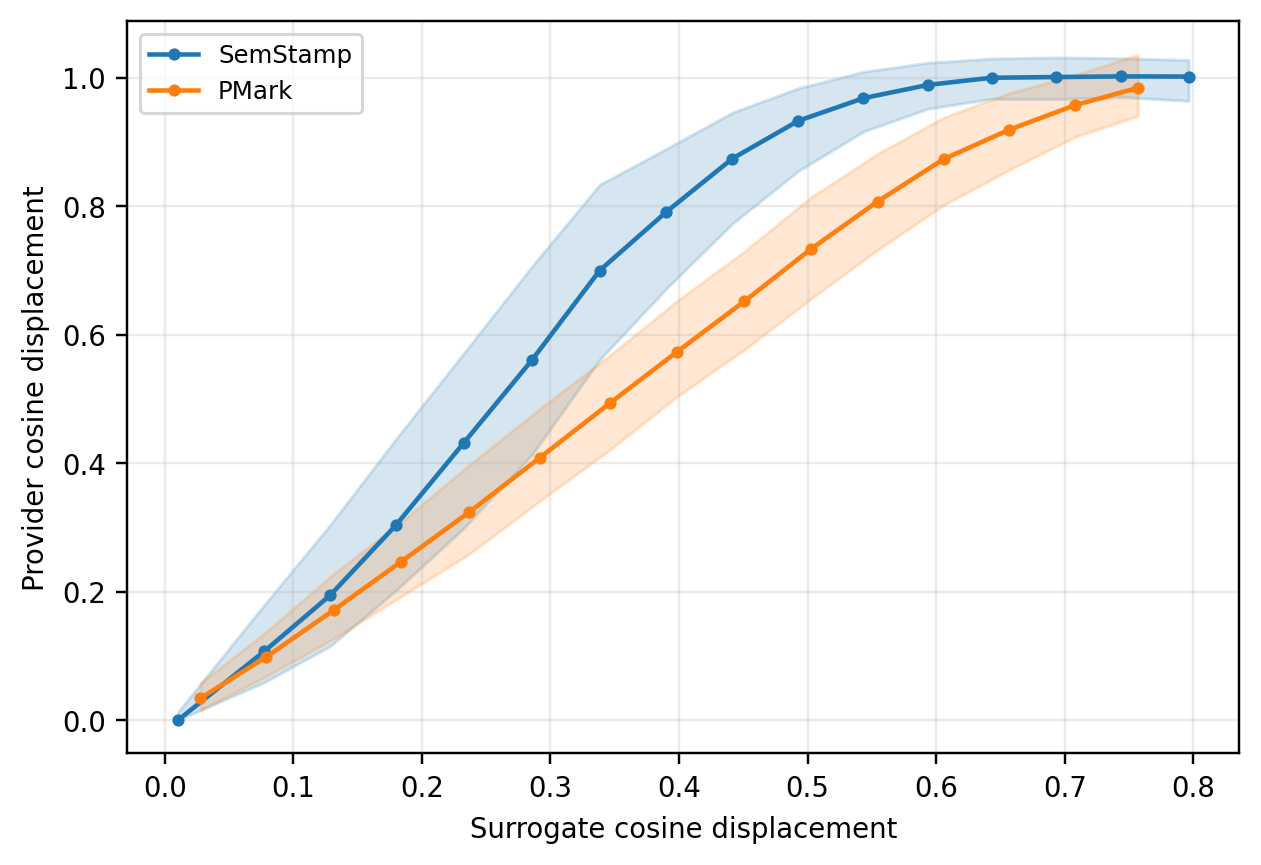
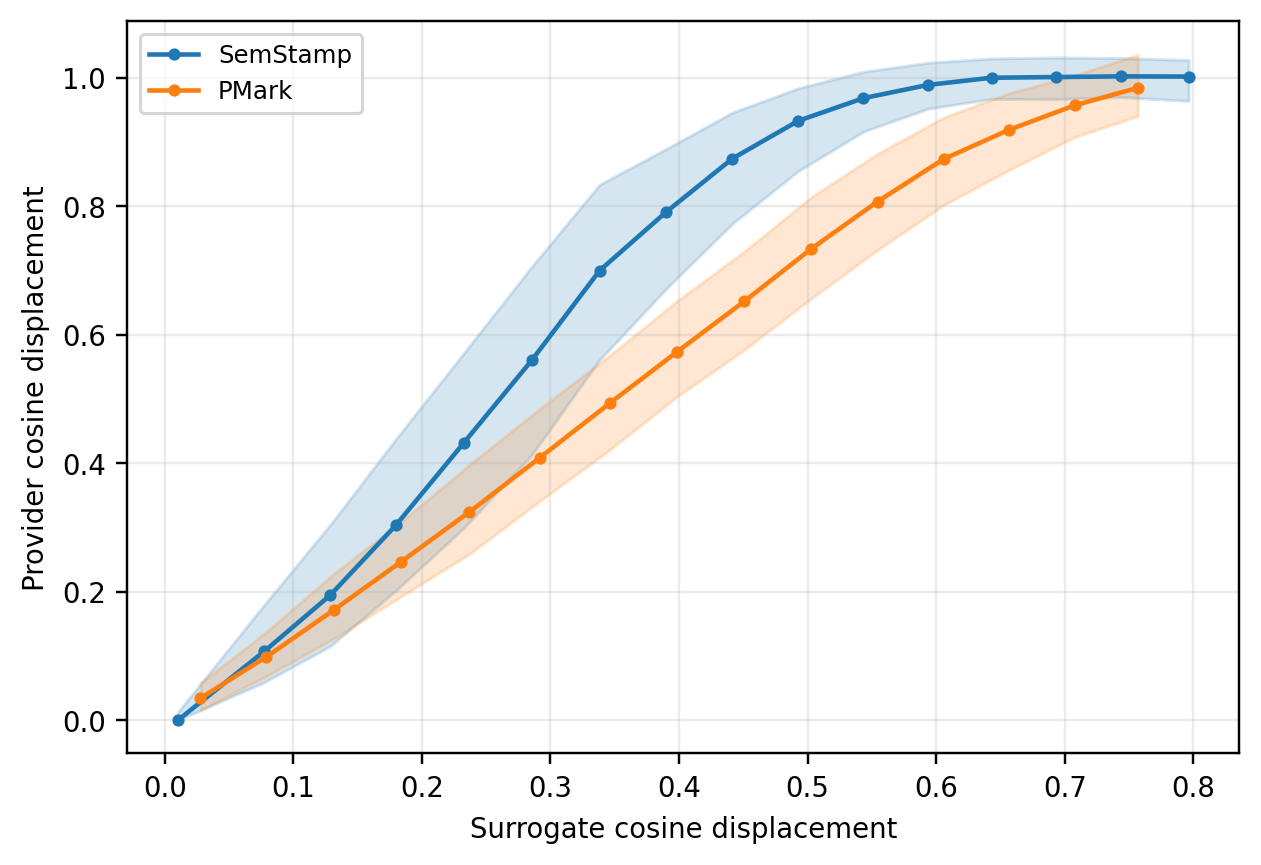
L'attaque par déplacement d'embedding (EDA) est une attaque adaptative de paraphrase
de texte intégral. À chaque unité de sortie, elle
échantillonne K continuations et conserve le candidat présentant le plus grand déplacement
cosinus par rapport à son ancre source sous un encodeur substitut. Comme chaque
candidat poursuit le préfixe de réécriture complet, un seul objectif peut reformuler le contenu,
le réordonner et scinder ou fusionner les unités du détecteur.
L'EDA no-box voit le texte marqué et la conception publique du watermark. Elle n'interroge ni le détecteur ni le générateur et ne reçoit aucune clé secrète, aucun encodeur de fournisseur, ni oracle de qualité.
| Variante | Ancre et unité | Configuration |
|---|---|---|
| EDA-P | phrase positionnelle | adaptive, anchor=positional, unité de l'attaquant sentence |
| EDA-S | conception publique de la cible | phrases positionnelles pour SemStamp, k-SemStamp et PMark ; bag/sentence pour SAMark ; bag/semspan pour les deux variantes de SwordStamp |
| EDA-D | détecteur du fournisseur | oracle ; hérite de l'encodeur, de la partition et de la segmentation du défenseur |
Pour l'ancrage par bag, l'article utilise attack.bag_agg=min : maximiser la distance par rapport
à l'ancre source la plus proche. Les exécutions no-box rapportées utilisent
Qwen/Qwen2.5-3B-Instruct, BAAI/bge-base-en-v1.5,
K={1,2,4,8,16,32,64}, une température de 1.0, top-p 0.95, au plus 96 tokens par
candidat, et au plus 512 tokens de réécriture.
D'autres concepteurs de watermark peuvent appeler EDA directement :
from attacks.paraphrasing.adaptive import adaptive_attack_paraphrase

attacked = adaptive_attack_paraphrase(
    texts,
    base_model="Qwen/Qwen2.5-3B-Instruct",
    surrogate_model="BAAI/bge-base-en-v1.5",
    num_candidates=32,
    anchor="positional",       # EDA-P; use "bag" for an order-robust design
    bag_agg="min",
    segmentation_type="sentence",
    segmentation_backend="nltk",
)
Pour l'EDA-S de l'article, compatible avec SwordStamp, définissez anchor="bag",
segmentation_type="semspan", semcut_max_words=15 et
semcut_window=5. Dans ce dépôt, l'équivalent en CLI est :
uv run python -m attacks DATA_PATH --config PRESET \
  --set attack.paraphraser=adaptive \
  --set attack.custom_model=Qwen/Qwen2.5-3B-Instruct \
  --set attack.surrogate_model=BAAI/bge-base-en-v1.5 \
  --set attack.num_candidates=32 \
  --set attack.anchor=bag --set attack.bag_agg=min \
  --set segmentation.attacker_type=semspan \
  --set segmentation.attacker_backend=nltk
DATA_PATH est toujours le corpus de base et PRESET identifie la cellule
marquée. Voir attacks/README.md pour toutes les attaques conservées et les champs de configuration.
config/paper.py est l'unique source de vérité. Pour chacun de LSH et k-means,
scripts/experiments/swordstamp.sh exécute cette échelle additive à cinq niveaux avec 64
candidats fournisseurs :
La grille ne contient que ces dix cellules et une référence sans filigrane. PMark est
en ligne uniquement ; SAMark utilise un motif de drapeau par exécution. Les budgets EDA-D sont
K={4,8,16,32,64}.
Les sous-modules de comparaison adaptent les sources d'évaluation publiques PMark et SAMark uniquement à leurs frontières de jeux de données/résultats et à la calibration partagée des faux positifs ; les algorithmes de filigrane sont inchangés.
Les prérequis sont Git, uv, Python 3.11, CUDA pour les exécutions de modèles, l'accès aux révisions de modèles épinglées, et un stockage temporaire.
git clone --recurse-submodules [email protected]:D-Diaa/SwordStamp.git
cd SwordStamp
bash scripts/setup.sh
uv run --frozen python scripts/check_artifact.py
Préparer les partitions C4 déterministes et disjointes :
uv run --frozen python scripts/prepare_c4.py --output-dir data
Installez et configurez le planificateur épinglé. L'installateur affiche ses effets de bord au niveau utilisateur avant de modifier quoi que ce soit :
bash scripts/install_gpu_scheduler.sh --print-plan
bash scripts/install_gpu_scheduler.sh --yes
gpu-scheduler init --gpus 0,1
gpu-scheduler start
Prévisualisez, puis soumettez chaque shard physique :
