 comerc/cve-2025-68664
Divulgation détaillée de CVE-2025-68664, une vulnérabilité critique de désérialisation dans LangChain core permettant l'exfiltration de secrets et une éventuelle exécution de code à distance (RCE) via des invites et des flux de sérialisation conçus à cet effet.

Auteur : Yarden Porat
Recherche Cyata : la vulnérabilité LangGrinch dans LangChain
Publié : https://cyata.ai/blog/langgrinch-langchain-core-cve-2025-68664/
Hier, LangChain a publié un avertissement critique concernant une vulnérabilité que j'ai découverte dans langchain-core : CVE-2025-68664 / GHSA-c67j-w6g6-q2cm.
Plus tôt cette année, mes recherches se sont concentrées sur le contournement des gestionnaires de secrets dans nos travaux « Vault Fault » – des systèmes conçus spécifiquement comme une frontière de sécurité autour de vos informations d'identification les plus sensibles. Une conclusion revenait sans cesse : lorsqu'une plateforme traite accidentellement des données façonnées par un attaquant comme une structure de confiance, cette frontière s'effondre rapidement. Cette fois, le système qui « se brise » n'est pas votre gestionnaire de secrets. C'est le framework d'agents qui peut les utiliser.
Pourquoi cette vulnérabilité mérite une attention particulière :
Elle se trouve dans le noyau. Ce n'est pas un bug d'un outil spécifique, ni un cas limite d'intégration, ni « un package communautaire qui a fait quelque chose d'étrange ». Les API vulnérables (dumps() / dumpd()) se trouvent dans langchain-core lui-même.
Le rayon d'impact est énorme. En termes de téléchargements, langchain est l'un des composants de framework d'IA les plus largement déployés au monde aujourd'hui. À la fin décembre 2025, la télémétrie publique des packages montre des centaines de millions d'installations, pepy.tech rapportant ~847 millions de téléchargements au total et pypistats affichant ~98 millions de téléchargements au cours du dernier mois.
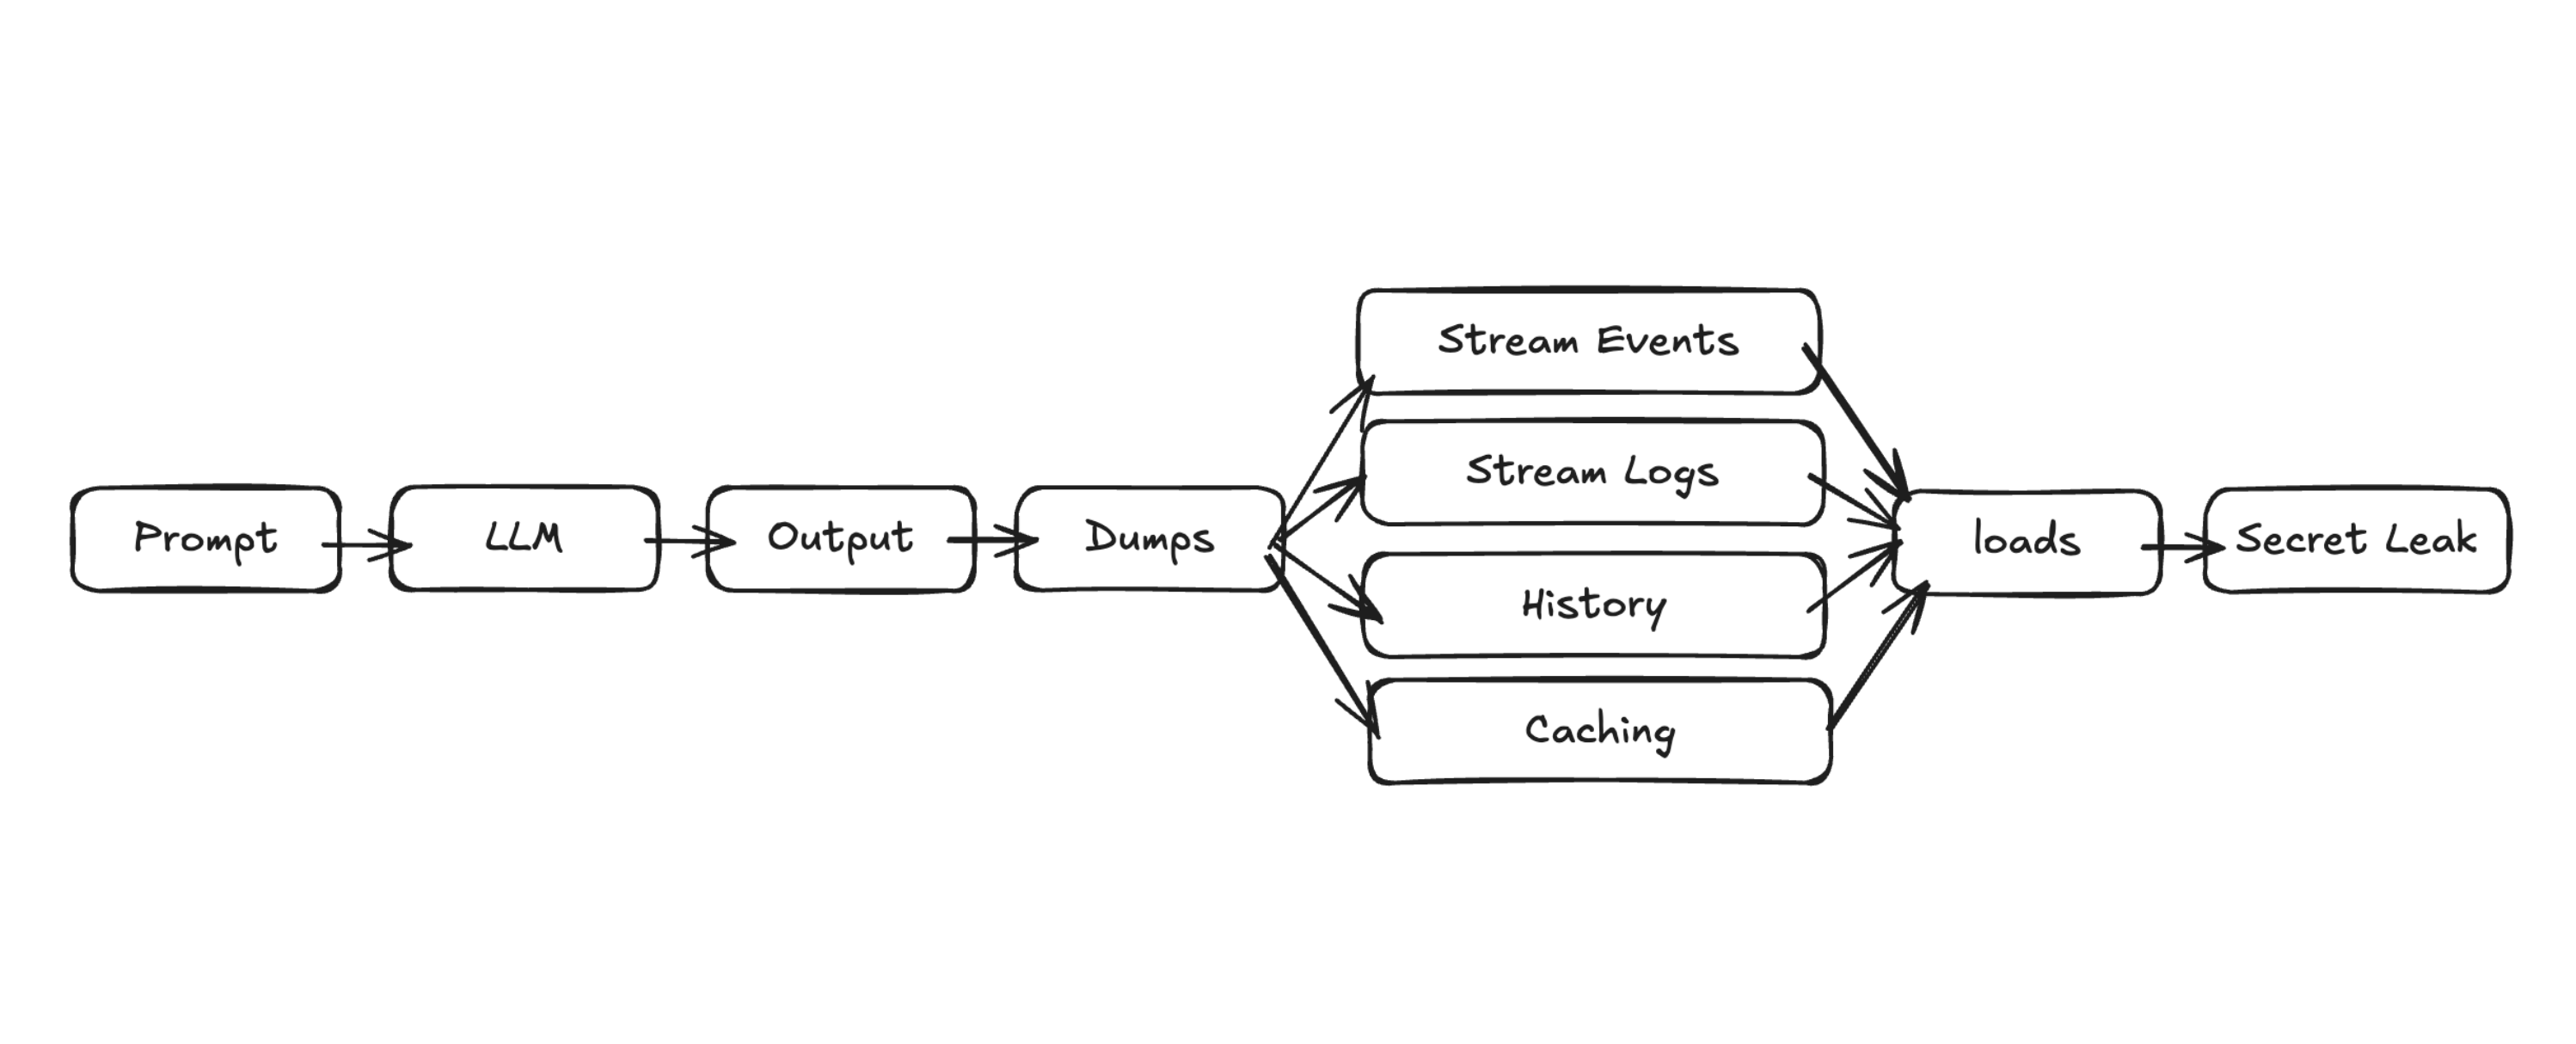
Un seul prompt peut déclencher de nombreux mécanismes. Le chemin réel le plus courant ici n'est pas « un attaquant vous envoie un blob sérialisé et vous appelez load() ». C'est plus subtil : les sorties LLM peuvent influencer des champs comme additional_kwargs ou response_metadata, et ces champs peuvent être sérialisés puis désérialisés via des fonctions courantes du framework, telles que les logs/événements en streaming. En termes simples, cela signifie qu'un exploit peut être déclenché par un seul prompt textuel, qui se répercute en cascade dans un pipeline interne étonnamment complexe.
Avant que vous ne continuiez à lire, les correctifs sont déjà publiés dans les versions 1.2.5 et 0.3.81. Si vous utilisez LangChain en production, c'est plus compliqué qu'il n'y paraît ; veuillez mettre à jour dès que possible.
LangChain utilise un format de sérialisation interne spécial, où les dictionnaires contenant le marqueur « lc » représentent des objets LangChain. La vulnérabilité résidait dans le fait que dumps() et dumpd() n'échappaient pas correctement les dictionnaires contrôlés par l'utilisateur qui incluaient par inadvertance la clé réservée « lc ».
Ainsi, dès qu'un attaquant peut amener la boucle d'orchestration de LangChain à sérialiser puis désérialiser un contenu incluant la clé « lc », il peut instancier un objet arbitraire non sécurisé, déclenchant potentiellement de nombreux chemins favorables à l'attaquant.
L'avertissement énumère 12 flux vulnérables différents, extrêmement courants dans les cas d'utilisation réels, tels que la diffusion d'événements standard, la journalisation, l'historique des messages/mémoire ou les caches :
Les conséquences les plus dévastatrices incluent :
Extraction de secrets à partir des variables d'environnement. L'avertissement indique que cela se produit lors de la désérialisation avec secrets_from_env=True. Notons que c'était le comportement par défaut jusqu'à hier. 🙂
Instanciation d'objets dans des espaces de noms pré-approuvés (notamment langchain_core, langchain_openai, langchain_aws, langchain_anthropic…), provoquant potentiellement des effets de bord dans les constructeurs (appels réseau, opérations sur les fichiers, etc.).
Dans certaines conditions, l'instanciation d'objets LangChain peut conduire à une exécution de code arbitraire.
Cela est classé sous CWE-502 : Désérialisation de données non fiables, avec un score CVSS CNA de 9,3 (Critique).
La veille de Noël, je faisais le travail le moins festif qui soit : examiner le code de sérialisation et me demander « attendez… pourquoi ceci est-il considéré comme fiable ? »
La recherche en sécurité semble souvent dramatique vue de l'extérieur. En réalité, il s'agit généralement d'une lecture minutieuse, de petites hypothèses et de l'accumulation lente de moments « c'est étrange ».
Cela a commencé comme beaucoup de choses chez Cyata : par une question simple que nous posons constamment lors de l'évaluation des stacks d'IA face au risque réel :
Où se trouvent les frontières de confiance dans les applications d'IA, et les développeurs savent-ils vraiment où se trouvent ces frontières ?
LangChain est un framework puissant et, comme la plupart des frameworks modernes, il doit déplacer des données structurées complexes : messages, appels d'outils, événements en streaming, traces, caches et « runnables ».
En examinant les recherches précédentes, il y avait déjà des travaux approfondis sur les outils et intégrations LangChain, mais très peu de découvertes dans la bibliothèque principale.
J'ai commencé la recherche en travaillant à rebours : trouver les endroits intéressants (sinks), puis déterminer comment un attaquant pouvait les atteindre. La désérialisation était une cible évidente.
Il m'a fallu pas mal de temps pour trouver quelque chose de significatif. Mais après un certain temps, j'ai découvert qu'en supposant un primitif de désérialisation contrôlé par l'attaquant, je pouvais déclencher un SSRF aveugle pouvant être utilisé pour exfiltrer des variables d'environnement (détaillé bientôt). Comme le résultat était limité à l'exfiltration de secrets et non à mon objectif principal de RCE, j'ai continué à auditer la désérialisation et j'ai pris mon temps.
Le bug n'était pas un morceau de mauvais code, c'était une absence de code. dumps() n'échappait tout simplement pas les dictionnaires contrôlés par l'utilisateur contenant des clés « lc ». Un échappement manquant dans le chemin de sérialisation, pas de désérialisation.
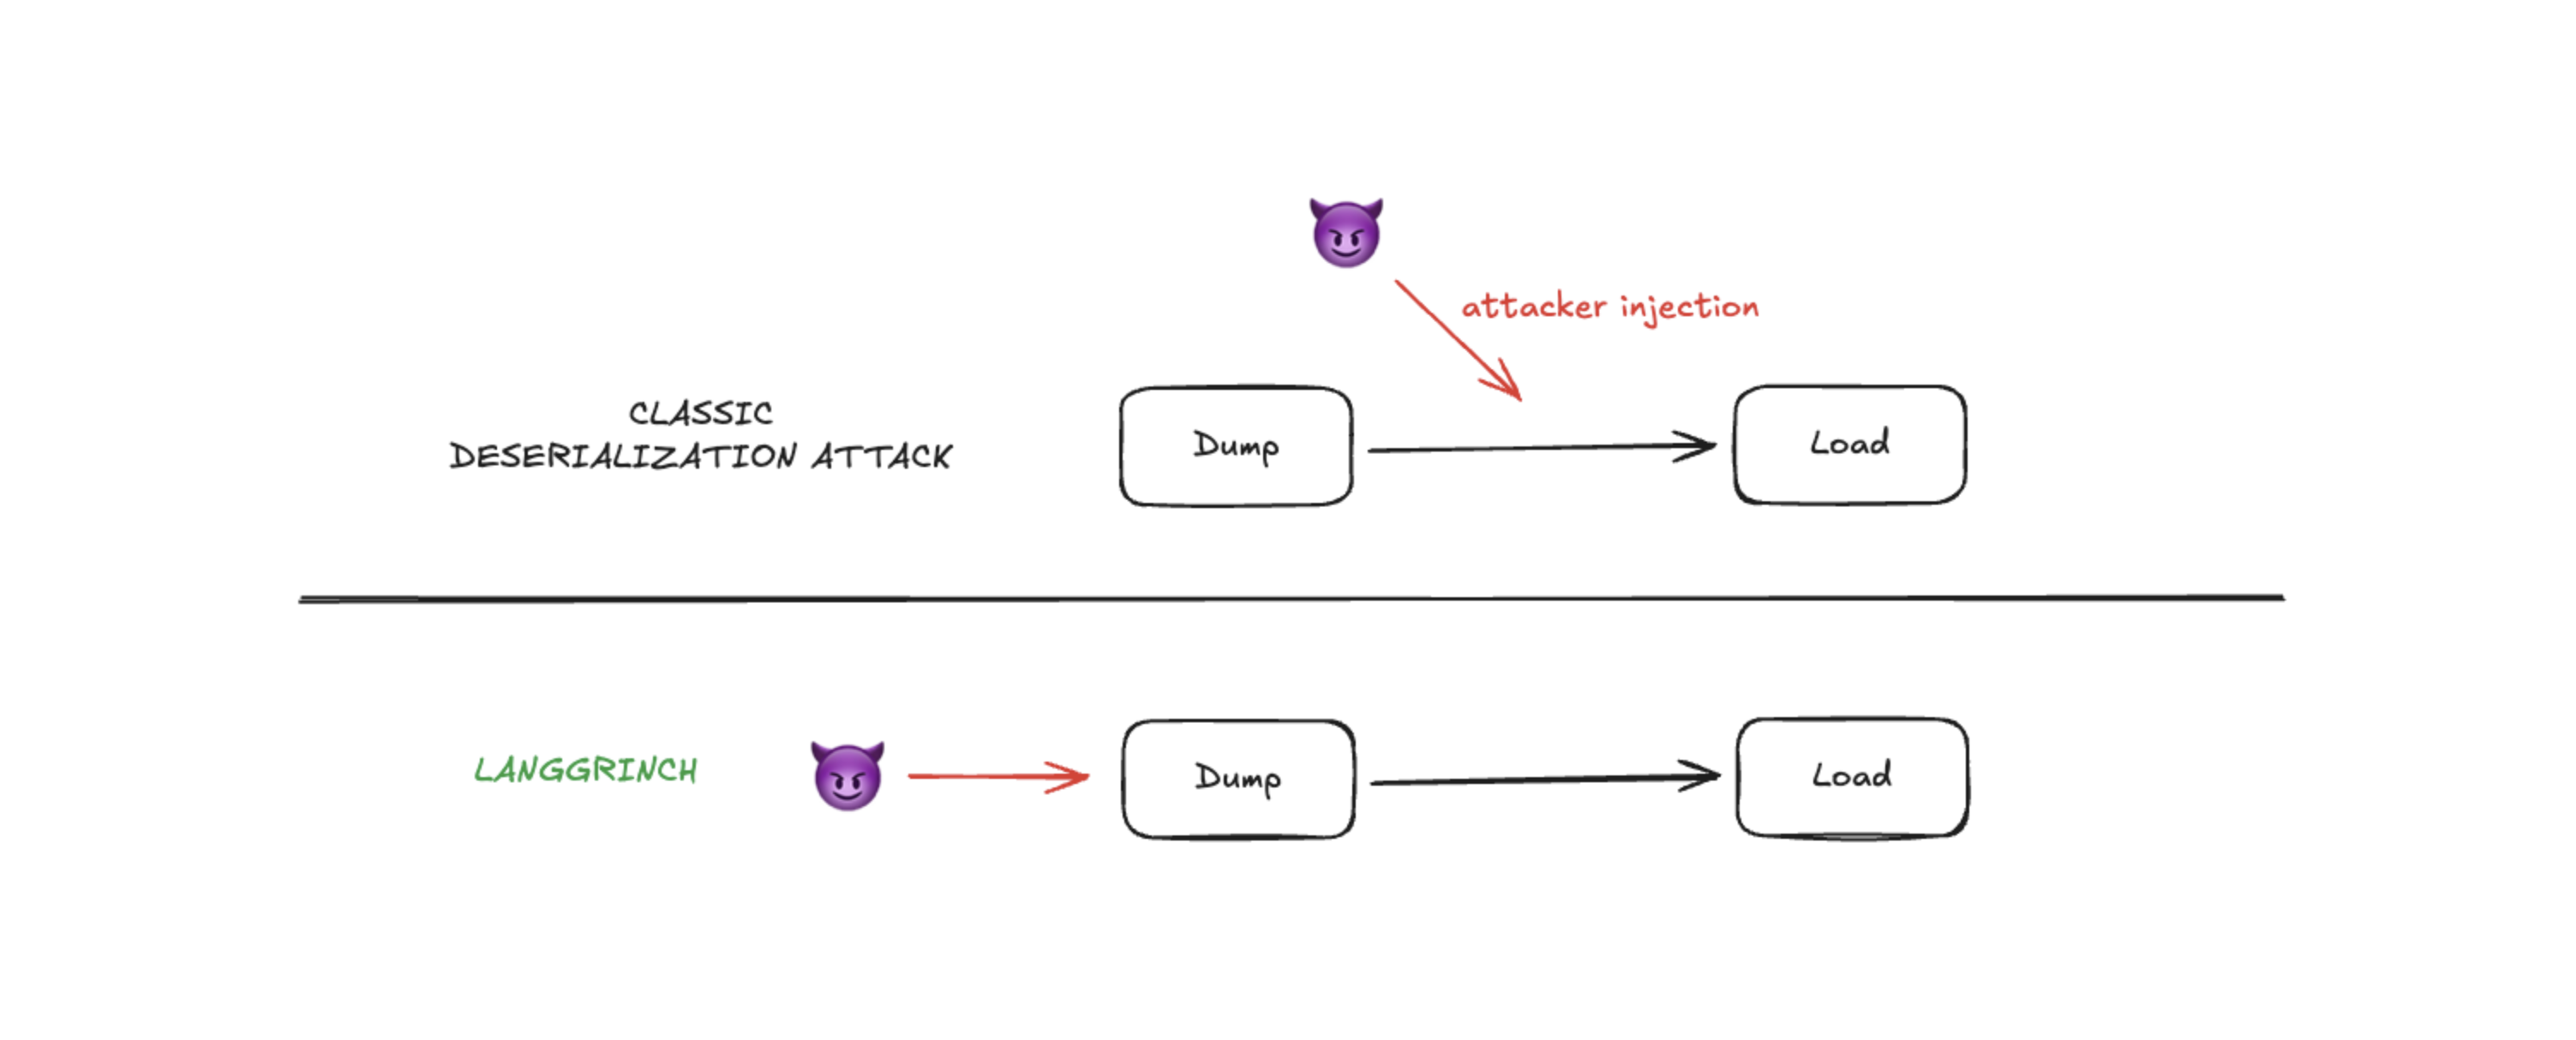
Il est bien plus facile de remarquer quelque chose de faux que de remarquer l'absence de quelque chose, surtout lorsque vous auditez load() plutôt que dumps(). Dans l'un des frameworks d'IA les plus minutieusement audités. Deux ans et demi.
À partir de là, la recherche est devenue un exercice structuré :
Identifier où le contenu non fiable (principalement des dictionnaires arbitraires) entre dans la sérialisation (sorties LLM, injection de prompts, saisie utilisateur, outils externes, documents extraits).
Déterminer quand ces données sérialisées sont désérialisées.
Déterminer ce qu'un attaquant peut accomplir avec une instanciation arbitraire d'objets.
À ce stade, la découverte principale était suffisamment claire et exploitable pour un rapport responsable : il y avait une brèche d'échappement dans dumps() / dumpd() autour des dictionnaires avec la clé « lc ».
