 andreyglauzer/vigilantonion
🐍 - Crawler sur les sites du réseau Tor, à la recherche de mots-clés.



Crawler sur les sites du réseau tor, à la recherche de mots-clés.
VigilantOnion est complété par les équipes de Cyber Threat Intelligence afin qu'elles puissent surveiller et obtenir le meilleur résultat des consultations effectuées sur le réseau tor.
Dans sa première version utilisant django pour l'administration et la création de tableaux de bord, il y avait une grande difficulté dans son utilisation. Dans cette nouvelle version, les consultations et la méthodologie utilisée pour éliminer les faux positifs sont meilleures.
Pour éliminer les faux positifs et améliorer le niveau d'exactitude, j'utilise des yararules et des notes, en définissant des valeurs élevées pour les règles que je trouve les plus pertinentes, comme le montre la figure ci-dessous :
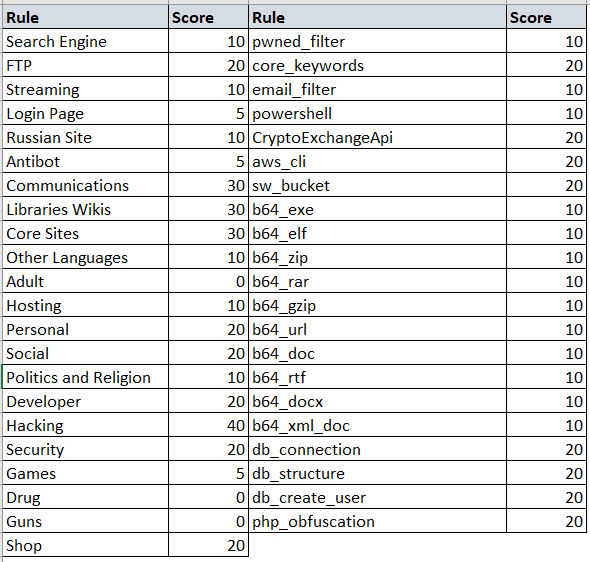
Ces valeurs sont dynamiques et peuvent changer selon vos besoins.
De nouvelles yararules peuvent être ajoutées aux fichiers de catégories et de mots-clés, afin que vous puissiez éliminer les faux positifs et obtenir des résultats plus agréables.
Peu de choses doivent être modifiées dans le fichier de paramètres, mais elles sont d'une grande importance pour l'utilisation du script.
Les champs ci-dessous servent à configurer le proxy du réseau tor ; si vous exécutez un script sous Windows, le port change généralement pour 9051
server_proxy:  localhost
port_proxy:  9050
type_proxy:  socks5h
Le champ timeout du serveur vous permet de déterminer le temps d'attente des requêtes ; plus ce temps est long, plus le script peut prendre du temps.
timeout: 30
Les champs de score du serveur vous permettent de déterminer la valeur de score minimale pour que l'URL soit crawlée et envoyée au syslog.
score_categorie:  20
score_keywords:  40
Certaines urls seront hors ligne et il est difficile de savoir si elles reviendront ou non, j'ai donc créé un compteur qui vous permet de déterminer le nombre maximal de tentatives ; une fois ce nombre atteint, le script ne tentera plus d'accéder à cette url.
count_categories: 5
Chaque fois qu'un crawl est effectué sur l'url, il est enregistré avec la date de ce dernier scan, et vous pouvez déterminer une limite de temps en jours entre un scan et un autre sur cette même url.
daystime: 10
Et enfin, je n'utilise plus django ; désormais, pour consulter vos résultats, vous avez besoin d'un syslog comme Splunk ou ELK, et il vous suffit de les définir ici
sendlog:  True
logport:  5151
logip:  "localhost"
Son utilisation est plus simple : il vous suffit d'avoir installé tor, ainsi que les bibliothèques python ; pour ce faire, exécutez la commande ci-dessous :
pip install -r requirements.txt
Après avoir installé le client tor et les bibliothèques, utilisez la commande --help pour obtenir les détails de son utilisation.
➜  python3 observer.py -h
usage: observer.py [-h] [--config CONFIG] [--crawler] [--url URL] [--search]
                   [--engines ENGINES] [--find FIND] [--pastebin PASTEBIN]

VigilantOnion is a script to collect as many sites from the onion network as
possible and add them to a database. With all possible sites collected, a
crawler will be created so that we can monitor the search for keywords defined
by you.

optional arguments:
  -h, --help            show this help message and exit
  --config CONFIG, -c CONFIG
                        Configuration file in yaml format
  --crawler             Starts the TOR network URL crawler process.
  --url URL, -u URL     Specifies the URL to crawl.
  --search              Start the URL search process on the surface. Select a
                        framework where you want to search for urls.
  --engines ENGINES, -e ENGINES
                        Validates the available engines for searching URLs.
  --find FIND, -f FIND  Search for arguments on .onion network research sites
  --pastebin PASTEBIN   Search for .onion urls in pastebin paste.

You can also develop new framework so that the database has more urls onions.
Pour que le script fonctionne, vous avez besoin de nouvelles urls, et pour cela j'ai créé une méthode qui recherche des urls sur la surface, comme dans l'exemple ci-dessous :
python3.6 observer.py --config config/config.yml --search -e "gist,reddit,cybersecuritynews,discoverdarkwebservice"
Vous pouvez également obtenir des URLs directement à partir de fichiers pastebin, comme dans l'exemple ci-dessous :
python3.6 observer.py --config config/config.yml --search --pastebin "s7TPZCKz,kSaYqtVX,0GYEEApe,3qkqyqiM,RfgBLg5Q,gtksBij4,FpPzQKHg,wB0uh00r,jDGJhQCC,q6DZ9U,ac2TnUjY,pv4xRWXQ,PgLUE7pF,9XW5Pc7R,hqyGMi7e,UZRM2z8y,7tQvV5CU,9JhVq3H3,Cb5HTydt,kMW5wp3N,v5Yq66sH,2q3SsR3a,gnd8jx97,QwSJYhYF,iNydrDfe"
Après avoir collecté quelques URLs, vous pouvez démarrer le processus de crawler. Gardez à l'esprit que le premier prendra le plus de temps, car c'est là que s'effectueront la classification et la catégorisation du contenu du site web.
python3.6 observer.py --config config/config.yml --crawler
Si vous souhaitez crawler une seule URL, utilisez :
python3.6 observer.py --config config/config.yml --crawler --url "76qugh5bey5gum7l.onion"
La sortie du résultat est en json, et c'est dans le même format qu'il est envoyé au syslog choisi.
{
  "lastscan": "2020-06-29",
  "id": 10760,
  "type": "URI",
  "url": "lolitmhfkpif7sky.onion",
  "title": "Lolita Club",
  "baseurl": "vyqi2nm36otufrgg.onion",
  "status": "Online",
  "count_status": 0,
  "source": "Script",
  "categorie": [
    {
      "full_categorie": [
        "no_match"
      ],
      "score_categorie": 0
    }
  ],
  "keywords": [
    {
      "full_keywords": [
        "no_match"
      ],
      "score_keywords": 0
    }
  ],
  "discovery_date": "2020-06-29 14:24"
}
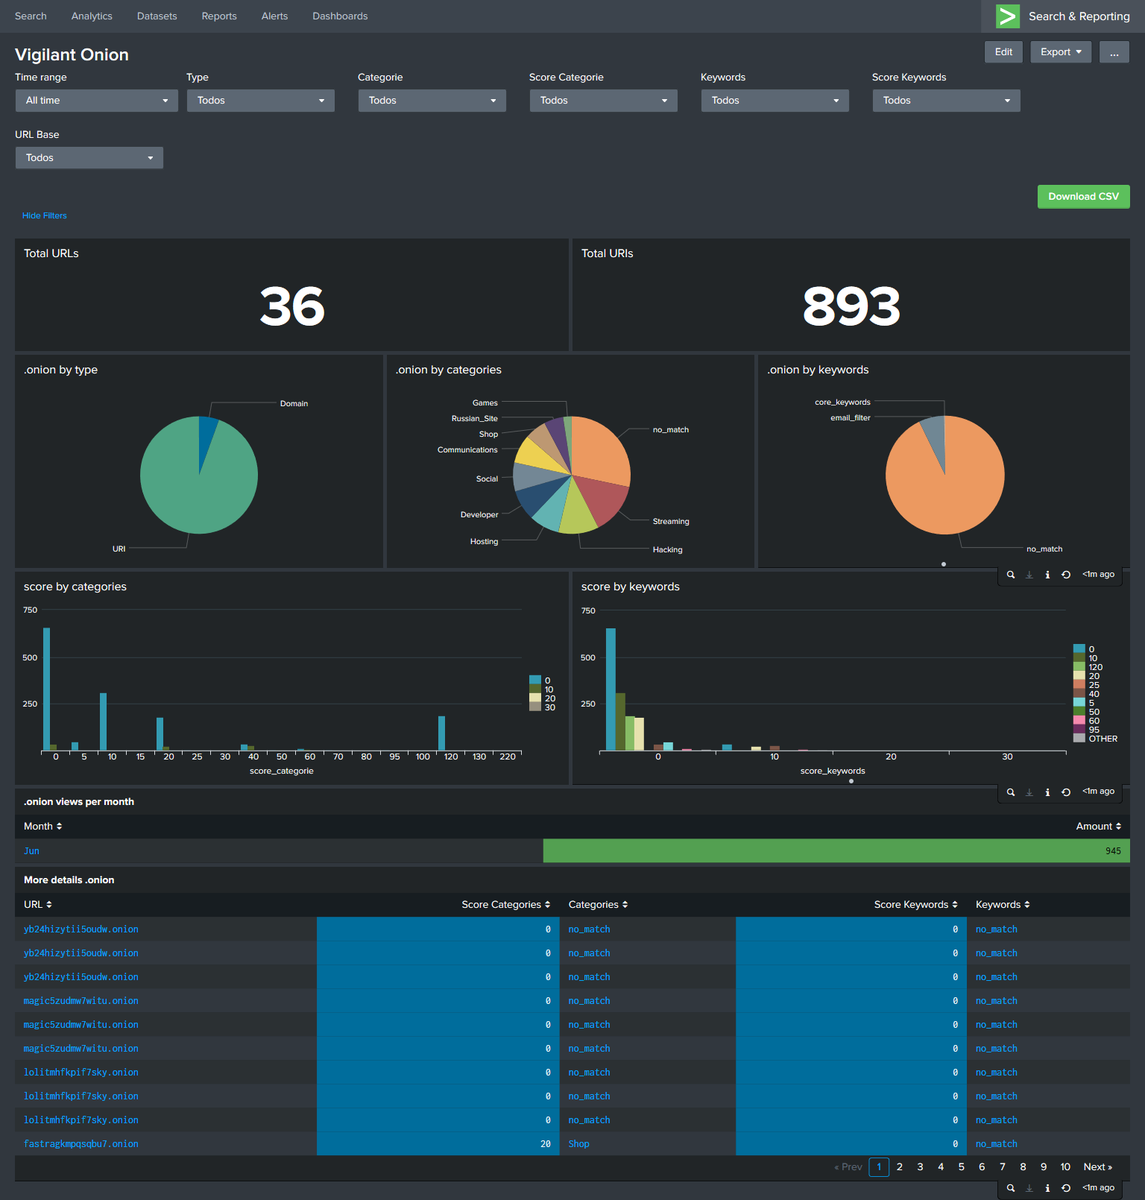
J'utilise splunk, et vous pouvez faire en sorte que votre tableau de bord ressemble au mien :
N'hésitez pas à forker ou à ouvrir une issue pour collaborer au projet.
