
Inventario automatizado de superficie de ataque para más de 800 programas públicos de bug bounty, ejecutando flujos de trabajo programados de enumeración de subdominios, permutación e informes de DNS y servidores web.

Los datos que recopilamos aquí incluyen datos de DNS y servidores web de programas públicos de bug bounty.
Nuestro objetivo con este proyecto es:

La configuración consta de dos flujos de trabajo
Este flujo de trabajo agiliza la consolidación de datos de programas de bug bounty de diversas fuentes, garantizando una visión completa y organizada. Vamos a desglosarlo:
Recopilación de datos: El flujo de trabajo obtiene datos de dos fuentes importantes:
Transformación de datos: Los datos recopilados se someten a transformación mediante scripts de Python. Los scripts convierten los datos a un formato específico, garantizando la consistencia y la facilidad de análisis. Puedes encontrar el formato detallado de los datos en el archivo targets.json.
Fusión de programas: Para evitar la duplicación, el flujo de trabajo fusiona los programas con la misma URL. Esta consolidación elimina redundancias y presenta una visión unificada de los programas de bug bounty.
Inclusión de programas de la comunidad: El flujo de trabajo incorpora un conjunto adicional de programas del archivo community.json. Estos programas se fusionan con el conjunto de datos existente, mejorando su cobertura y diversidad.
Salida final: El flujo de trabajo genera un archivo JSON consolidado final, targets.json, que abarca todos los datos fusionados de los programas de bug bounty. Este archivo sirve como un recurso valioso para los investigadores de bug bounty, proporcionando una visión centralizada y completa de los programas.
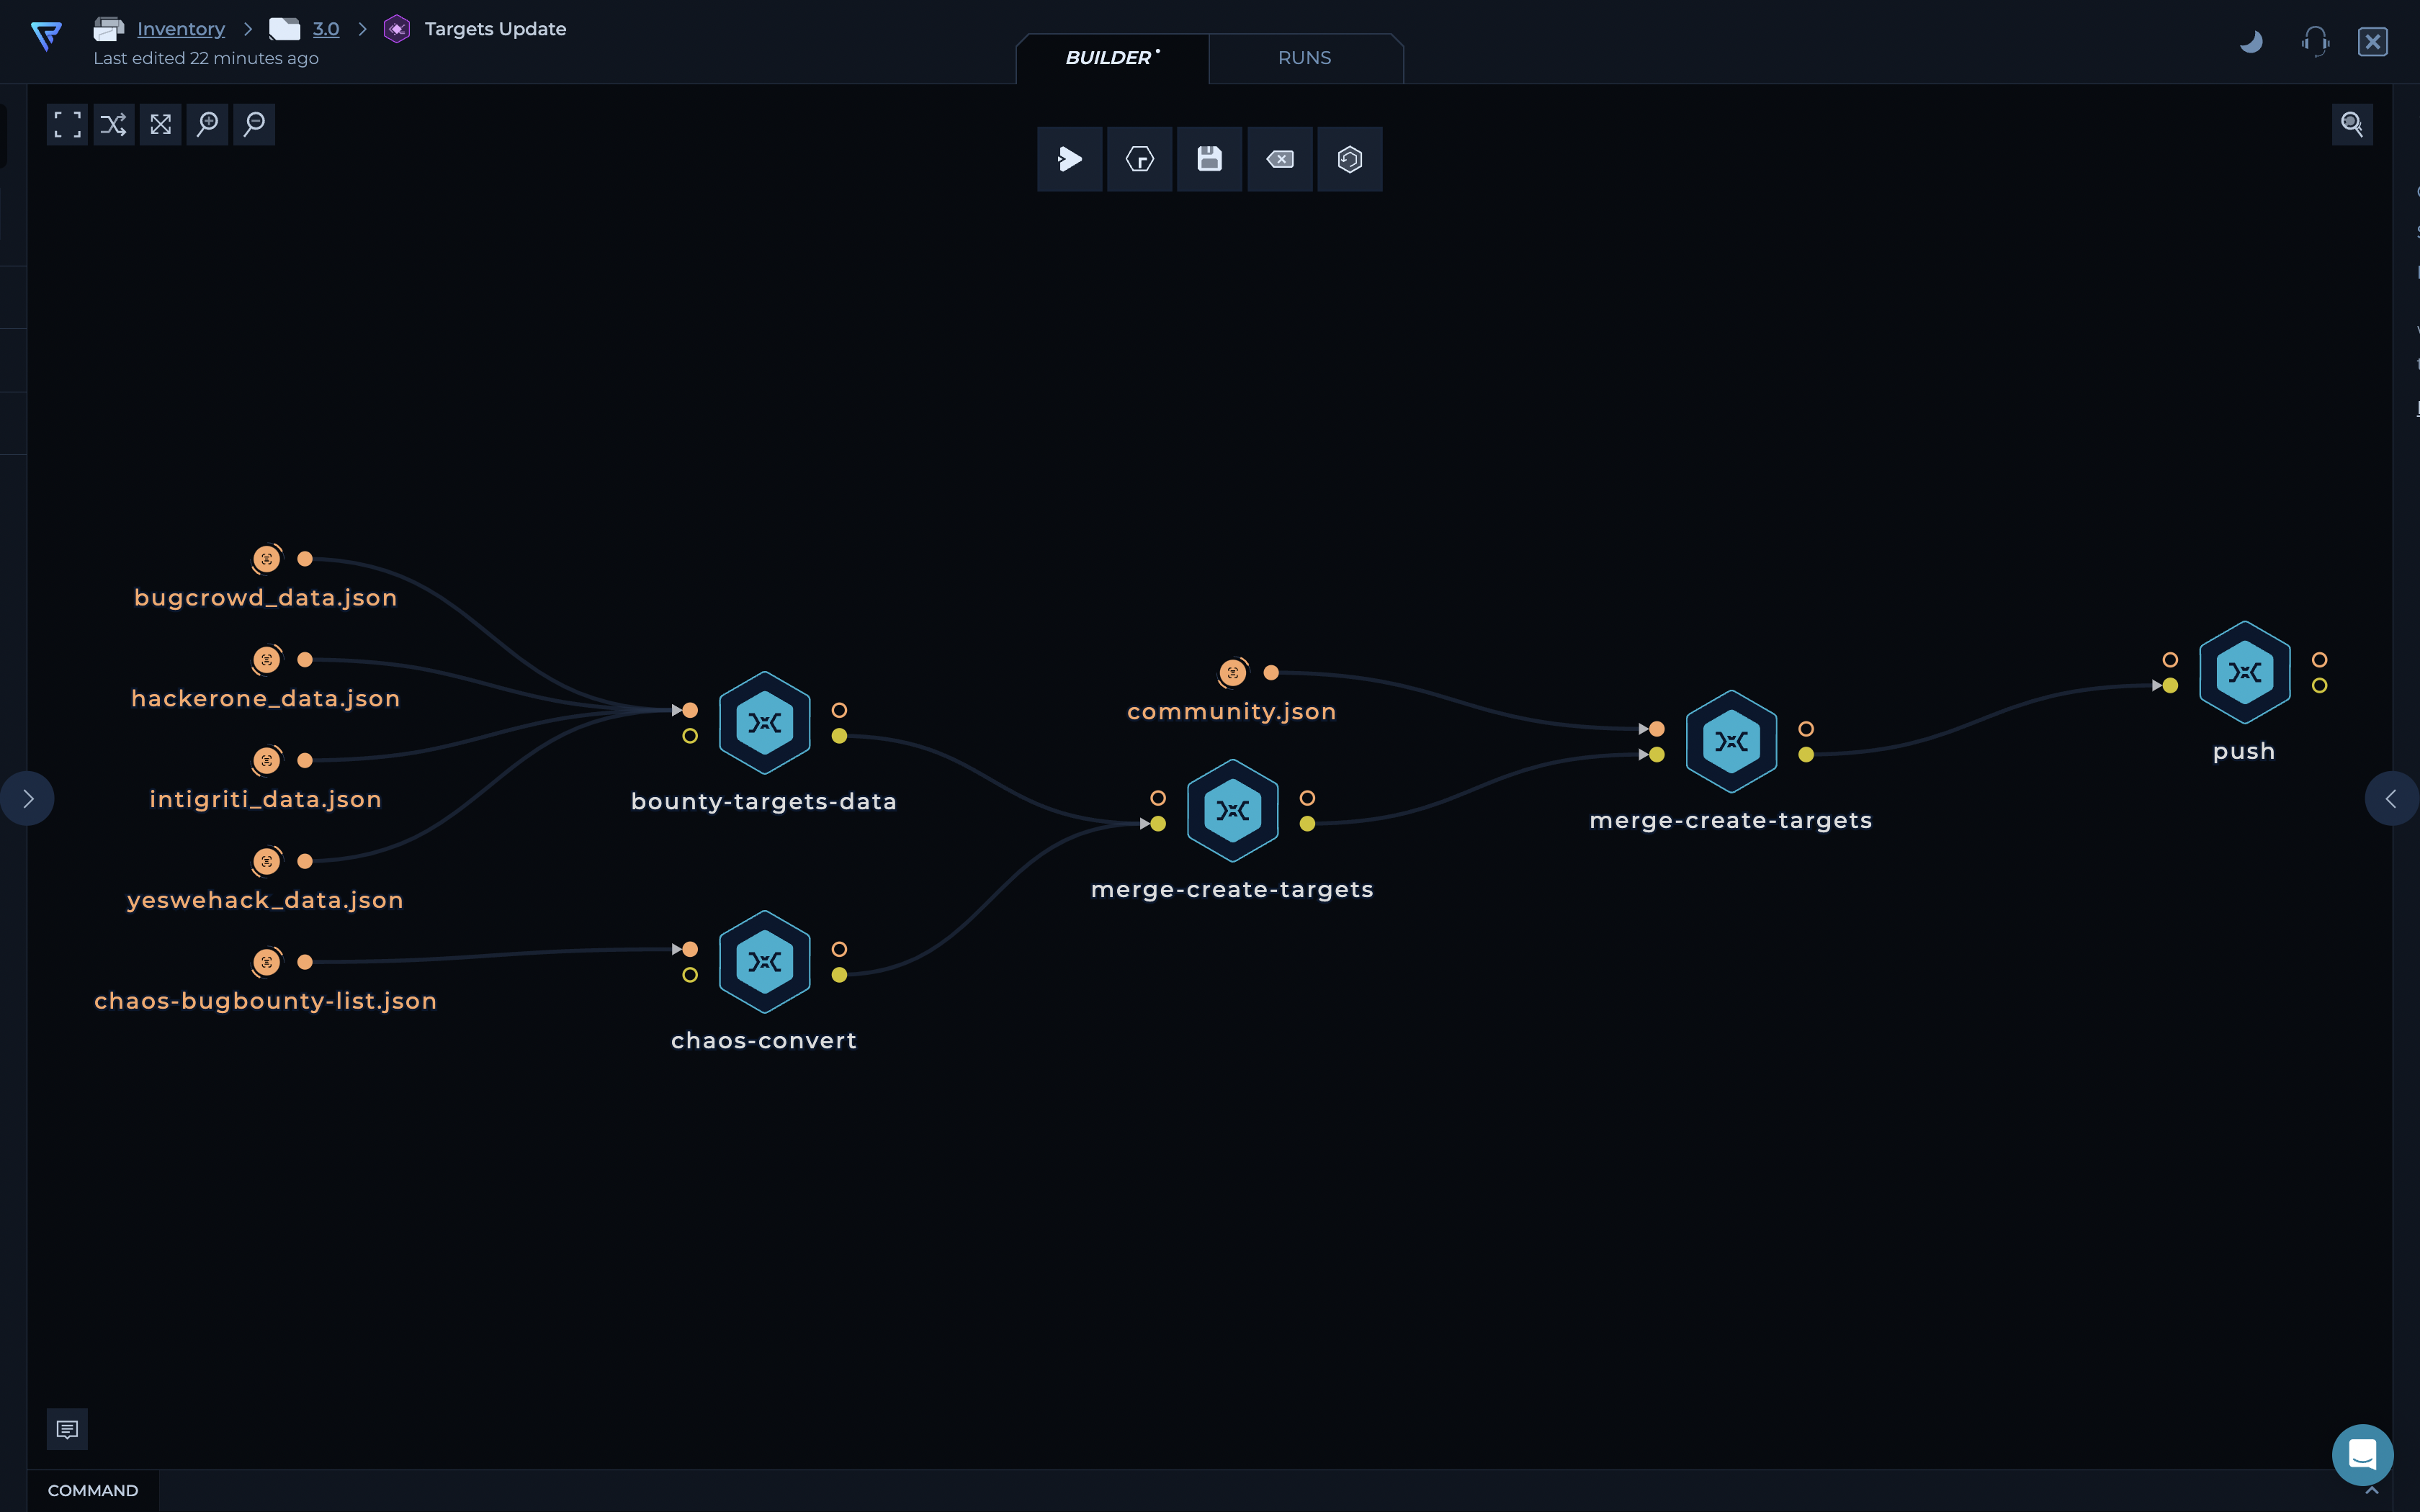
Nota: La captura de pantalla anterior proporciona una representación visual del flujo de trabajo.
Recopilación de los objetivos: Obtén la lista de dominios de targets.json y extrae los nombres de los programas.
Hacer que el flujo de trabajo se ejecute en paralelo: Los nombres de los programas extraídos se conectan al nodo file-splitter para hacer que todo el flujo de trabajo se distribuya por programa
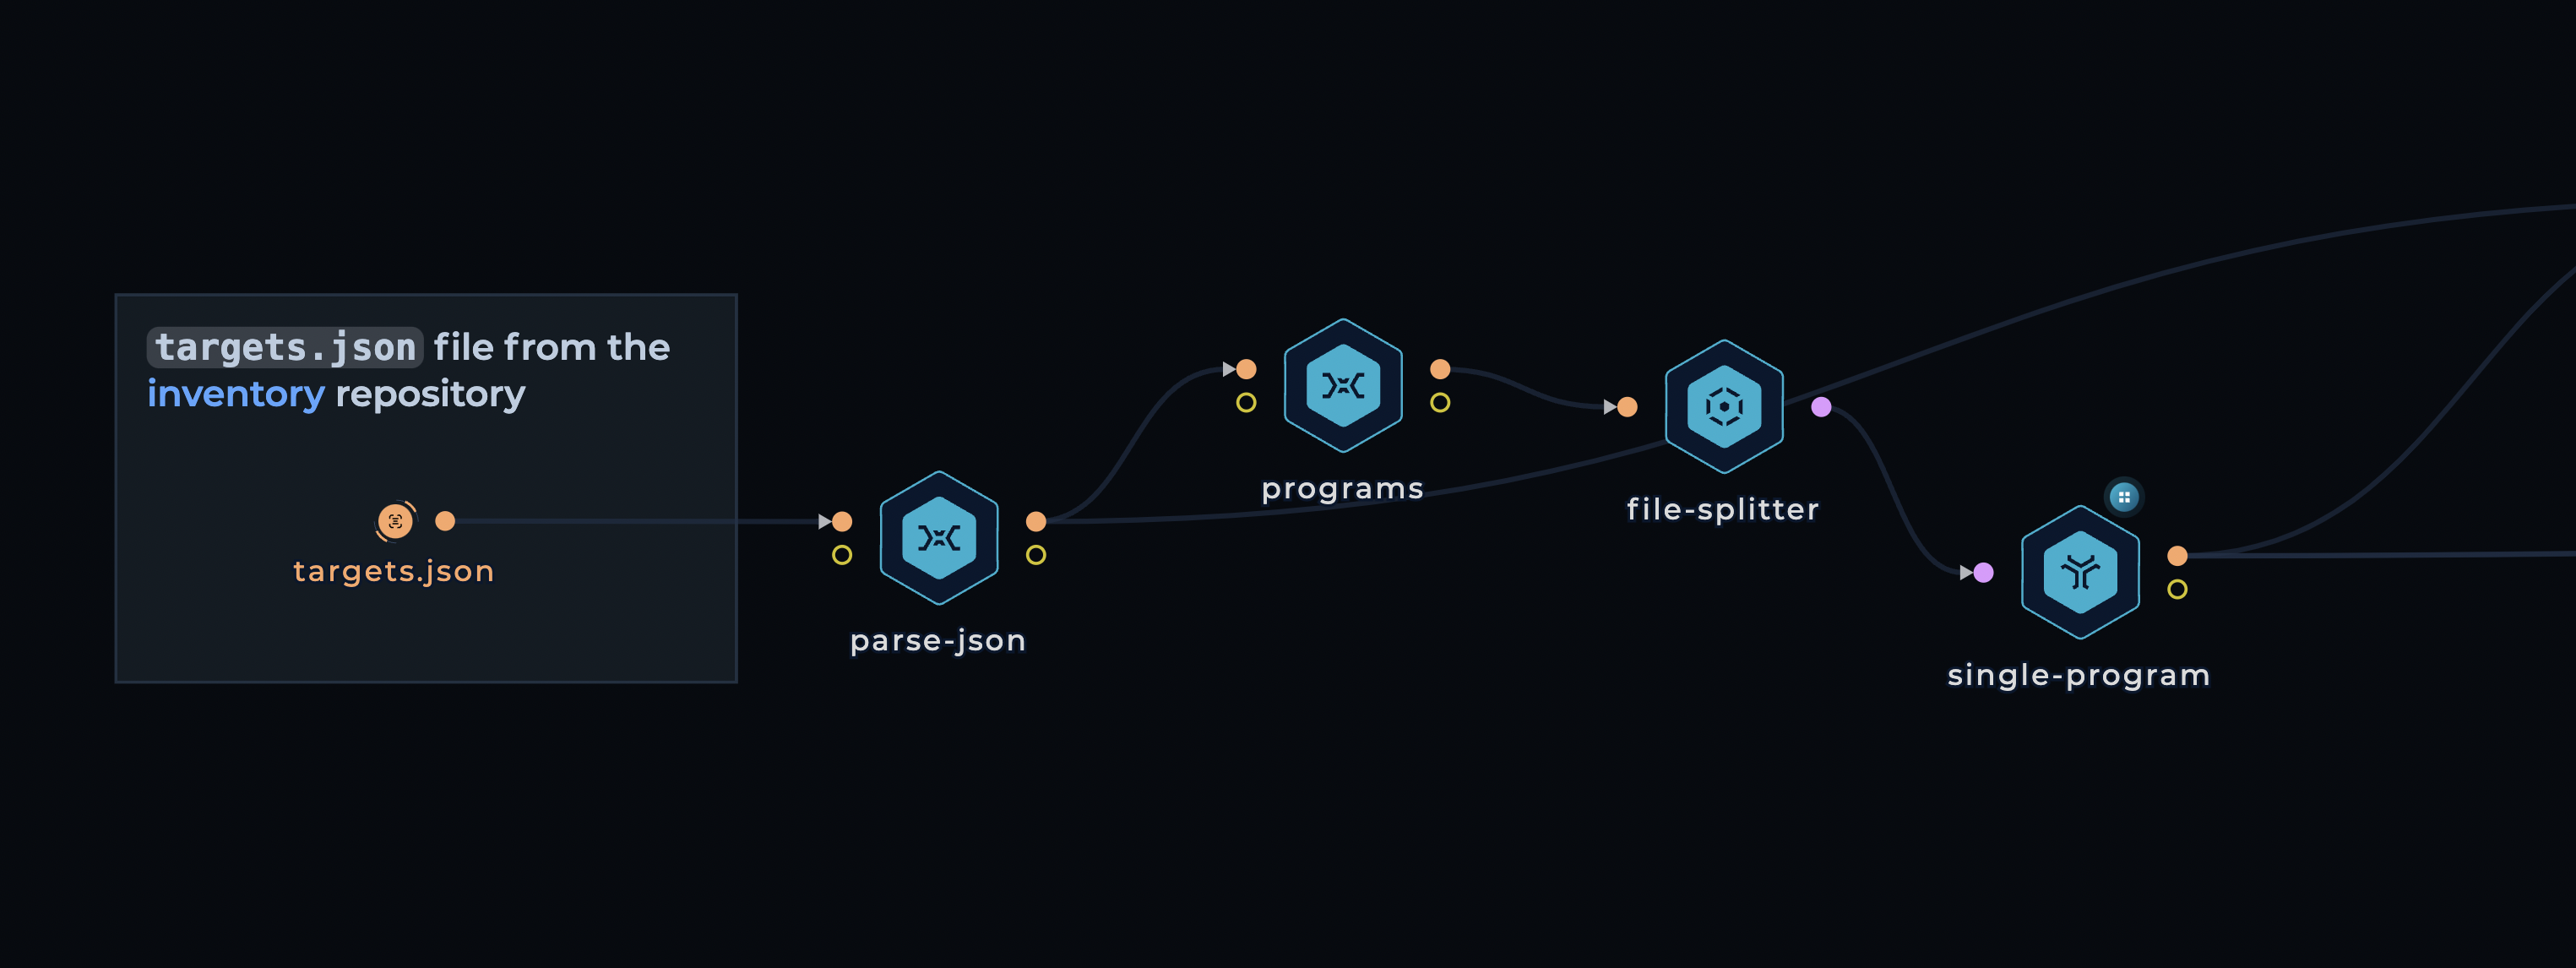
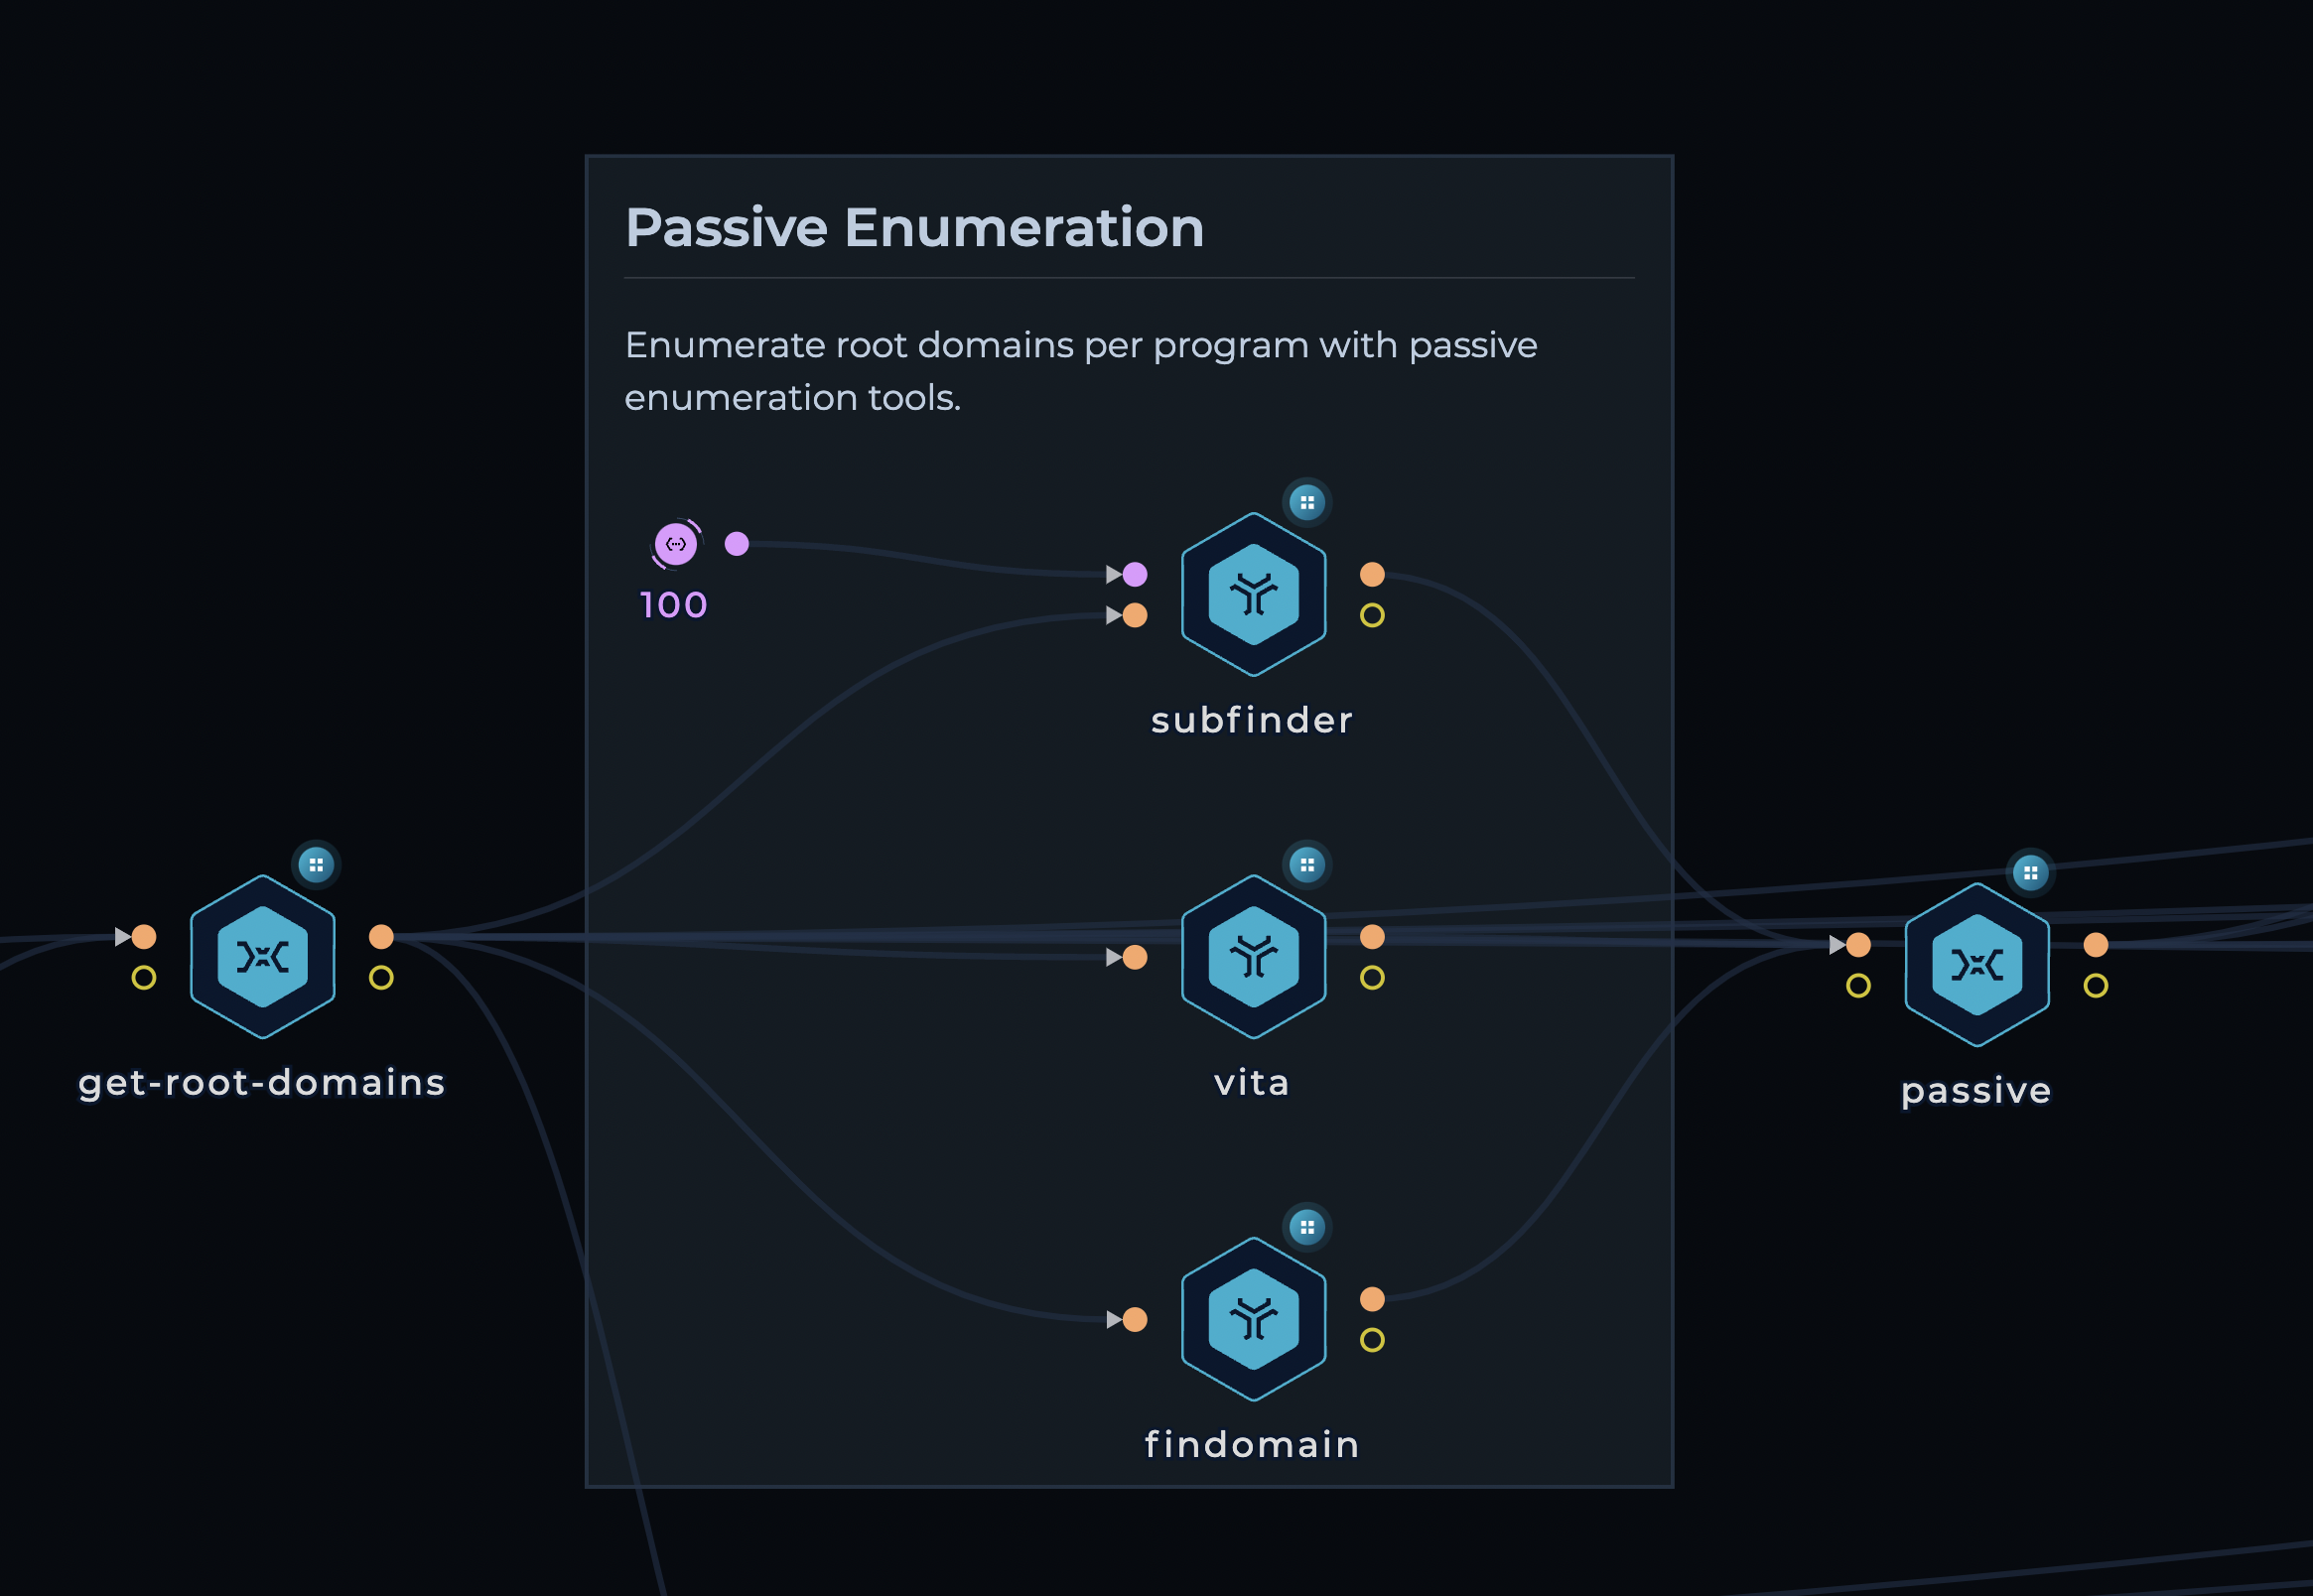
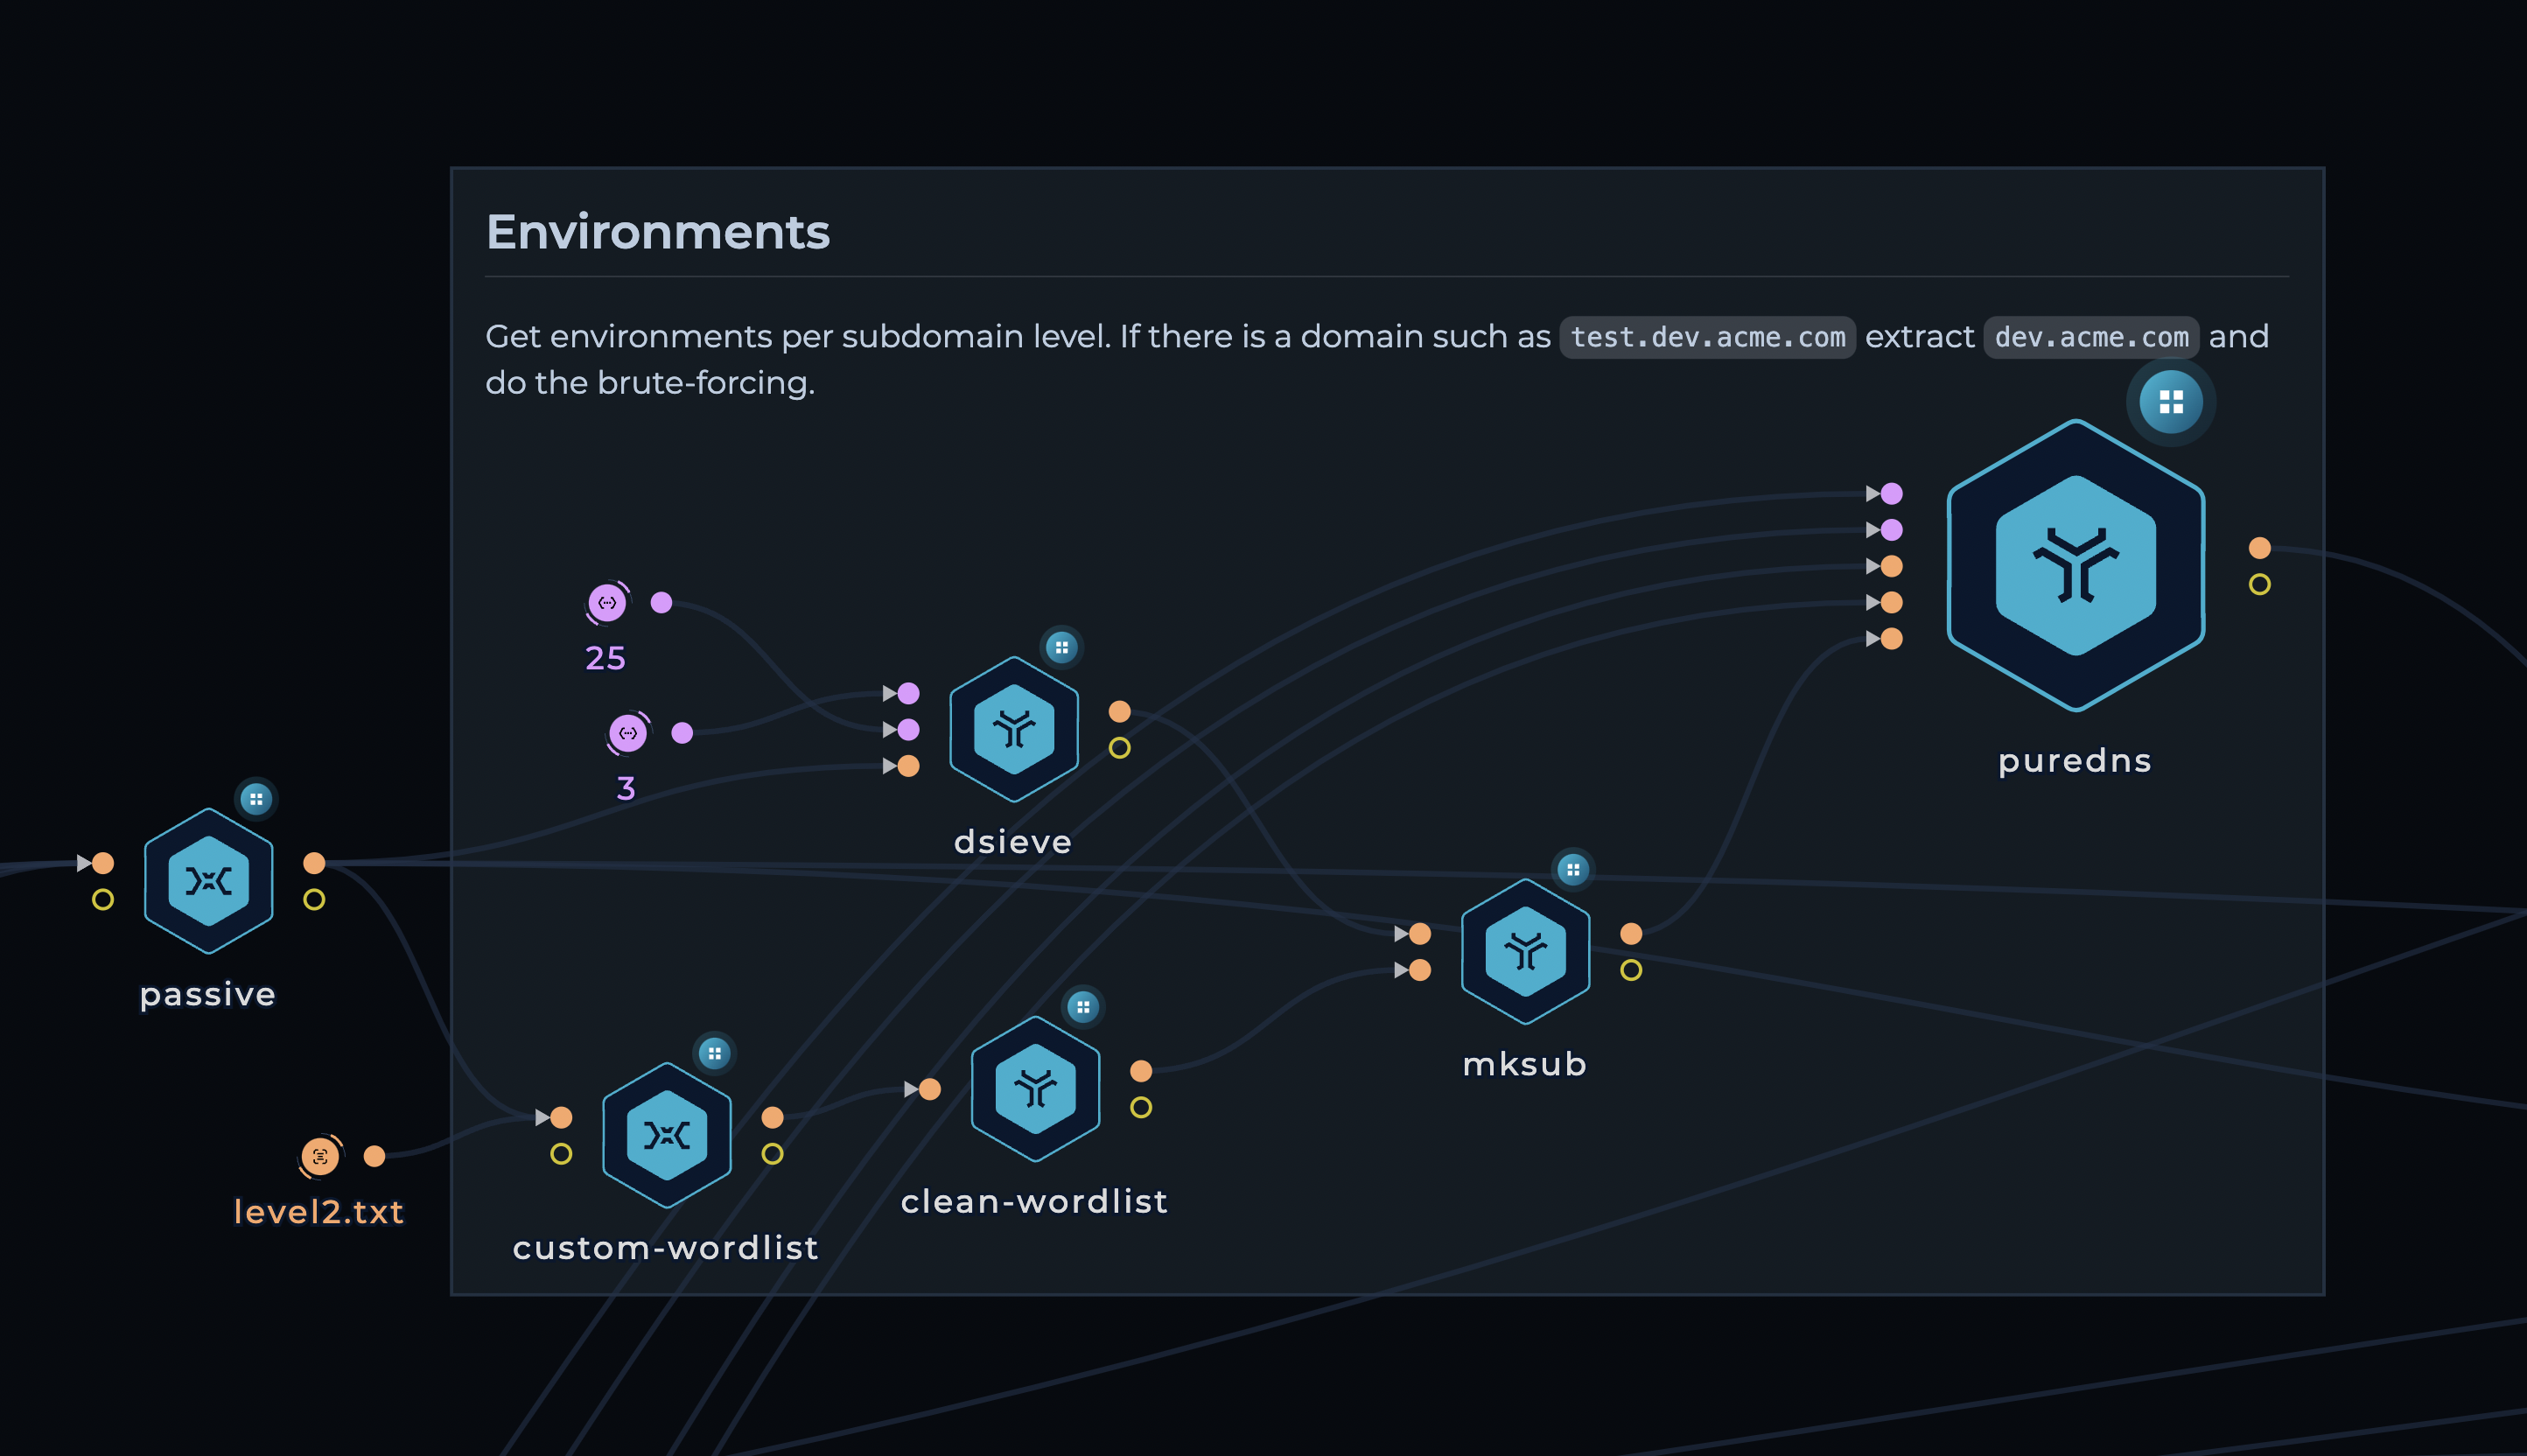
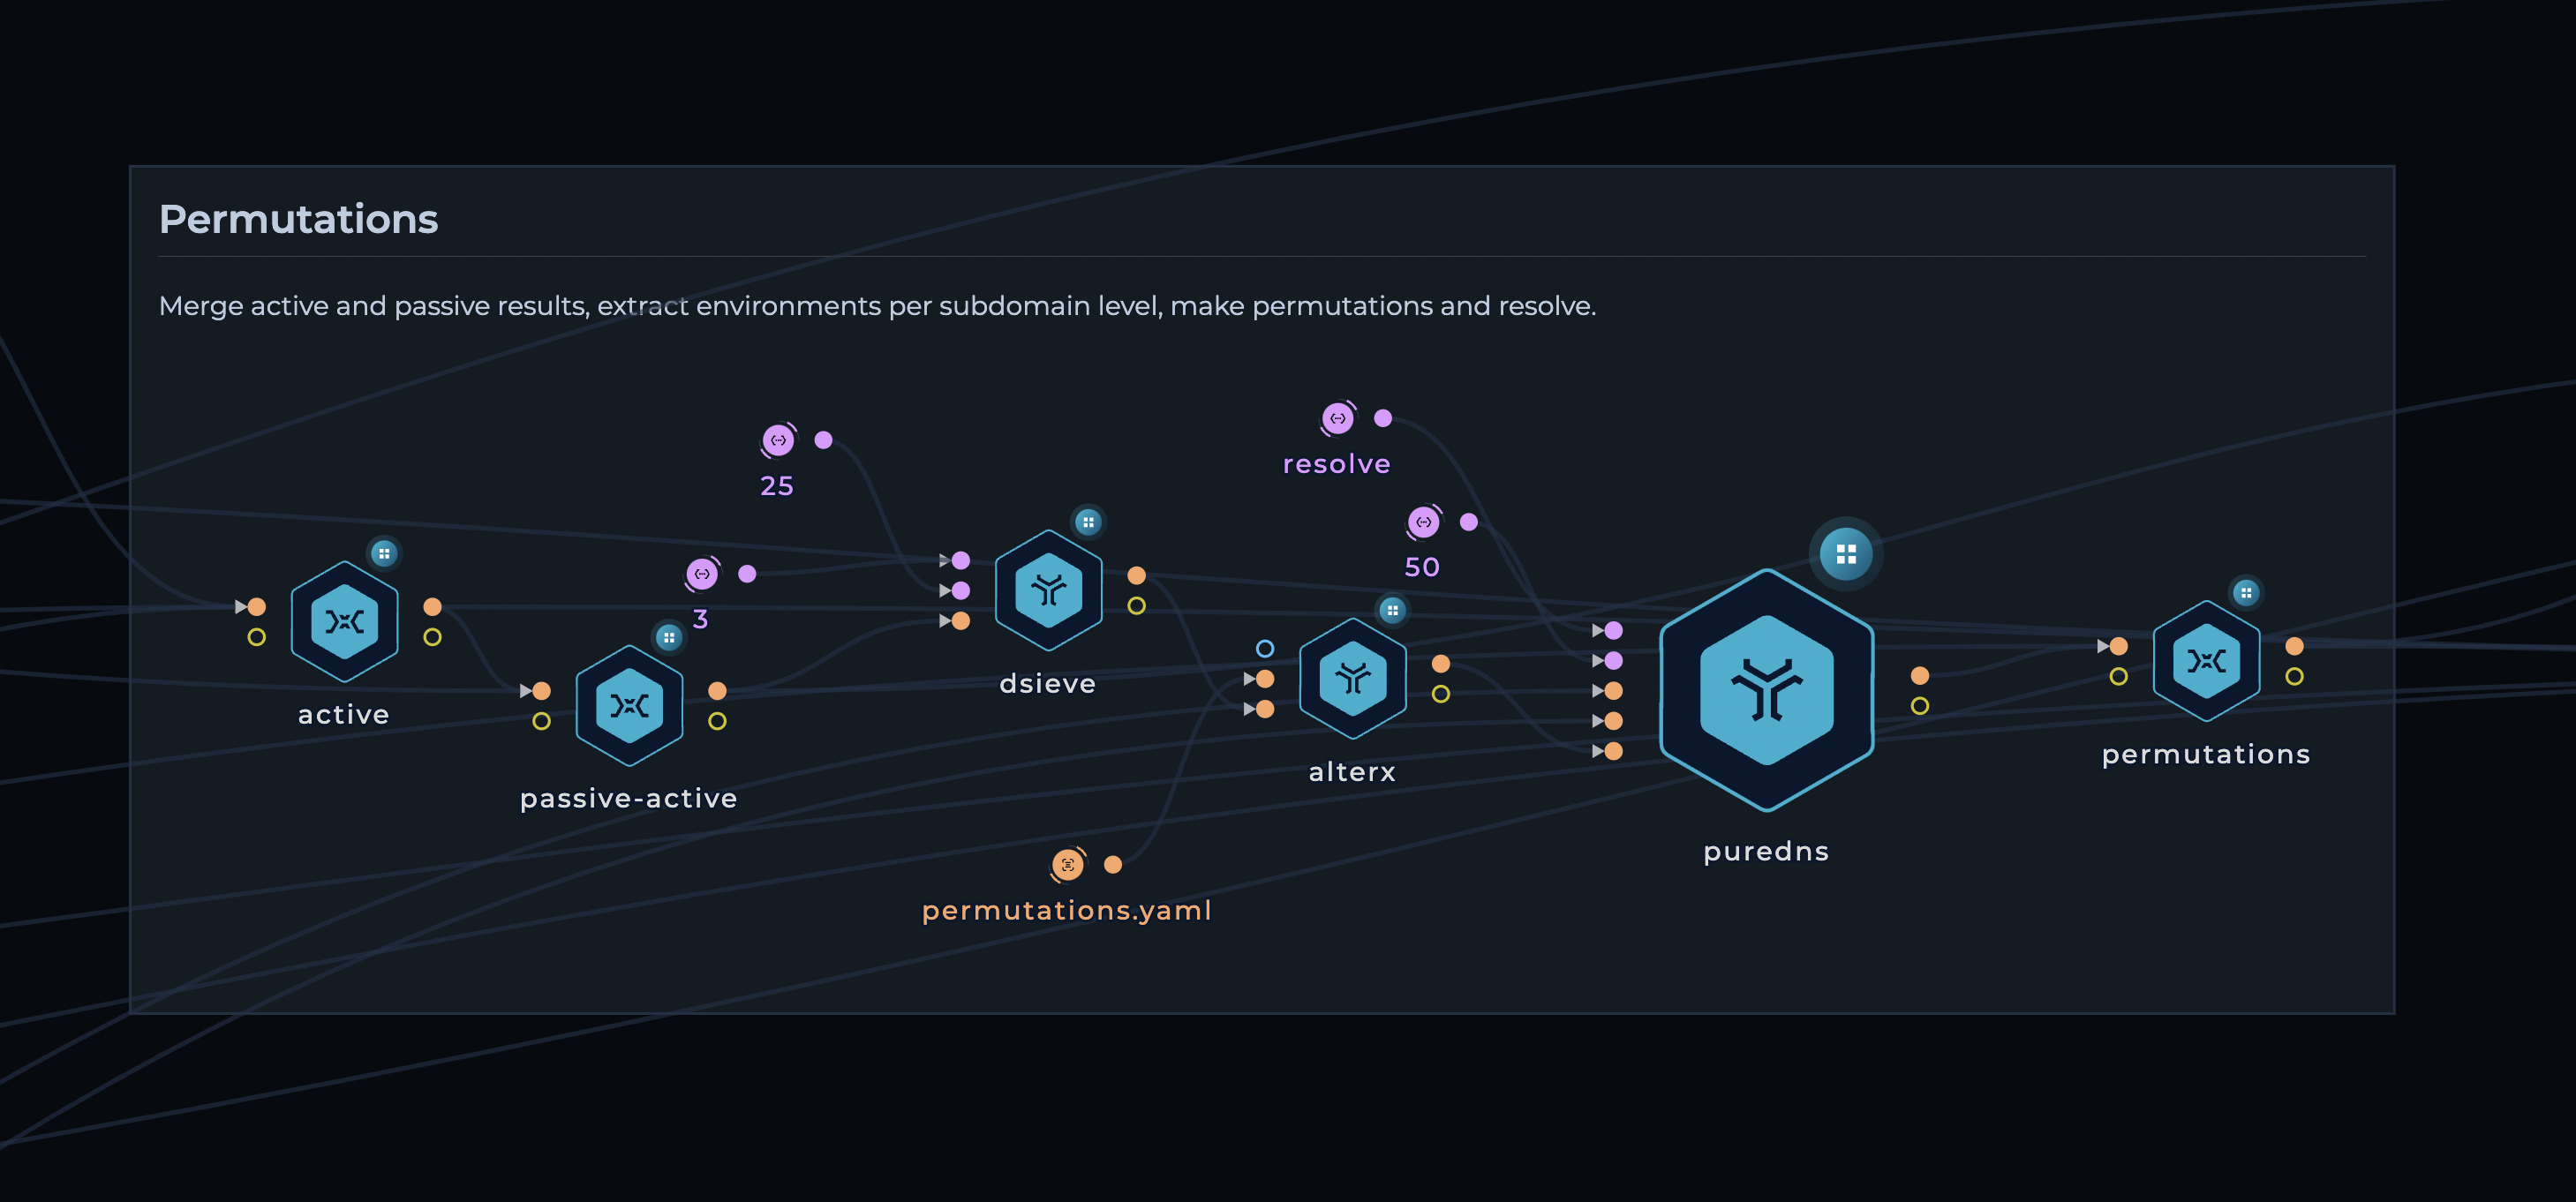
hostnames.txt anteriores por programa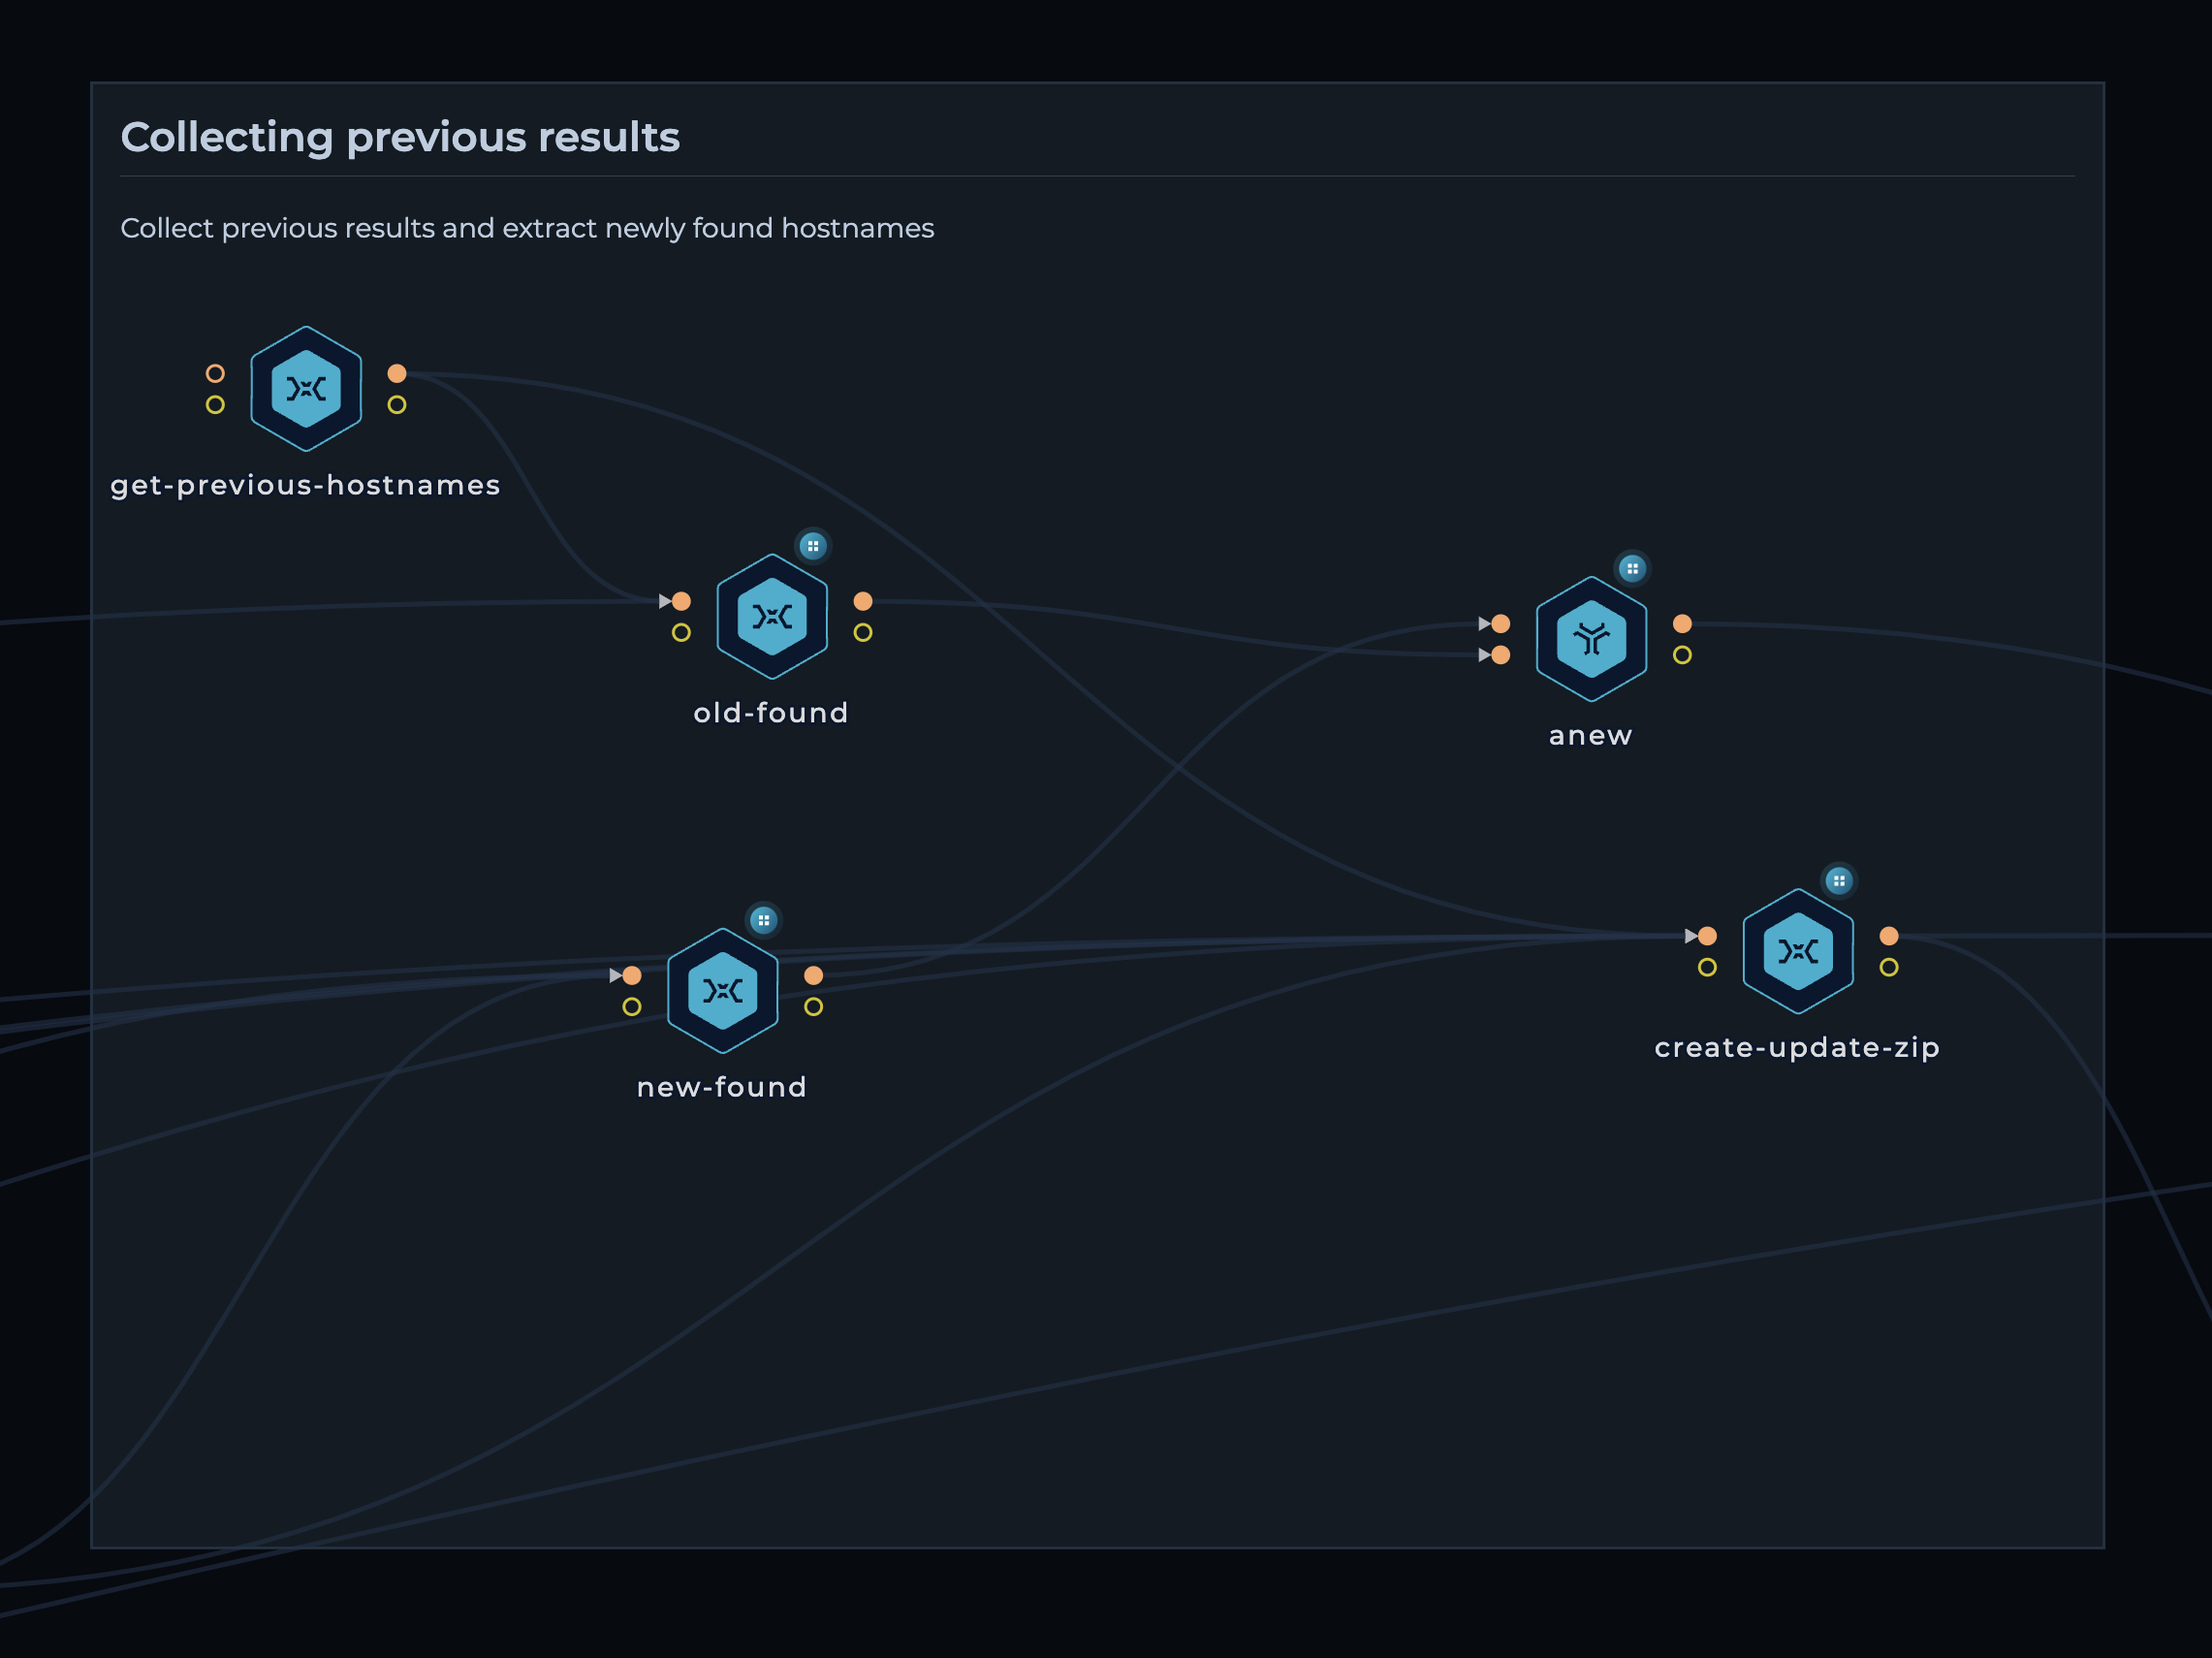
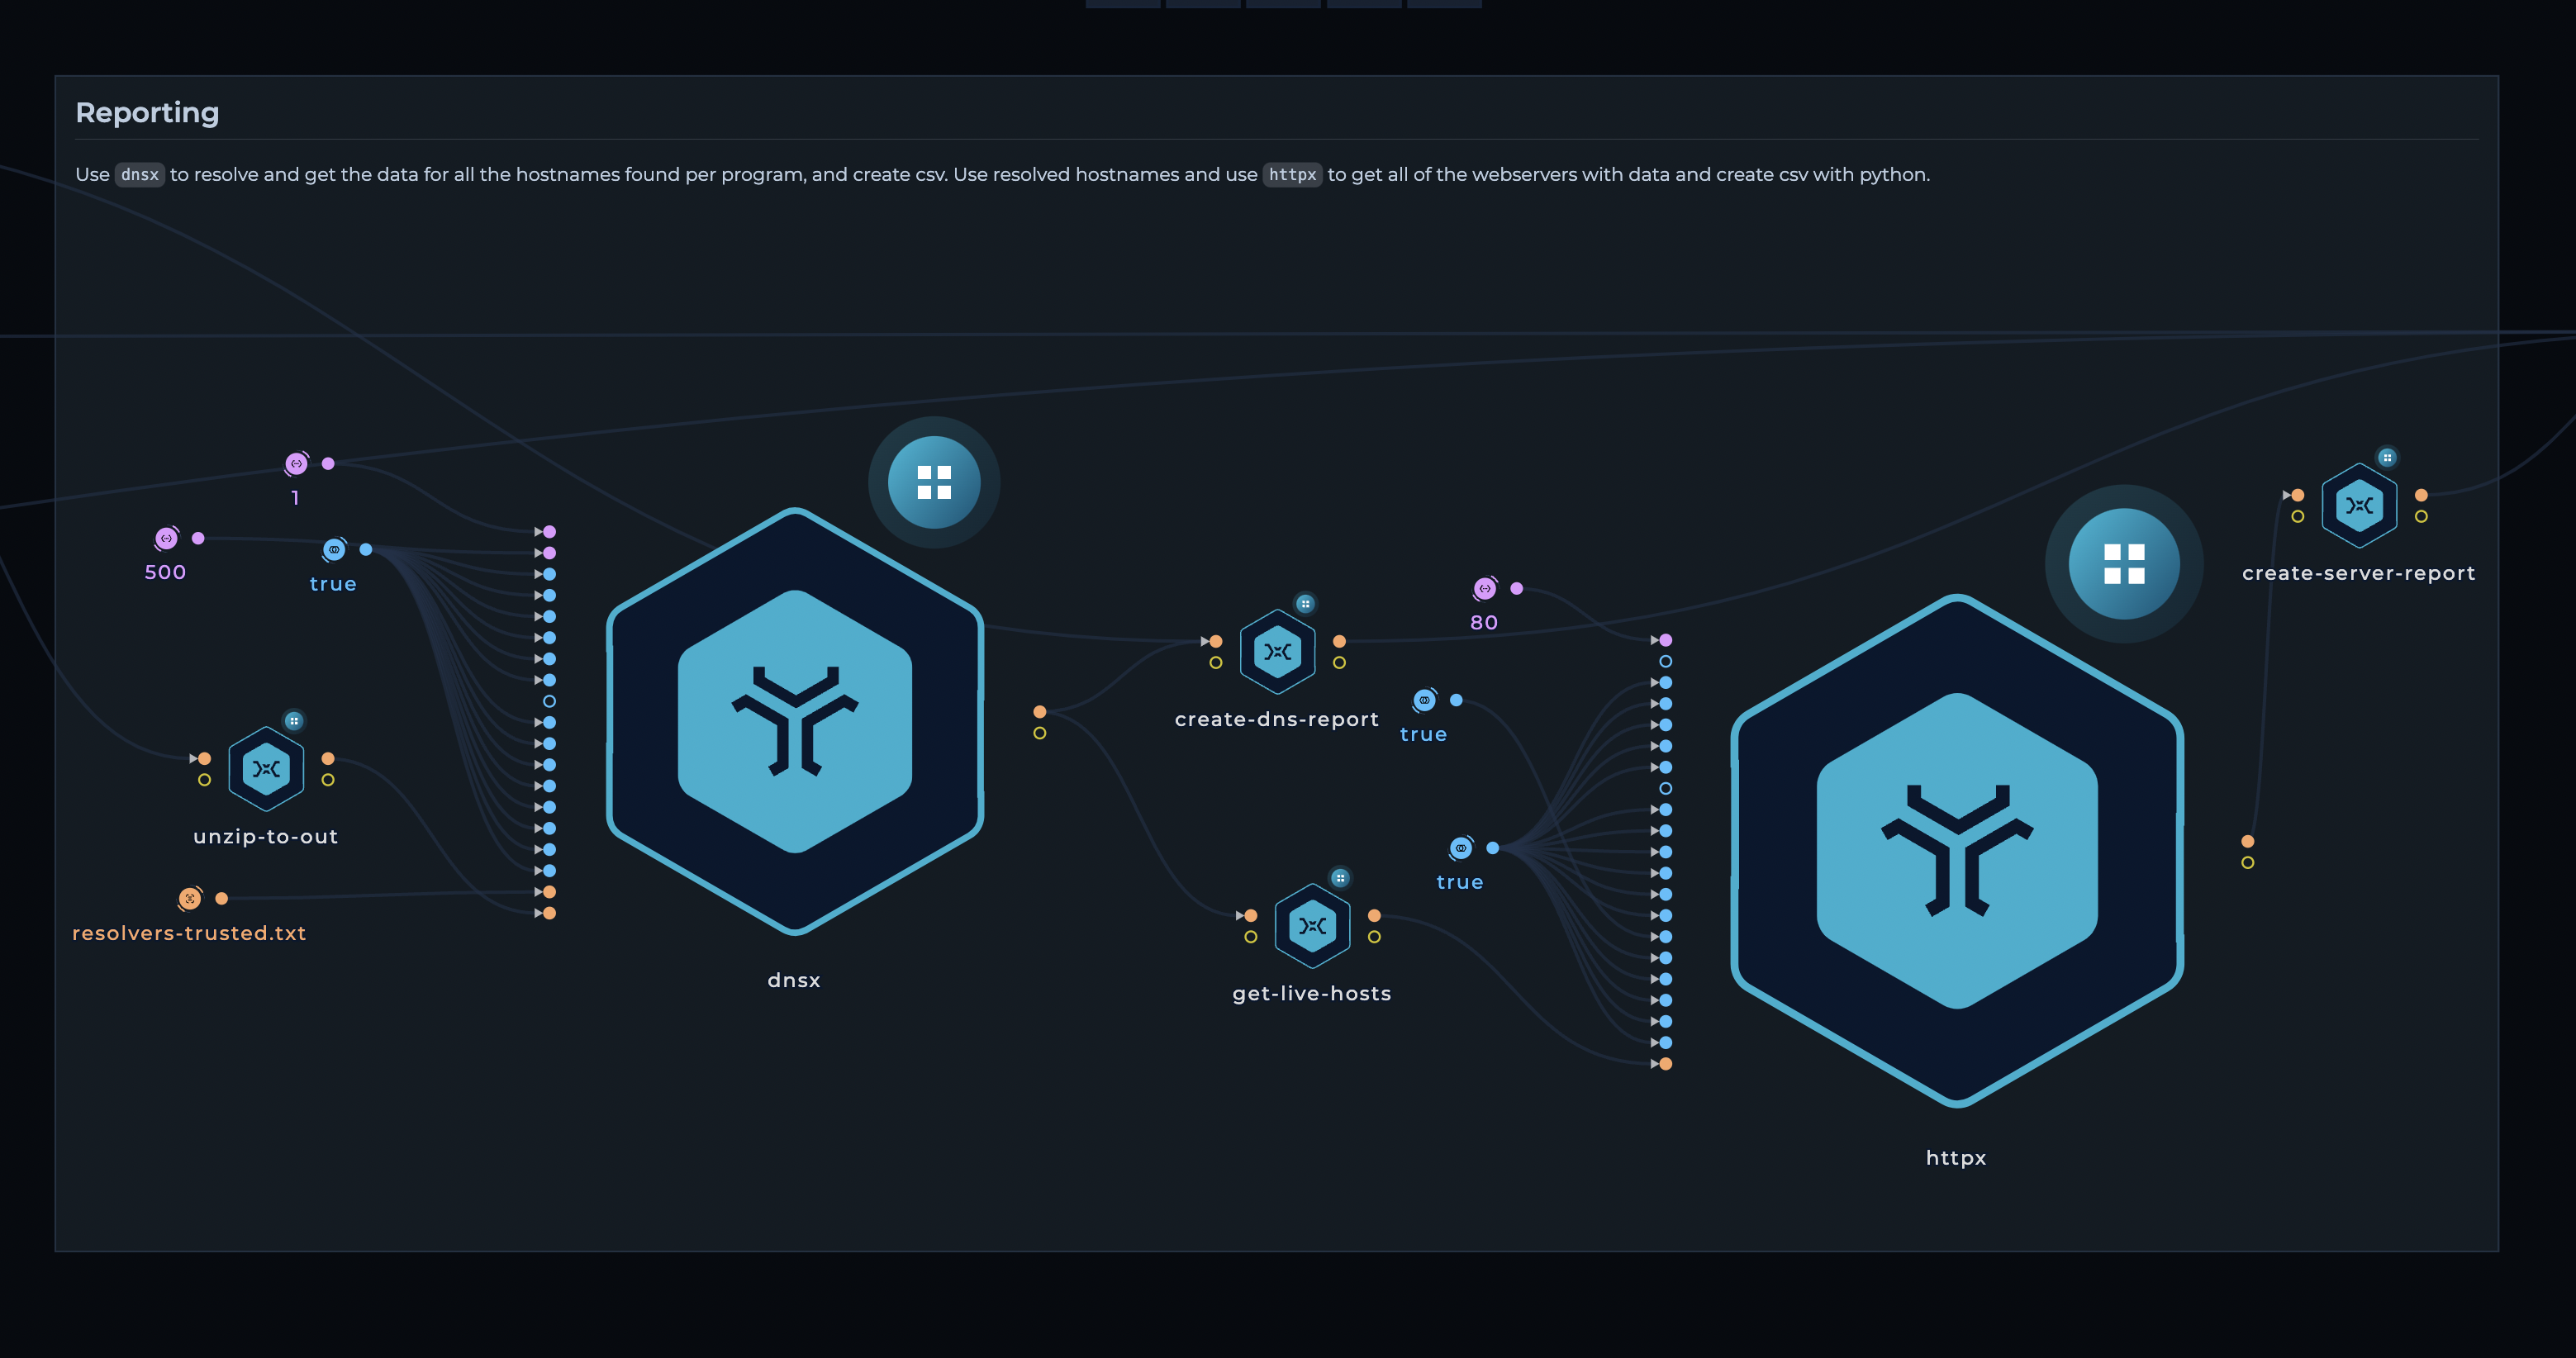
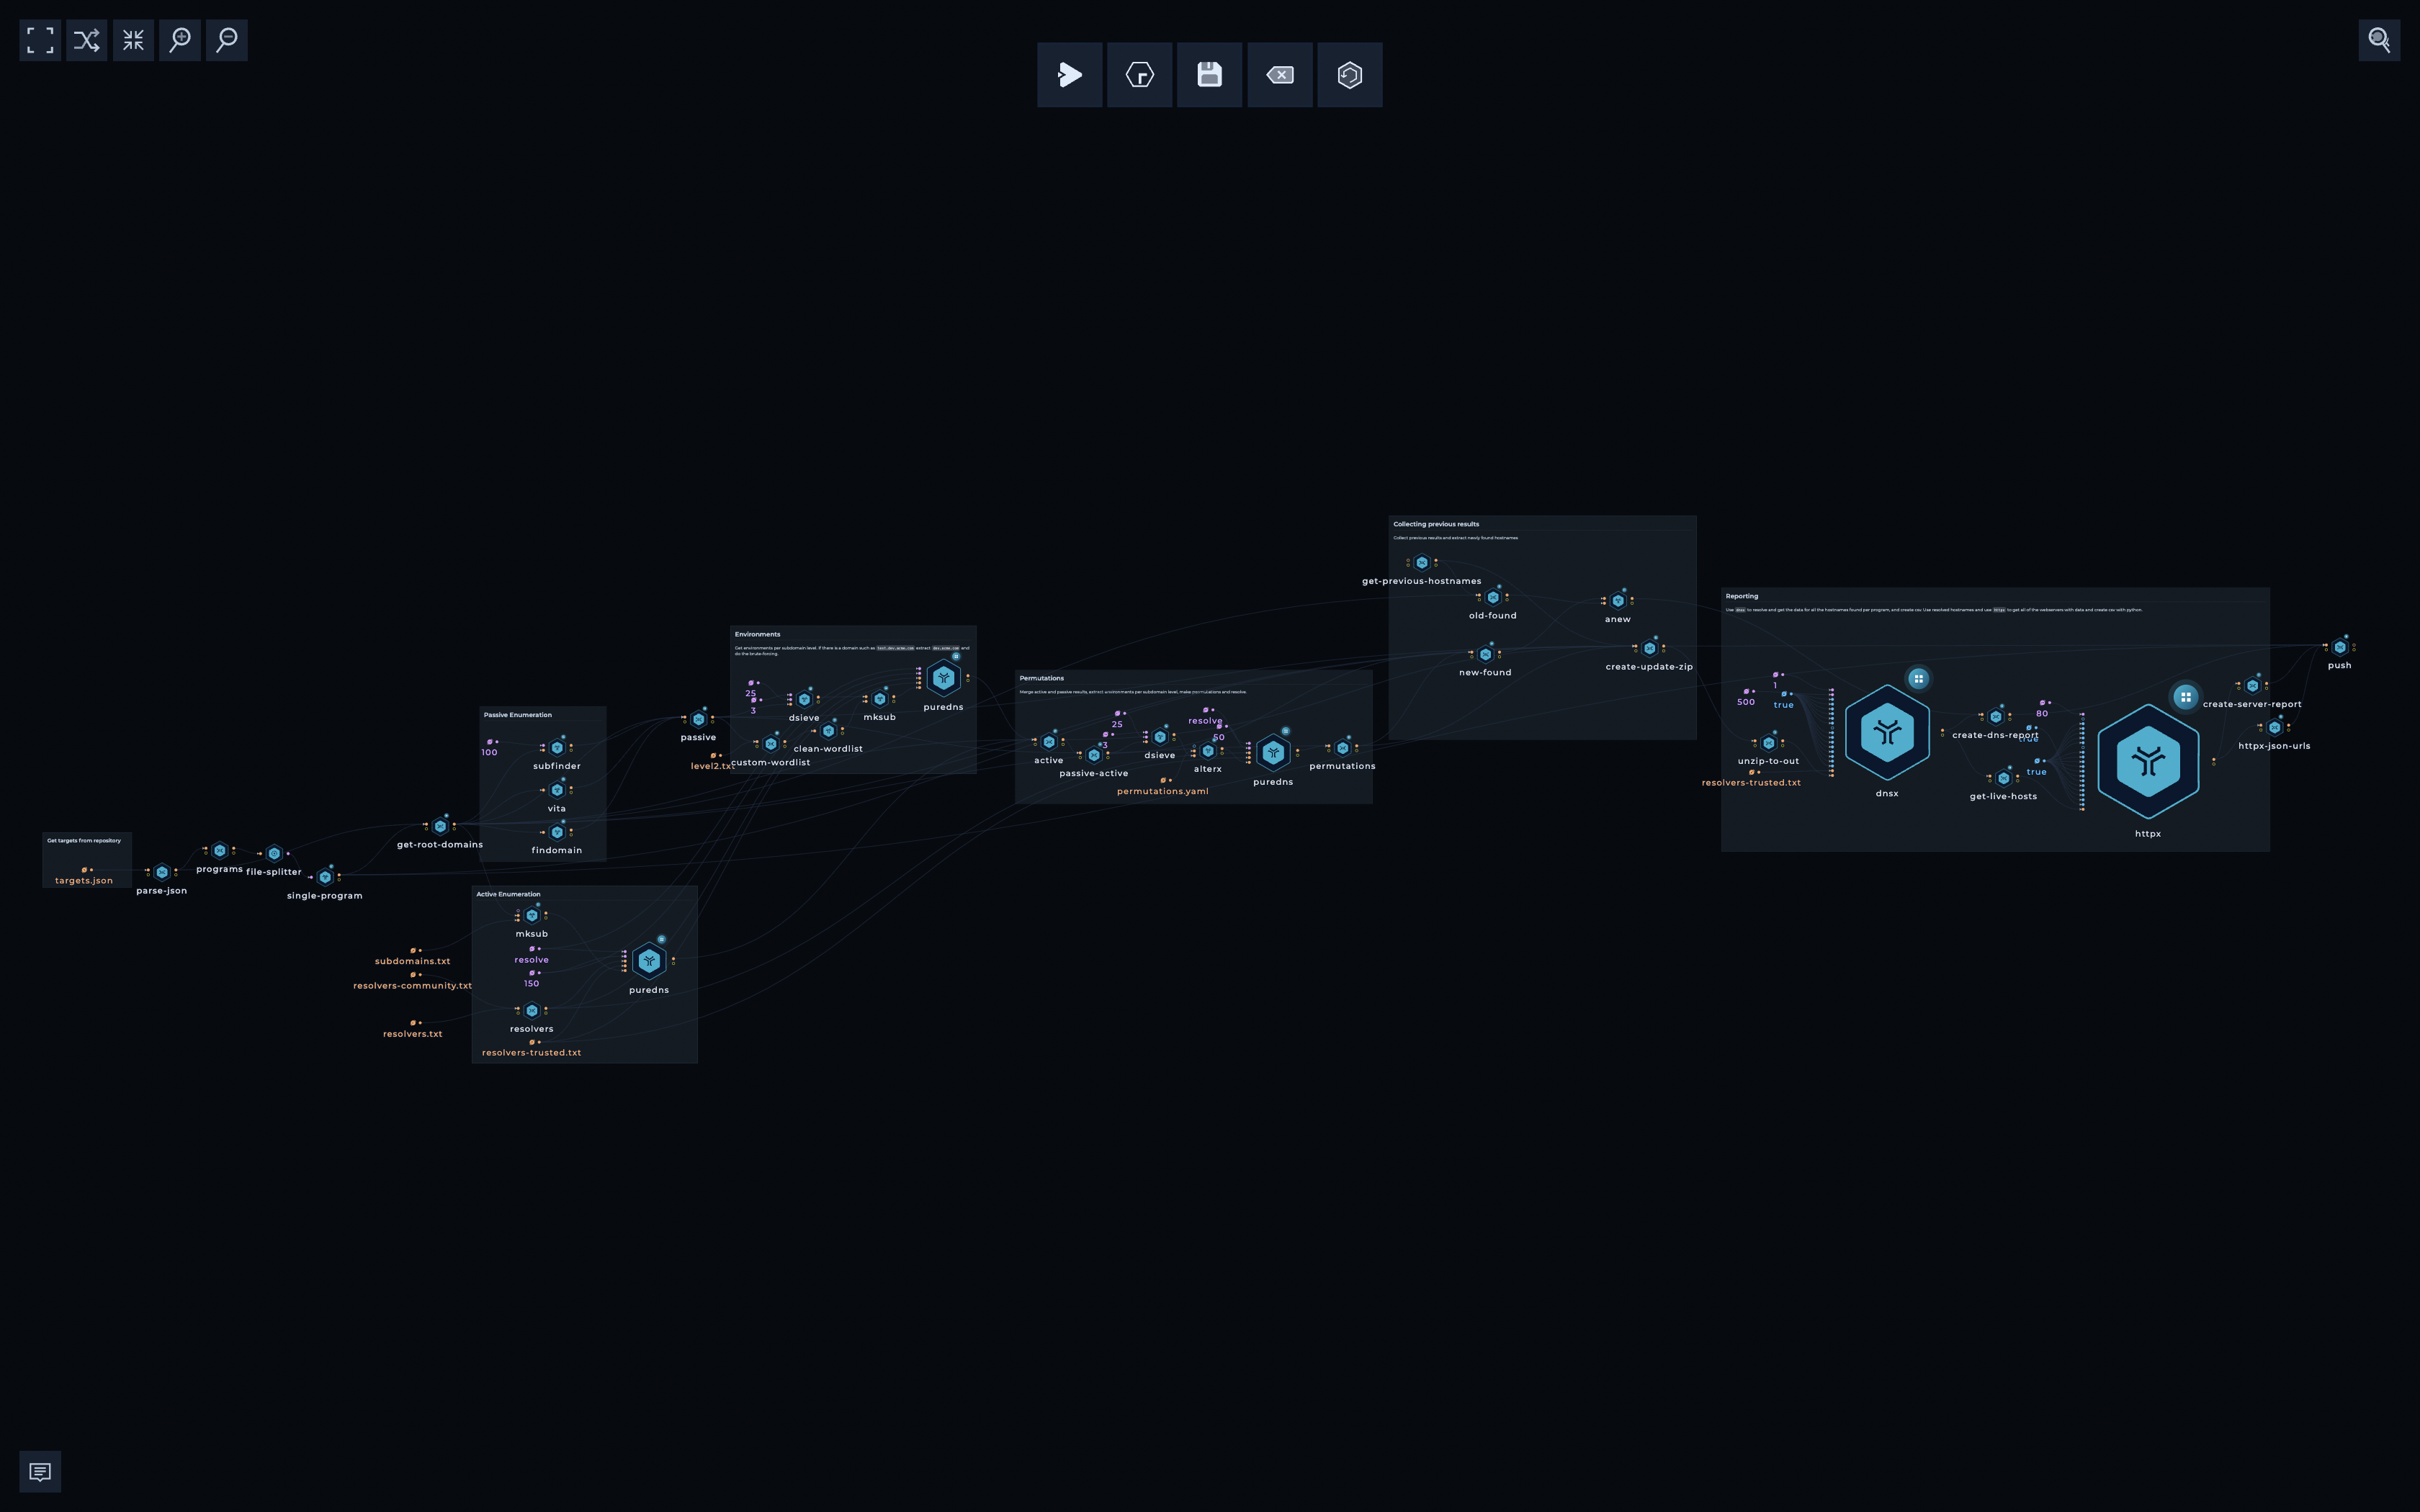
Nota: Tal como se describe, casi todo en este repositorio se genera automáticamente. Diseñamos cuidadosamente los flujos de trabajo (y seguimos desarrollándolos) para garantizar que los resultados sean lo más precisos posible.
¡Todas las contribuciones, ideas y sugerencias son bienvenidas! Si quieres añadir o editar un objetivo o flujo de trabajo, no dudes en enviarnos un PR con nuevos objetivos a través de community.json, tuitea mencionándonos @trick3st o únete a la conversación en Discord.

