 noahware/binprotect
ofuscador bin2bin para PE x64 que no añade una sección al binario

Vea 4. Compilación para obtener instrucciones de compilación.
Este ofuscador es bin2bin, lo que significa que toma un binario ejecutable ya compilado y lo reproduce aplicando los pases de ofuscación. Esto se puede usar para proteger una aplicación sin tener acceso al código fuente original. Por ahora solo se admiten archivos PE x64 (ejecutables portátiles), pero hay planes de agregar soporte para otros formatos binarios (por ejemplo, ELF) en el futuro.
Actualmente, todos los ofuscadores bin2bin conocidos insertan una sección al final del binario para colocar el código o los datos ofuscados en su interior. Esto es para que el diseño original del binario se conserve sin tener que cambiar el contenido de las secciones preexistentes. Esto es mucho más fácil de gestionar ya que mantiene la mayoría de las RVA (direcciones relativas) válidas.
Este proyecto adopta un enfoque único para bin2bin, donde cualquier código o dato ofuscado se inserta dentro de las secciones originales del binario. Esto requiere rastrear cada RVA en la aplicación. Los beneficios de este enfoque son:
Este documento describirá tanto la reescritura del binario ejecutable como las técnicas de ofuscación implementadas. Se han implementado las siguientes técnicas de ofuscación:
Además, este proyecto también tiene soporte de excepciones (excepciones de C++ y SEH) y es capaz de ofuscar funciones que tienen manejo de excepciones.
Para ayudar con el desensamblado y el descubrimiento de código en el binario, se aceptan opcionalmente archivos de símbolos (tanto PDB como MAP). Proporcionar archivos de símbolos no es obligatorio, pero ayuda con el desensamblado en binarios complejos. Algunas funciones como el soporte de excepciones y el aplanamiento de flujo de control requieren que se proporcione un archivo de símbolos.
Un reescritor binario toma un binario ejecutable y cambia el código o los datos en su interior para producir un binario de salida con los cambios aplicados.
A medida que el código ofuscado se inserta directamente en las secciones originales del binario, se deben rastrear las direcciones relativas en el programa para que todas las referencias a ellas puedan ajustarse. Esto es para que las referencias sigan apuntando a la misma ubicación después de que se haya insertado el código y los datos. De lo contrario, se accedería a datos o código en la ubicación incorrecta, lo que cambiaría el comportamiento del binario de salida y causaría una inestabilidad grave.
Cada vez que se encuentra una referencia a una dirección relativa (por ejemplo, instrucciones que contienen operandos relativos a rip o directorios de datos PE), se agrega a una lista de seguimiento para actualizarla al final de la reescritura. Se rastrea la RVA donde ocurre la referencia (para saber dónde actualizar la referencia) así como la RVA a la que se hace referencia (para saber con qué RVA actualizar la referencia).
Cada vez que el desensamblador encuentra una instrucción relativa a rip, la agrega a una lista de referencias para actualizar al final de la ofuscación. Esto asegura que todas esas instrucciones sigan apuntando a la ubicación que tenían originalmente. Otros casos de instrucciones relativas, como las tablas de saltos, también se agregan como referencias a actualizar.
Todas las RVA rastreadas deben ajustarse cada vez que se insertan o eliminan bytes del binario. Por ejemplo, aquí está el manejador de inserción de bytes:```cpp
void binwrite::binary_t::insert(const rva_t rva, const std::span data, const bool inclusive)
{
buffer_.insert_range(buffer_.begin() + rva.value(), data);
update_rvas(rva, static_cast<rva_t::size_type>(data.size()), inclusive);
}
`update_rvas` es donde se actualiza cada RVA rastreado para reflejar el cambio que ocurrió en el binario. Aquí hay un diagrama de este proceso:
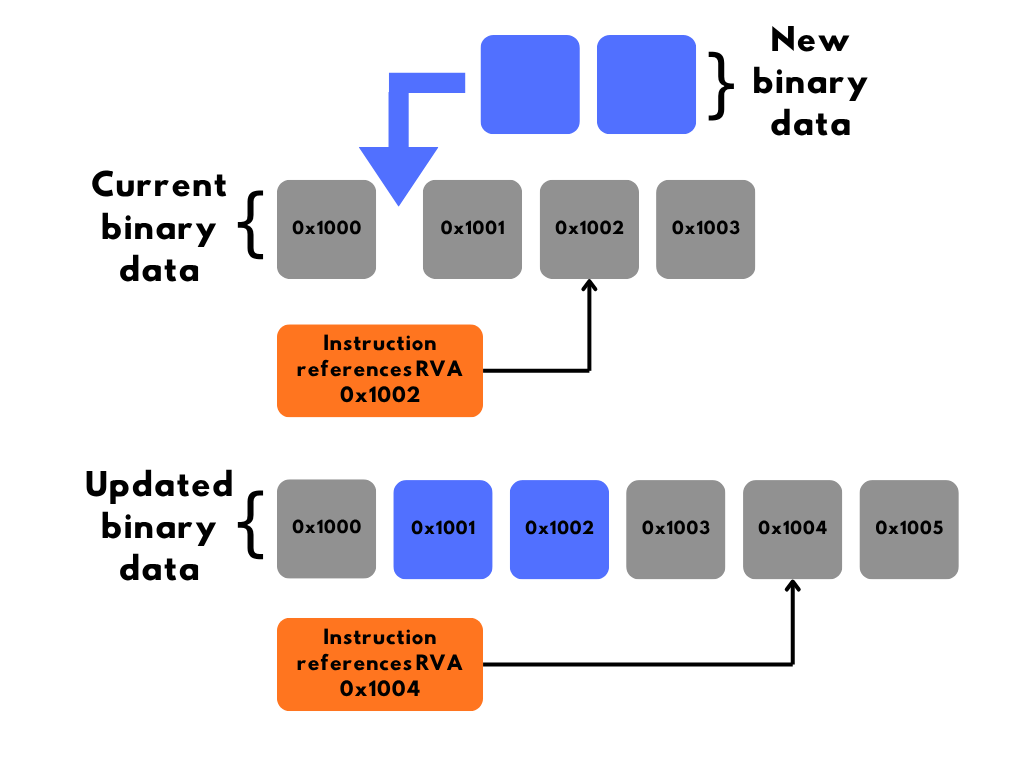
Figura 1. Seguimiento de direcciones relativas.
Los datos insertados (azul) desplazan los datos actuales (gris). El RVA referenciado por la instrucción (naranja) se actualiza para apuntar a la misma memoria, teniendo en cuenta los datos insertados (azul).
## 2.2. Desensamblaje
Todas las entradas de código potenciales (exportaciones, punto de entrada, reubicaciones que apuntan a la sección de código, etc.) se añaden a una cola de desensamblaje. Si hay un archivo de símbolos, todas las funciones descritas por dicho archivo también se añaden a la cola de desensamblaje. Cada entrada en la cola se trata como un bloque básico individual.
Un bloque básico es un grupo de instrucciones sin bifurcaciones; esto significa que termina en instrucciones de flujo de control (por ejemplo, salto, ret, int). Los bloques básicos no terminan en llamadas, ya que se espera que retornen en la mayoría de los casos. Algunas funciones no retornan (por ejemplo, _CxxThrowException) y se denominarán llamadas 'noreturn' en adelante.
Cuando se procesa un bloque básico de la cola de desensamblaje, cada instrucción se desensambla comenzando desde el inicio hasta que ocurre una de las siguientes condiciones:
- Se alcanza otro bloque básico ya analizado, lo que provoca una superposición. Consulte "División de bloques básicos".
- Se encuentra una instrucción de terminación (salto, retorno, int).
- El desensamblaje de la instrucción ha fallado.
- Se ha encontrado relleno de código.
A continuación se muestra un diagrama del desensamblaje y la entrada de la cola de desensamblaje (la verificación de relleno de código se omite en el diagrama). Esto se repite hasta que la cola de desensamblaje esté vacía.
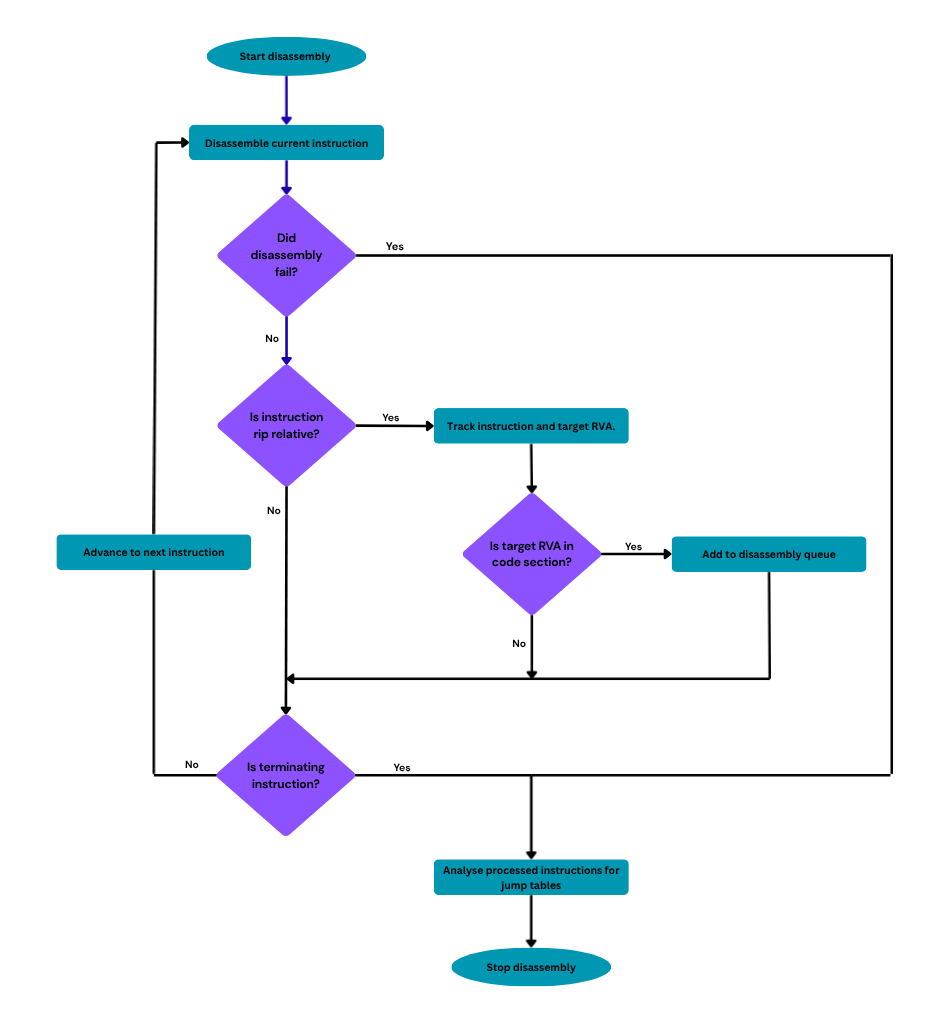
Figura 2. Procesamiento de desensamblaje.
### 2.2.1 División de bloques básicos
