 iqsec-lab/freemoca
Marco de aprendizaje continuo sin memoria para la clasificación de malware mediante interpolación basada en conectividad de modos. Admite escenarios de incremento de clases e incremento de dominios en los conjuntos de datos EMBER y Androzoo.

[!NOTE] Esta es la implementación oficial del artículo Continual Learning Trajectory as Memory for Replay-Free Consolidation in Malicious Code Analysis.
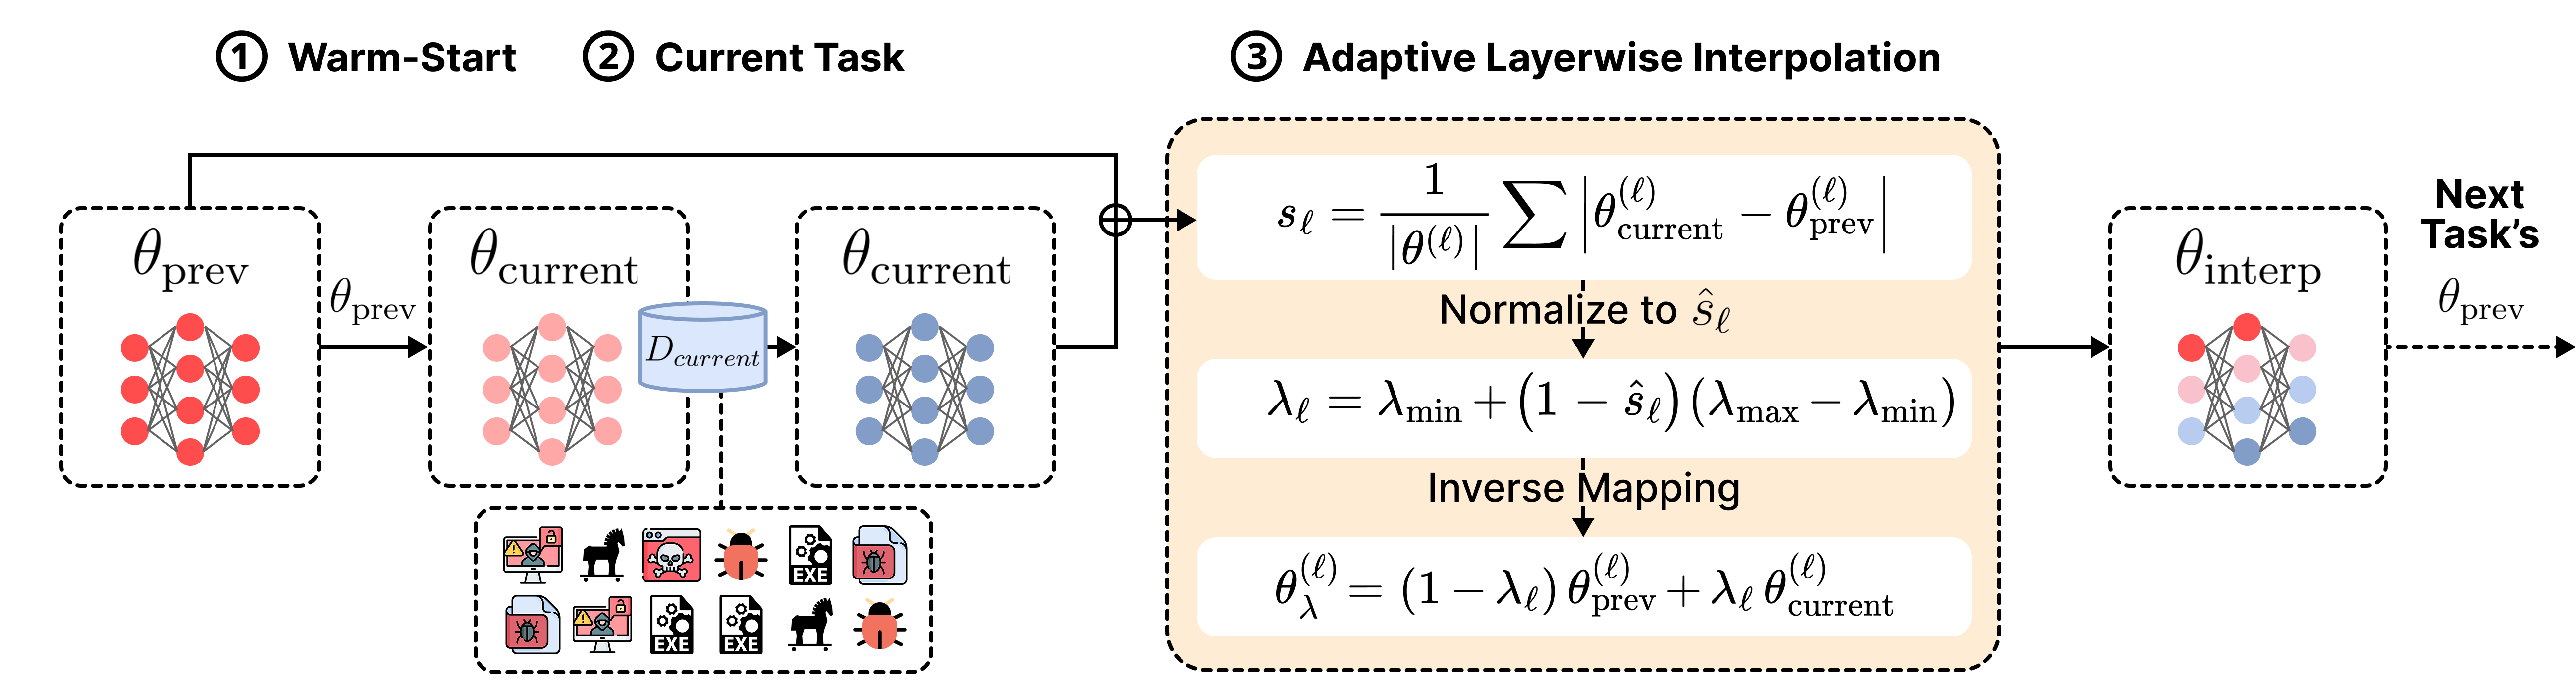
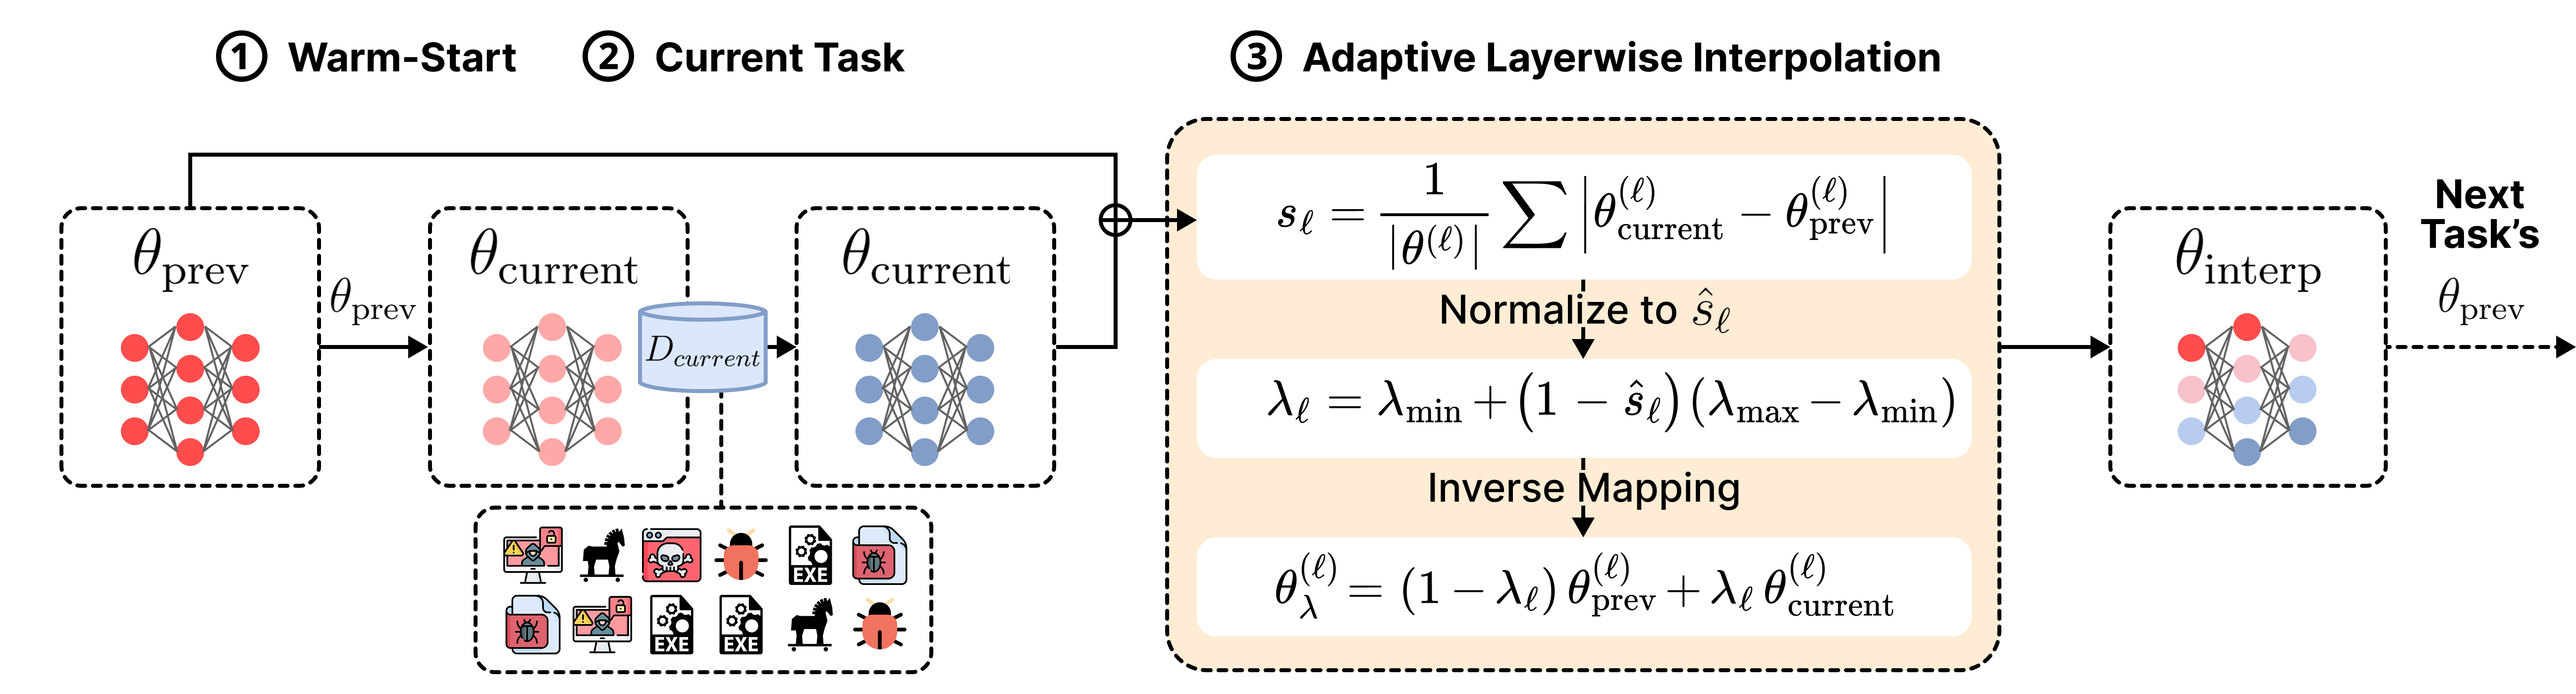
FreeMOCA opera mediante el siguiente proceso:
Todo el proceso construye una cadena de soluciones conectadas que residen en una variedad de bajo error, reduciendo significativamente el olvido catastrófico.
FreeMOCA se evaluó con dos conjuntos de datos de malware a gran escala, EMBER y Androzoo. Fuentes de los conjuntos de datos:
Descargue y configure el conjunto de datos en el siguiente directorio:
FreeMOCA/data/
├── AZ_Class
│   ├── AZ_Class_Test.npz
│   └── AZ_Class_Train.npz
│
├── AZ_Domain
│   ├── 2008_Domain_AZ_Test_Transfo...
│   ├── 2008_Domain_AZ_Train_Transfo...
│   ├── 2009_Domain_AZ_Test_Transfo...
│   └── ...
│
├── EMBER_Class
│   ├── XY_test.npz
│   └── XY_train.npz
│
└── EMBER_Domain
    ├── 2018-01
    ├── 2018-02
    ├── 2018-03
    └── ...
Este repositorio admite dos escenarios de aprendizaje continuo:
Ejecute el siguiente comando para el
conda create -n freemoca python=3.9
conda activate freemoca
pip install -r requirements.txt
# EMBER Class-IL
cd ./FreeMOCA_Class/EMBER_Class
CUDA_VISIBLE_DEVICES=0 python main.py --train_data /path/to/data --test_data /path/to/data
# AZ Class-IL
cd ./FreeMOCA_Class/AZ_Class
CUDA_VISIBLE_DEVICES=0 python main.py --train_data /path/to/data --test_data /path/to/data
# EMBER Domain-IL
cd ./FreeMOCA_Domain/EMBER_Domain
CUDA_VISIBLE_DEVICES=0 python main.py --data_root /path/to/data/directory
# AZ Domain-IL
cd ./FreeMOCA_Domain/AZ_Domain
CUDA_VISIBLE_DEVICES=0 python main.py --data_root /path/to/data/directory
Para una configuración más detallada de los hiperparámetros, consulte el Apéndice A. Argumentos comunes para FreeMOCA.
Para ajustar los hiperparámetros o la configuración experimental, utilice los siguientes argumentos:
| Argumento | Descripción |
|---|---|
--init_classes | Número de clases en la tarea 0 |
--epochs | Épocas por tarea |
--batchsize | Tamaño del lote |
--lr | Tasa de aprendizaje |
--momentum | Momento de SGD |
--weight_decay | Decaimiento de pesos |
--lambda_min | Peso mínimo de interpolación |
--lambda_max | Peso máximo de interpolación |
Para cambiar la configuración predeterminada de los argumentos, consulte el archivo arguments.py.
Nuestro repositorio admite experimentos con las siguientes líneas base estándar:
Puede ejecutarlo con el siguiente comando:
cd /path/to/experiment/directory
CUDA_VISIBLE_DEVICES=0 python none.py --arugment_you_want
CUDA_VISIBLE_DEVICES=0 python joint.py --arugment_you_want
y siguiendo trabajos previos:
Puede ejecutar las líneas base con el siguiente comando:
# CLeWI for EMBER-Class
cd ./baselines/CLeWI
CUDA_VISIBLE_DEVICES=6 python main.py --model="clewi" \
  --dataset="seq_ember" --n_tasks=11 \
  --lr=0.001 --buffer_size=500 --n_epochs=50 \
  --seed=42 --optim_wd=0.0 --optim_mom=0.0 \
  --batch_size=512 --sub_dataset="ember"

# CLeWI for AZ-Class
cd ./baselines/CLeWI
CUDA_VISIBLE_DEVICES=6 python main.py --model="clewi" \
  --dataset="seq_ember" --n_tasks=11 \
  --lr=0.001 --buffer_size=500 --n_epochs=50 \
  --seed=42 --optim_wd=0.0 --optim_mom=0.0 \
  --batch_size=512 --sub_dataset="az"
# WSC for EMBER-Class
cd ./baselines/WSC
MODEL_NAME=wsc_20_ember
python main.py --config=./exps/wsc_memory/$MODEL_NAME.json
# WSC for AZ-Class
cd ./baselines/WSC
MODEL_NAME=wsc_20_az
python main.py --config=./exps/wsc_memory/$MODEL_NAME.json
# GR for EMBER-Class
cd ./baselines/GR_EWC_LwF_iCaRL_EMBER
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=EMBER --tasks=11 --replay=generative --metrics --logger_file gr --scenario=class

# GR for AZ-Class
cd ./baselines/GR_EWC_LwF_iCaRL_AZ
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=ANDROZOO --tasks=11 --replay=generative --metrics --logger_file gr --scenario=class
# EWC for EMBER-Class
cd ./baselines/GR_EWC_LwF_iCaRL_EMBER
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=EMBER --tasks=11 --ewc --lambda=50 --metrics --logger_file ewc --scenario=class
