es0j/execaslr-ekoparty
Exploit de prueba de concepto que evade ASLR en CPUs de Intel abusando del branch target buffer y de la ejecución especulativa para filtrar direcciones aleatorizadas mediante un canal lateral.

Address Space Layout Randomization es una mitigación utilizada para dificultar la explotación de ataques de corrupción de memoria. En un escenario de vulnerabilidad de desbordamiento de búfer, por ejemplo, un atacante que intenta realizar un exploit de Programación Orientada a Retorno necesita conocer las direcciones de los gadgets en la cadena. Si el segmento de código del binario explotado está aleatorizado, entonces es mucho más difícil para un atacante elegir la dirección correcta para el exploit, haciendo la explotación inviable.
El siguiente ejemplo muestra cómo se aleatoriza una dirección:
#include <stdio.h>
void DoNothing();
void (*codePtr)() = DoNothing;

void DoNothing(){}

int main(int argc,char **argv){

    printf("Destination %p\n",codePtr);
    DoNothing();
}
Cada ejecución el valor se aleatoriza:
Destination 0x563714256149
Destination 0x556d8e2f1149
Destination 0x5618c8bdd149
Destination 0x55ee623b0149
Los últimos 12 bits 149 son siempre los mismos, pero la ubicación de la función puede estar aproximadamente en cualquier lugar entre 0x550000000000 y 0x570000000000, lo que significa que 29 bits están aleatorizados, ocupando un espacio de direcciones posible de 0x200 0000 0000 o 2.2 TB de tamaño.
El procesamiento de cada instrucción es una tarea compleja. Algunas etapas del procesamiento de una sola instrucción son:
Para aumentar el rendimiento de las instrucciones en la CPU, cada tarea de la instrucción es realizada por una unidad específica del procesador. Con todas las unidades trabajando en paralelo, la CPU puede ejecutar a velocidades de reloj mucho más altas; esa es la idea de un pipeline.
| Operación \ ciclo de reloj | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| Captación | A | B | C | ||
| Decodificación | A | B | C | ||
| Ejecución | A | B | C |
Ejecución de las instrucciones A, B y C a lo largo de los ciclos 1-5. En el ciclo 3, por ejemplo, las unidades de lectura, decodificación y ejecución están activas simultáneamente
Sin embargo, las instrucciones no son completamente independientes entre sí. Por ejemplo, la siguiente secuencia:
A. add ax,[bx]
B. jz $+1
C. mov dl,[rsi]
D. nop
En este caso, la instrucción A, en el mejor de los casos, solo terminará en el ciclo 3 en la ejecución. Sin embargo, la unidad de captación necesita decidir cuál es la siguiente instrucción a captar de la memoria, si la instrucción C (mov dl,[rsi]) debe omitirse.
En este escenario, la CPU tiene la opción de esperar a que la instrucción A termine, lo que solo ocurrirá en el tercer ciclo de reloj, para luego captar la instrucción correcta de la memoria, si la operación add devuelve 0, por ejemplo:
| Operación \ ciclo de reloj | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Captación | A | B | D | |||
| Decodificación | A | B | D | |||
| Ejecución | A | B | D |
Eso implica un retraso en el pipeline porque la CPU debe esperar a que la instrucción se ejecute. En este ejemplo, el retraso es un solo ciclo de reloj, pero la instrucción add ax,[bx] requiere una operación de memoria que, como se vio antes, puede tomar hasta cientos de ciclos en completarse, lo que conlleva un costo de rendimiento significativo para el procesador.
Una opción más rápida sería intentar "adivinar" la ruta de ejecución correcta. La CPU puede especular si la bifurcación se toma o no. Después de ese punto, la ejecución continúa desde la ruta especulada y los valores solo se confirman si la ruta se demuestra correcta después de que termine la instrucción A. Si la ruta se demuestra incorrecta, los resultados se descartan y el estado se revierte al punto anterior a la especulación.
| Operación \ ciclo de reloj | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Captación | A | B | (S) C | |||
| Decodificación | A | B | (S) C | |||
| Ejecución | A | B | (S) C |
El único problema al revertir la ruta tomada es que el estado microarquitectónico de la CPU no se puede revertir. Entonces, si la CPU especula ejecutar la instrucción C (mov dl,[rsi]), los datos apuntados por rsi se moverán a la caché. Este efecto se puede medir más tarde usando un ataque de canal lateral.
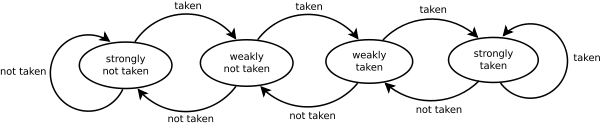
Predictor condicional de 2 bits. https://en.wikipedia.org/wiki/Branch_predictor
No solo deben predecirse las instrucciones condicionales, sino también las bifurcaciones indirectas. La CPU debe tener un mecanismo para adivinar los destinos de una instrucción como call [rdi].
La vulnerabilidad Spectre v2 muestra que es posible explotar el predictor indirecto para lograr ejecución transitoria en otros procesos:
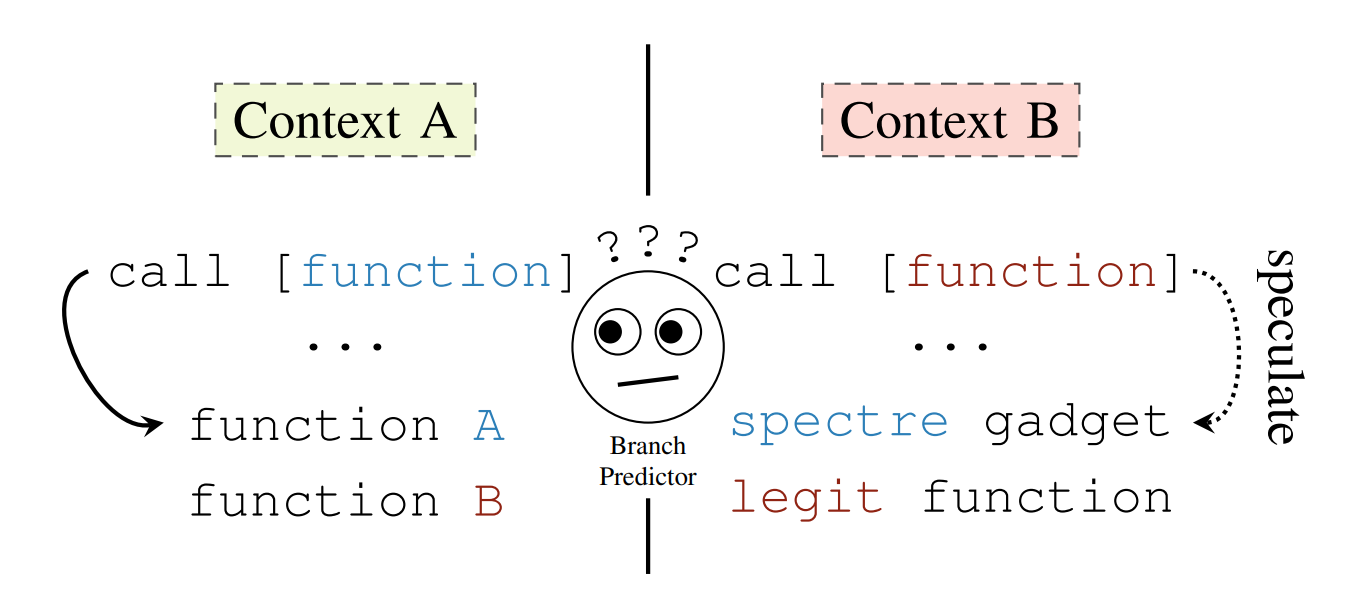 Extraído de https://spectreattack.com/spectre.pdf
Al colocar una instrucción call en el contexto A en la misma dirección virtual que otra call en el contexto B, el atacante puede entrenar a la CPU para que ejecute código en una posición elegida por el atacante en el contexto B, en un ataque de reutilización de código, similar a la Programación Orientada a Retorno (ROP).
La víctima objetivo debe tener una pieza de código conocida como "spectre gadget" que sea capaz de filtrar un secreto mediante un ataque de canal lateral. Para que un ataque Spectre tenga éxito, el atacante también debe conocer la ubicación del spectre gadget. Por lo tanto, en ataques usuario-usuario, proteger a la víctima con ASLR solía ser una mitigación para este tipo de ataque. Sin embargo, también existen técnicas para extraer ASLR mediante ataques microarquitectónicos como Jump Over ASLR. No obstante, esta técnica tiene algunas limitaciones sobre la cantidad de bits filtrados, ya que se basa en colisiones en el predictor directo para evadir ASLR.
Los mecanismos internos de este predictor se muestran a continuación:
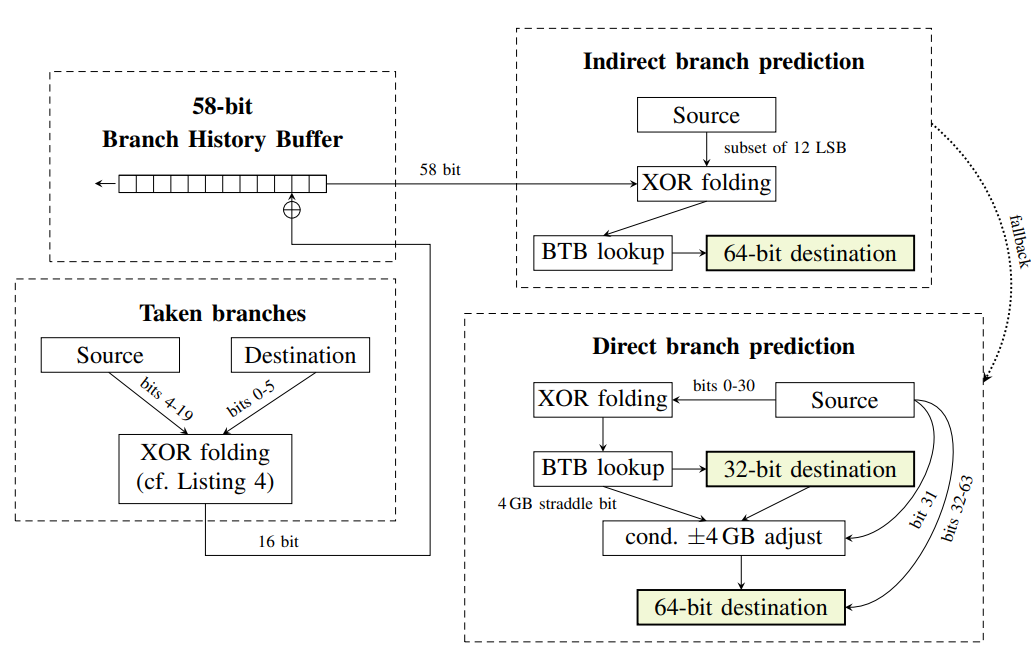
Extraído de https://spectreattack.com/spectre.pdf
Algunos de estos componentes son:
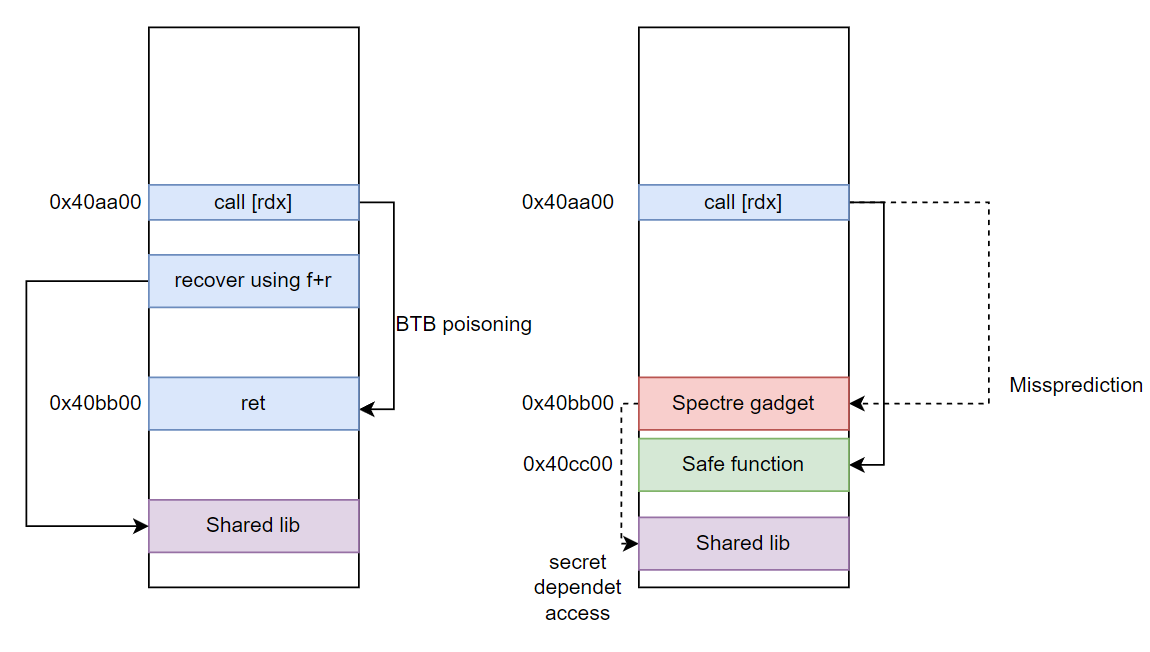
El diseño clásico del ataque Spectre v2 se ve así: