
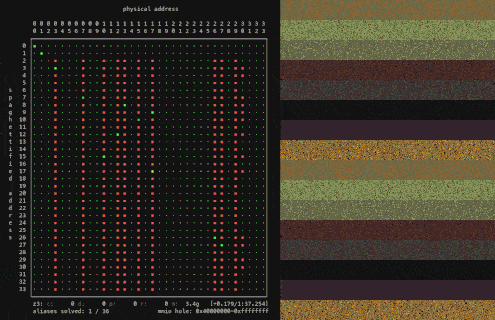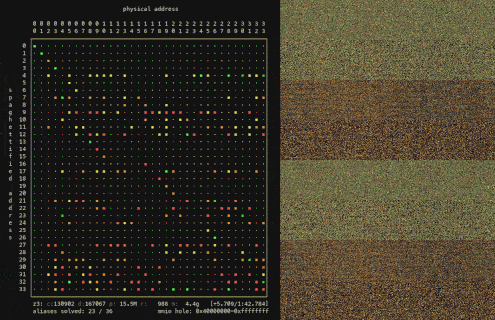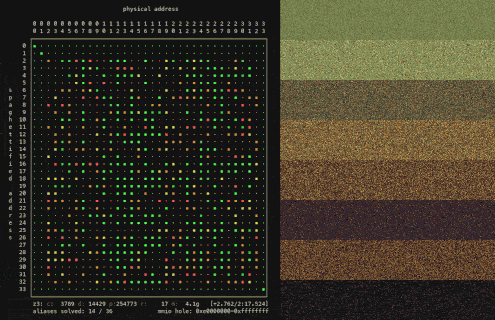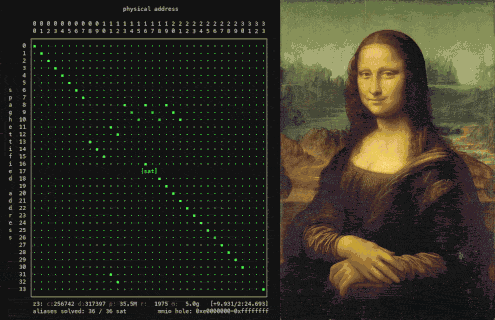
skitter-creek-bath-salts — Actualizado!
Desbloqueando _todo_ en la CPU con DRAM scrambling
skitter-creek-bath-salts
Desbloqueando todo en la CPU con el scrambling de DRAM — PSP, C6, microcódigo, SMM, y cualquier otra cosa que las especificaciones omitieron.
&x == &x.
Normalmente.
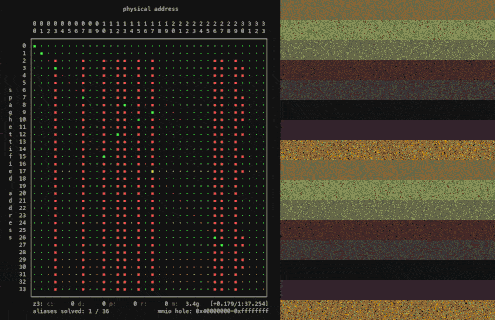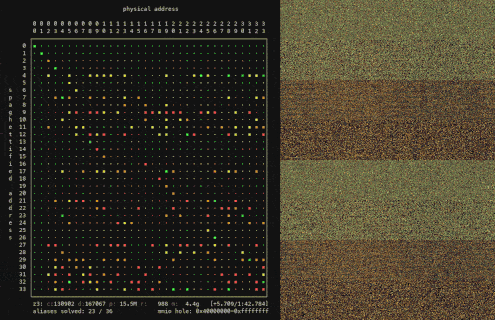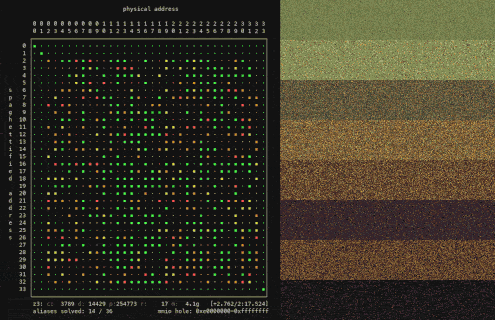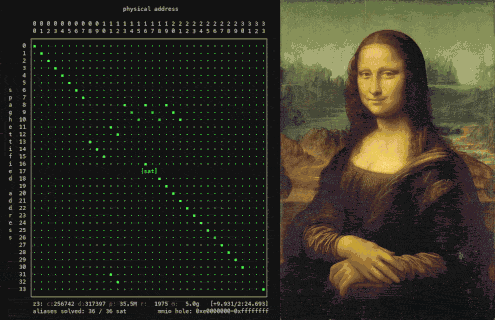
Manipula el controlador de DRAM y una dirección puede terminar donde quieras en
la memoria. skitter-creek-bath-salts modifica las capas inferiores de la
jerarquía de memoria para recablear las traducciones de direcciones físicas de
la DRAM. Esto altera la memoria de la plataforma, exponiendo regiones protegidas
de la DRAM — reservas invisibles incluso para el kernel. Cuando las traducciones
de direcciones se rompen, también lo hacen las primitivas de seguridad
construidas sobre ellas, y desbloqueamos todo.
TL;DR
- Desbloquea tu Platform Security Processor
- Desbloquea el System Management Mode
- Desbloquea la DRAM C6
- Desbloquea el microcódigo de tu CPU
Objetivo
Desarrollado y probado en CPUs AMD Family 16h, la última generación cuyas
hojas de datos documentan los registros de traducción del controlador de DRAM —
y muestran que no pueden bloquearse. 17h y posteriores simplemente omiten esta
información. La odisea de *p es similar entre
generaciones y arquitecturas, y las transformaciones subyacentes se extienden
incluso a ARM, RISC-V y más allá; skitter-creek-bath-salts nos muestra
solo cómo empezar.
La odisea de *p
Es un largo camino hacia abajo.
La memoria está construida sobre capas de abstracción tan profundas que se
vuelven casi absurdas. Cuando tu código desreferencia *p, parece acceder a la
DRAM en p. No lo hace — p es una dirección virtual, y antes de que se toque
un solo bit de DRAM, debe sobrevivir al calvario que se describe a continuación:```
── CPU core / MMU ─────────────────────────────────────────────────
┌─ VA ← 64-bit virtual address from load/store
│
└> canonical-form check ──────────────────────┐ ← bits [63:48] sign-extend from bit 47
┌─ segment base add <─────────────────────────┘ ← FS.base / GS.base (MSR_FS_BASE, MSR_GS_BASE)
│
└> TLB probe ─────────────────────────────────┐ ← tagged by PCID (host) / VPID (guest)
hit → physical address k │
miss → engage hardware page walker │
┌─ page walk (from CR3) <─────────────────────┘ ← walked only on TLB miss
│ PML5[VA 56:48] ← only if CR4.LA57
│ PML4[VA 47:39]
│ PDPT[VA 38:30] ← 1 GiB leaf possible
│ PD [VA 29:21] ← 2 MiB leaf possible
│ PT [VA 20:12]
│ PTE ← R/W · U/S · NX · A/D · PAT · PCD · PWT · G
│
└> per-level checks ──────────────────────────┐ ← evaluated at every level of the walk
privilege (U/S) │ ← CPL vs PTE.U/S
write (R/W) │ ← + CR0.WP
execute (NX) │ ← EFER.NXE
SMEP / SMAP │ ← CR4.SMEP · CR4.SMAP · EFLAGS.AC
protection keys │ ← PKRU (user) · IA32_PKRS (supervisor)
┌─ A/D bit update <───────────────────────────┘ ← locked RMW on PTE
│
└> if guest: EPT / NPT re-walk ───────────────┐ ← each guest-PA above re-walked
EPT-PML4 → EPT-PDPT → EPT-PD → EPT-PT │ ← + EPT memory-type override
⇒ ~5× walks per single guest walk │
┌─ TLB shootdown IPIs <───────────────────────┘ ← invlpg broadcast to peer vCPUs
│
│ ── IOMMU (chipset / I/O fabric) ──────────────────────────────────
│
└> if device-initiated, IOMMU page walk ──────┐ ← VT-d / AMD-Vi: device-ID → domain → tables
│
┌── physical address k <─────────────────┘
│
│ ── CPU core / MMU — memory-type resolution ────────────────────────
│
└> MTRR range match ──────────────────────────┐ ← IA32_MTRR_DEF_TYPE + fixed/variable MTRRs
┌─ PAT entry select <─────────────────────────┘ ← IA32_PAT[ PTE.PAT:PCD:PWT ]
│
└> effective memory type ─────────────────────┐ ← { WB, WT, WC, WP, UC-, UC }
│
── CPU uncore — caches & coherence ────────────────────────────────
│
┌─ L1-D probe <───────────────────────────────┘ ← VIPT, per-core
│
└> L2 probe ──────────────────────────────────┐ ← per-core / per-CCX
┌─ LLC probe + directory consult <────────────┘ ← shared, sliced
│
└> snoop / coherence ─────────────────────────┐ ← MESI / MOESI broadcast
intra-socket │ ← broadcast to peer cores
inter-socket │ ← QPI · UPI · Infinity Fabric · CXL.cache
home-node directory response │ ← data | intervention | abort
│
── system data fabric / interconnect ──────────────────────────────
│
┌─ if MMIO range or sub-4 GiB MMIO hole <─────┘ ← uncore/data fabric posted/non-posted txn
│ → device BAR; done
│
└> else DRAM-bound: data fabric / mesh ───────┐ ← AMD DF · Intel mesh-or-ring uncore
│
┏━━ ── MCT / IMC (memory controller) ────────────────────────────────
W ┃ ┌─ DRAM hole remap <──────────────────────────┘ ← high-memory remap above TOM
E ┃ │
┃ └> memory-region exclusion remap ─────────────┐ ← reserved / protected ranges
┃ ┌─ channel interleave hash <──────────────────┘ ← XOR of selected PA bits → channel
A ┃ │
R ┃ └> rank interleave hash ──────────────────────┐ ← XOR of selected PA bits → rank
E ┃ ┌─ bank interleave hash <─────────────────────┘ ← XOR of selected PA bits → bank
┃ │
┃ └> bank swizzle / XOR scramble ───────────────┐ ← vendor- and BIOS-configurable
H ┃ ┌─ chip-select normalize (DCT) <──────────────┘ ← per-rank CS line
E ┃ │ rank → CS map
R ┃ │
E ┃ └> sub-channel select ────────────────────────┐ ← DDR5 / LPDDR5 only
┗━━ │
│
DRAM coordinates <─────────────────────────┘ ← bank group · bank · row (RAS) · column (CAS)
Este proyecto trabaja en los niveles más profundos del pipeline `*p`, la capa MCT/DCT
— donde una dirección física proveniente del data fabric/interconnect entra en el controlador
de memoria y se reescribe una última vez en las coordenadas DRAM en bruto que se
emiten al DIMM.

---

## Espaguetizando la DRAM

> Las direcciones físicas son en realidad más una sugerencia.```nasm
xor dword [0xf80c2094], 0x00400000
Ese es el exploit. Todo él.