#1
Herramientas de crawling web, scraping, spidering y reconocimiento automatizado para pruebas de seguridad.
Recomendado por Kitploit
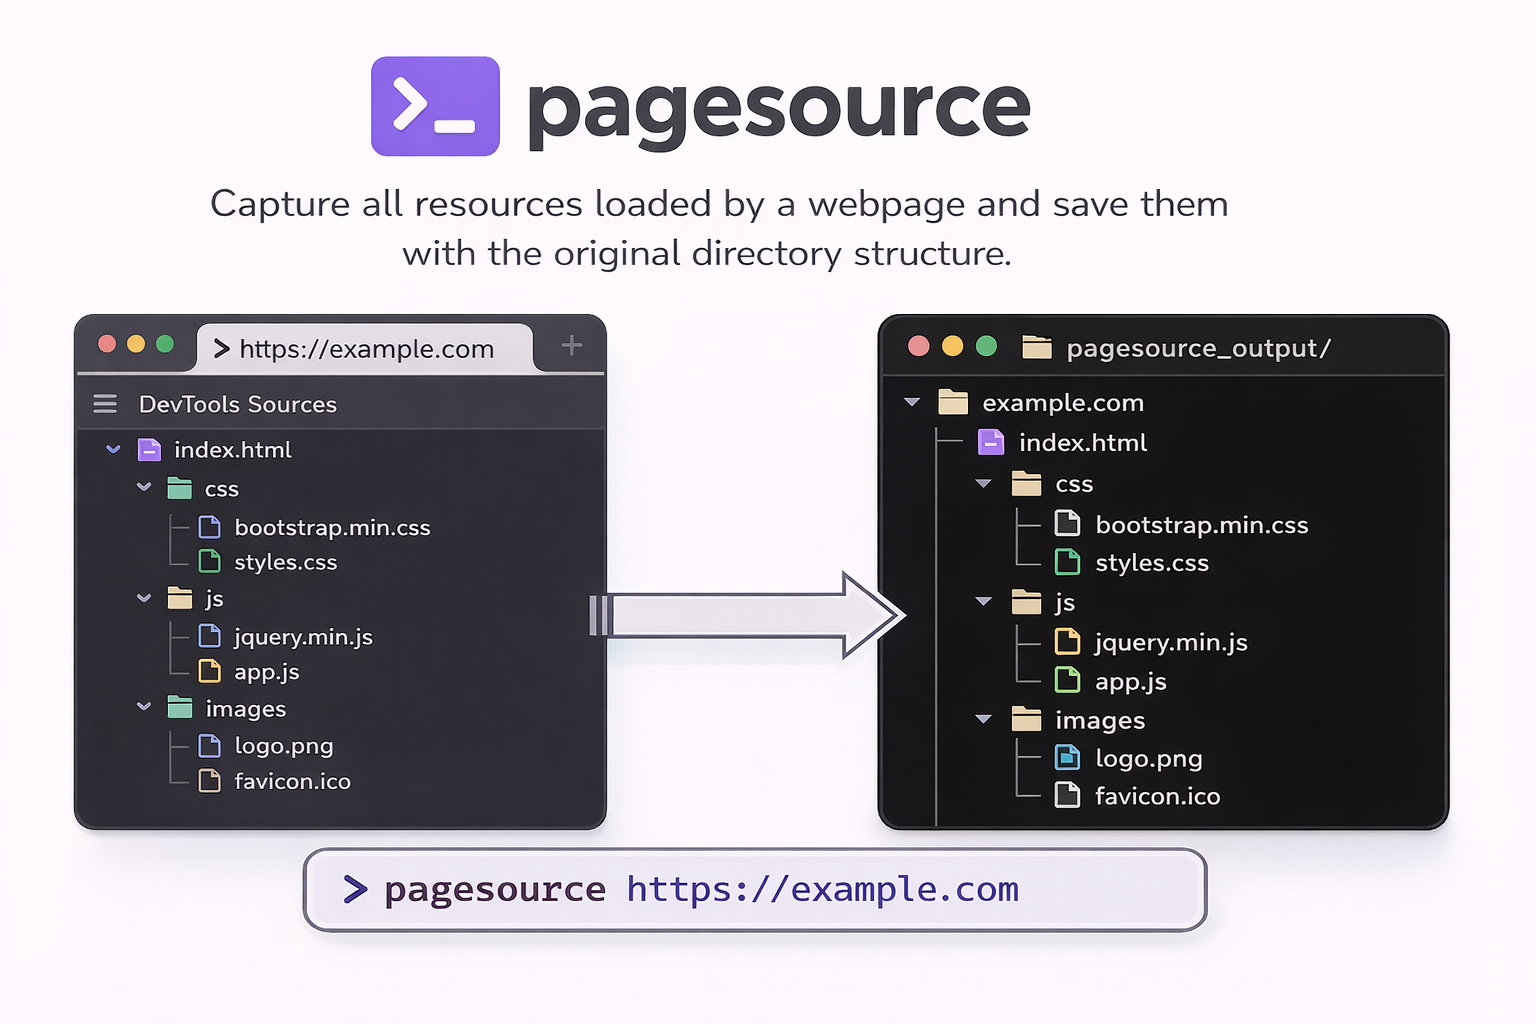
 timf34/pagesource
CLI para descargar los JS/CSS/assets reales de los sitios web (no HTML aplanado)
 dgtlmoon/changedetection.io
La mejor y más sencilla herramienta para la detección de cambios en sitios web, la monitorización de páginas web y las alertas de cambios en sitios…
 mthbernardes/fses
Fucking Search Engines Scraper - biblioteca de Python para extraer URLs de motores de búsqueda
 3radiance/mitm-proxy-ja3-ja4
Proxy MITM HTTP configurable en Rust con suplantación de huellas TLS, HTTP/2 y TCP.
 ge0rg3/requests-ip-rotator
Una biblioteca de Python para utilizar el gran grupo de IPs de AWS API Gateway como proxy y generar IPs pseudo-infinitas para web scraping y ataques…
 hackmanit/web-cache-vulnerability-scanner
Escáner CLI basado en Go para envenenamiento de caché web y engaño. Soporta 10 técnicas de envenenamiento, múltiples métodos de engaño, rastreador…
 dedsecinside/torbot
Rastrea sitios .onion a través de Tor para recopilar títulos de páginas, nombres de host y relaciones de enlaces, exportando árboles JSON y…
 ultrafunkamsterdam/nodriver
Sucesor de Undetected-Chromedriver. Proporciona un framework ultrarrápido para automatización web, web scraping, bots y cualquier otra idea creativa…
 seladb/pcapplusplus
Biblioteca C++ multiplataforma para captura, análisis, creación y procesamiento de paquetes de red de alto rendimiento. Compatible con libpcap, DPDK,…
 emrekybs/signalops
Panel de fusión de inteligencia de múltiples fuentes: feeds de WiFi, redes celulares, CCTV, ADS-B, orbitales y SDR unificados en un único mapa…
 apify/crawlee
Biblioteca de web scraping y automatización de navegador para Node.js, diseñada para crear crawlers fiables con soporte HTTP y de navegador headless,…
 hilmiazizi/oorecon
Interfaz de terminal para el descubrimiento de superficie de ataque: reconocimiento DNS, enumeración de subdominios, escaneo de puertos, IP inversa,…
 sullo/nikto
Nikto, escáner de servidores web
 hehpollon/instagram-crawler
Sin API. Rastreo de publicaciones (foto, me gusta, comentarios, fecha ...) por nombre de usuario, hashtags
 davidvoitenko/proxy-workbench
Recopila, verifica y clasifica proxies HTTP/SOCKS públicos contra tus propios objetivos, y luego los sirve mediante exportaciones clasificadas,…
 ejfkdev/dj
Extrae archivos JavaScript cargados dinámicamente mediante el análisis estático del HTML y JS de sitios web, detectando chunks de webpack, carga…
 naibowang/easyspider
A visual no-code/code-free web crawler/spider易采集:一个可视化浏览器自动化测试/数据采集/网页爬虫软件,可以无代码图形化的设计和执行爬虫任务。别名:ServiceWrapper面向Web应用的智能化服务封装系统。
 bigbodycobain/shadowbroker
Real-time geospatial OSINT platform aggregating 60+ public telemetry feeds (ADS-B, AIS, satellites, CCTV) into a unified map with server-side recon…