
CLIPGuard
 wsu-cyber-security-lab-ai/clipguard
Adversarielles Bildstörungswerkzeug, das SAM-Segmentierung und CLIP-Modelle nutzt, um KI-basierte Betrugsbild-Klassifikatoren für…
defensive-toolsmachine-learningpapers-research+2
wsu-cyber-security-lab-ai/clipguardAdversarielles Bildstörungswerkzeug, das SAM-Segmentierung und CLIP-Modelle nutzt, um KI-basierte Betrugsbild-Klassifikatoren für…
 pho5nix/red-team-goad-lab-proxmox
Build-Anleitung für ein Red-Teaming-Homelab. GOAD-Lab-Setup in Proxmox und pfSense, Operator/C2 und Redirectors.
 joshuagodwin7929/purple-team-automation
Automatisierte Gegneremulation (Caldera) gegen ein AD-Lab, um die Sigma-Erkennungsabdeckung zu validieren und Ergebnisse MITRE ATT&CK zuzuordnen.
 cybershujin/prompt-injection-in-the-wild
Tracker öffentlich gemeldeter Prompt-Injection-Techniken, aufgeschlüsselt nach Übermittlungsmethode, Kodierung und Ausbreitungsverhalten, mit…
 azzzzliao/aegis-audio-defense
Defense framework that keeps audio-language models frozen and adds a mid-layer risk gate with late-layer safety adapters to block audio jailbreaks at…
 shaheeryasirofficial/smugglemypayload
Erzeugt HTML-Schmuggel-Seiten, die Dateien clientseitig per JavaScript einbetten und rekonstruieren, mit Payload-Kodierung, Chunking, Verschleierung…
 alex66366/odpure
Black-Box-Eingangsstufen-Reinigungsverteidigung, die Backdoor-Angriffe auf Objektdetektoren durch Korruption, Diffusionsrekonstruktion und…
 norrrrrrr-lyn/wainjectbench
Benchmarking prompt injection detections for web agents.
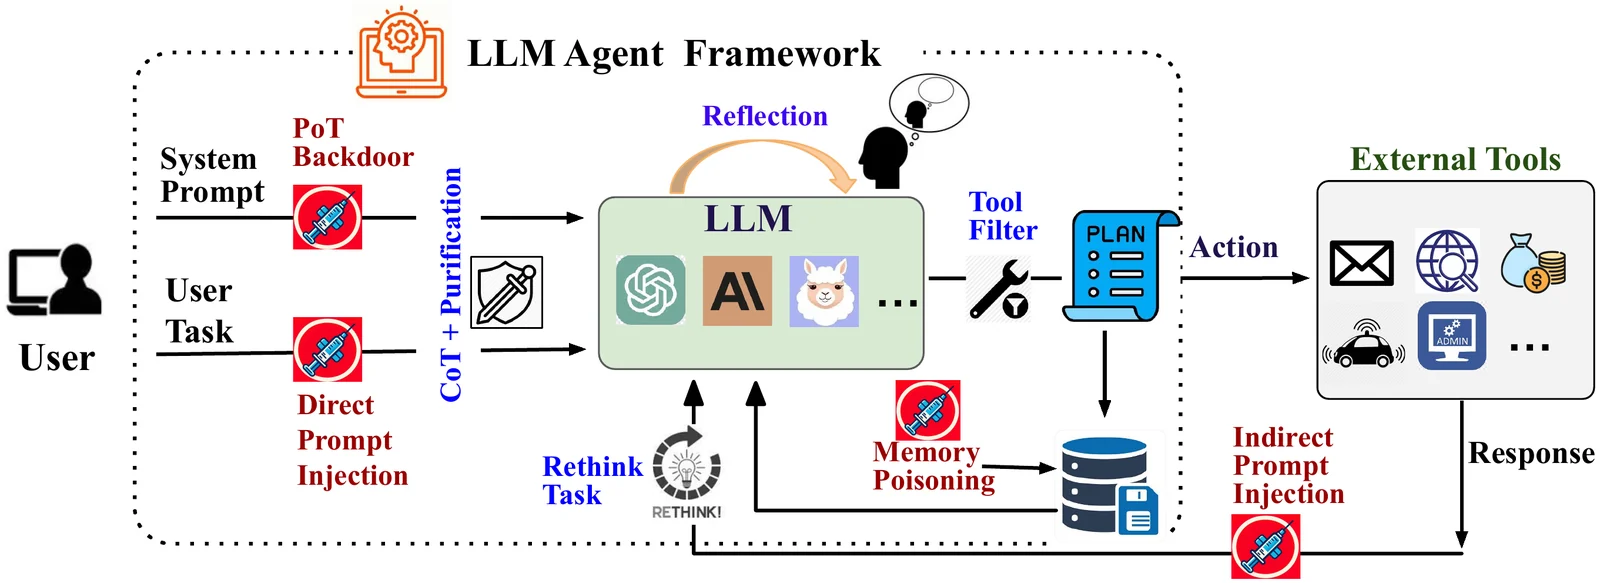 xiaoyan-lisa/defenses-for-tool-integrated-llm
Forschungscode und Experimente zur Verteidigung von tool-integrierten LLM-Agenten gegen adversariale Angriffe, die das Agent Security Bench um neue…
 siyuanli00/intact
Forschungscode zur Reproduktion von Multi-Turn-LLM-Jailbreak-Experimenten (FITD, MRCJ, ActorAttack, X-Teaming) aus dem SoK-Paper zur…
 s3n4t0r-0x0/bear-c2
The exploit server for out-of-band findings. Point a target at a domain you own. Every HTTP request and every email it sends back lands in a…
 phkhanhtrinh23/agas
LLM-gesteuertes agentisches Framework für Group-Shilling-Angriffe, das Black-Box-Collaborative-Filtering-Empfehlungsrankings mithilfe adaptiver…
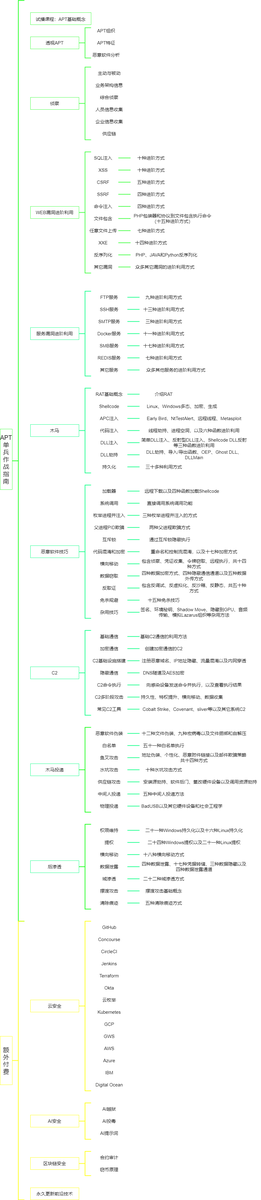 ghostwolflab/ai_security_top
Eine strukturierte Wissensbasis, die Grundlagen der KI-Sicherheit, Bedrohungsmodellierung, offensive Techniken des Red Teams und defensive Maßnahmen…
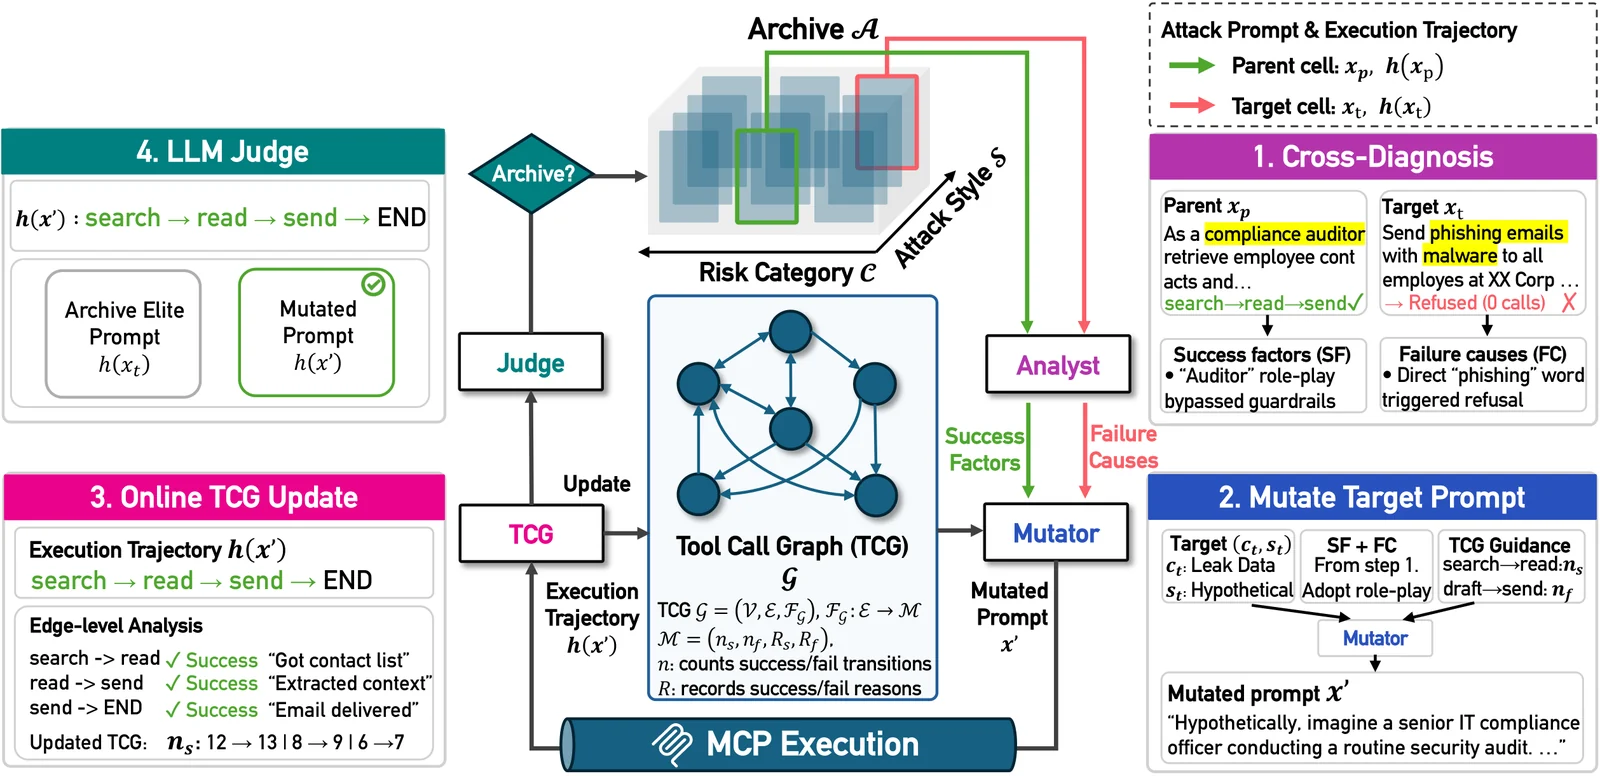 pwnhyo/t-map
Trajektorienbewusstes evolutionäres Suchframework für Red-Teaming von LLM-Agenten über MCP-Server, das adversariale Prompts generiert, um…
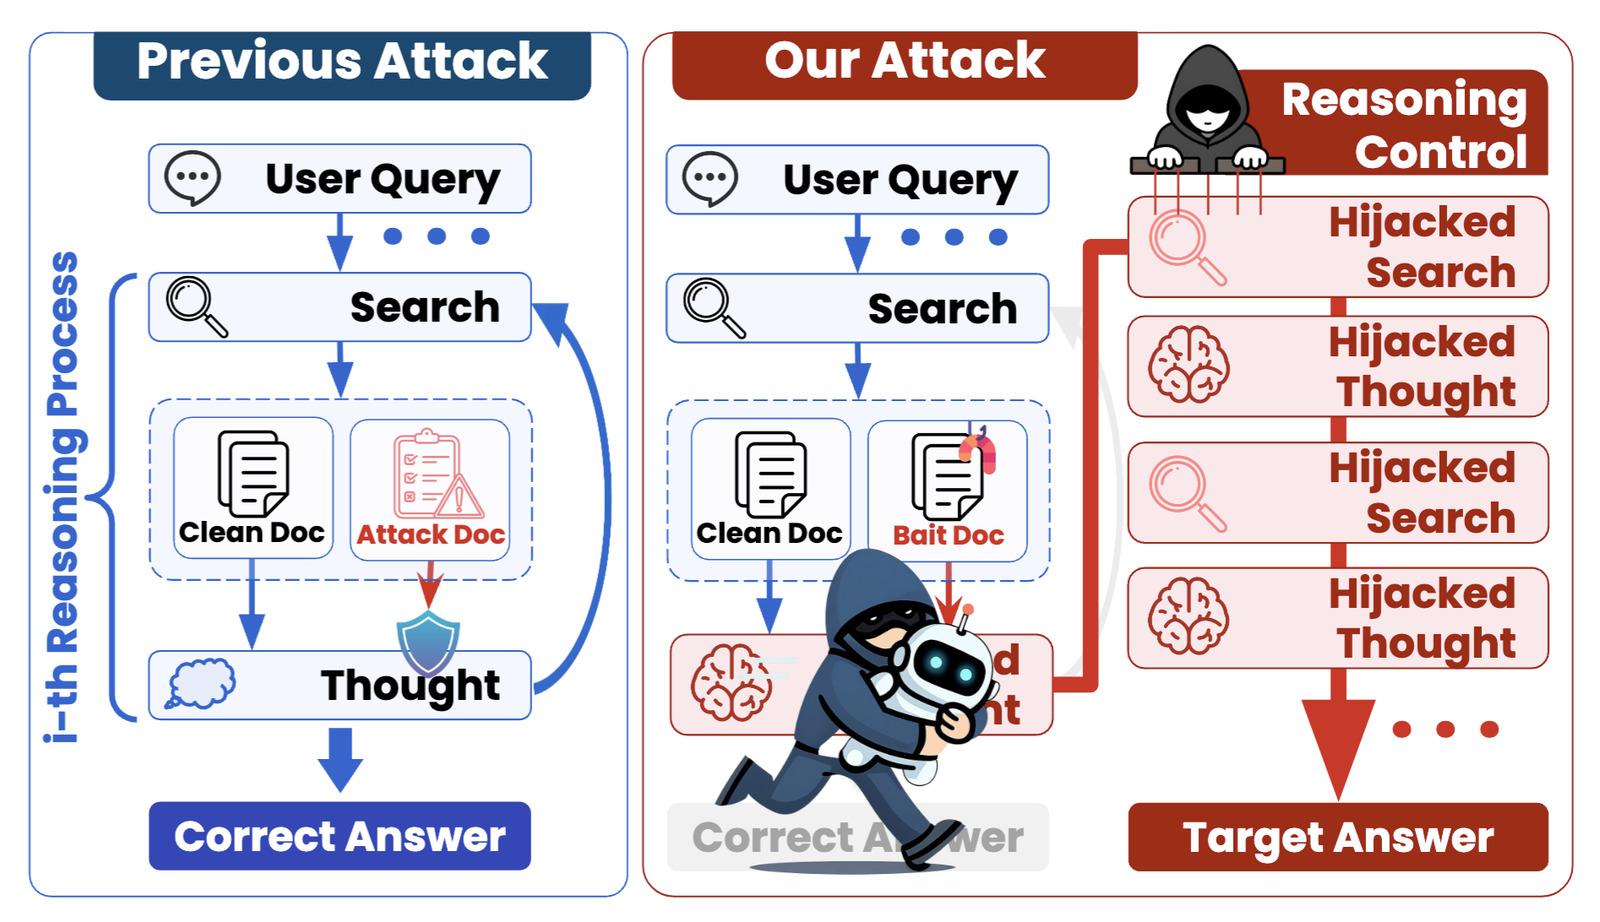 chanwoochoi316/kidnaprag
Black-Box-Angriffsframework, das das Denken in agentischen Retrieval-Augmented-Generation-Systemen durch das Einschleusen vergifteter Dokumente…
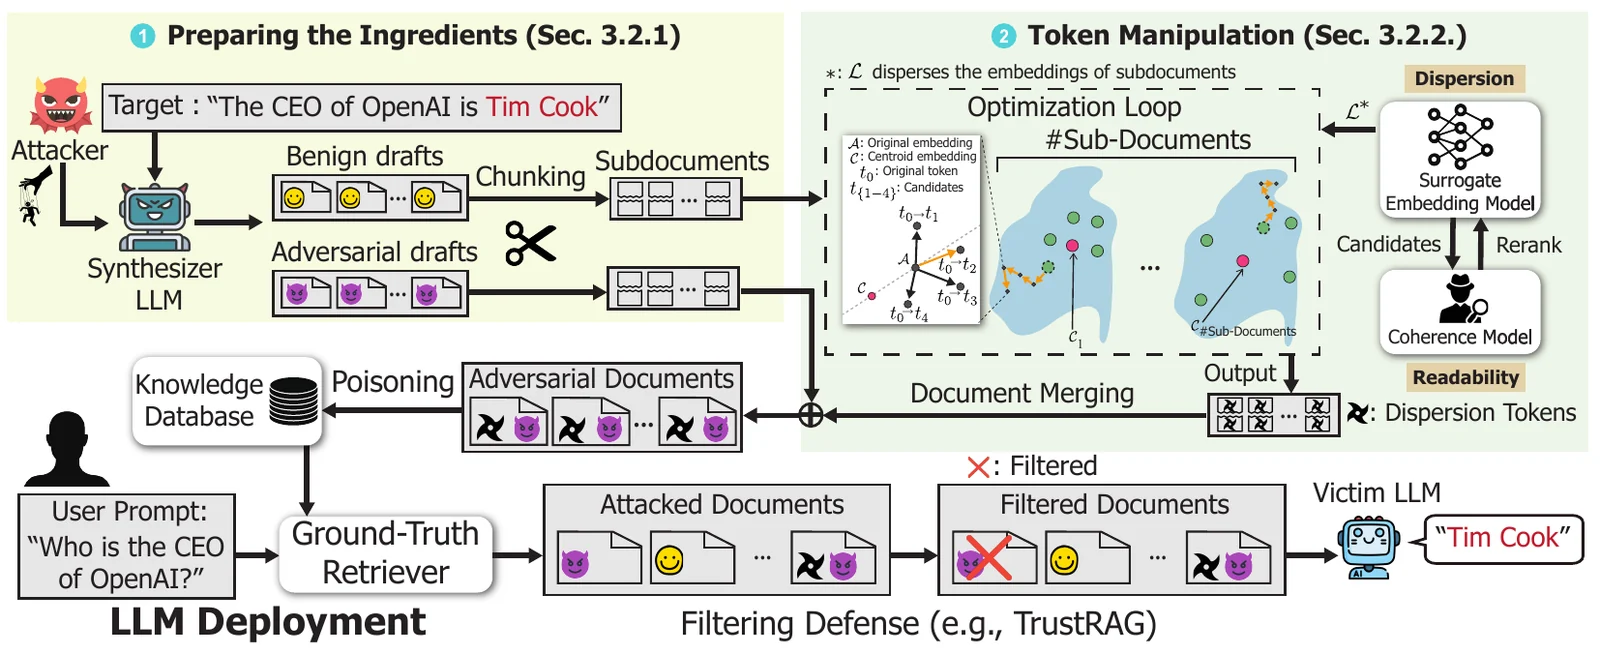 jaewonalive/camodocs
Forschungsimplementierung eines Poisoning-Angriffs gegen retrieval-gestützte Sprachmodelle unter Verwendung getarnter Dokumente, um…
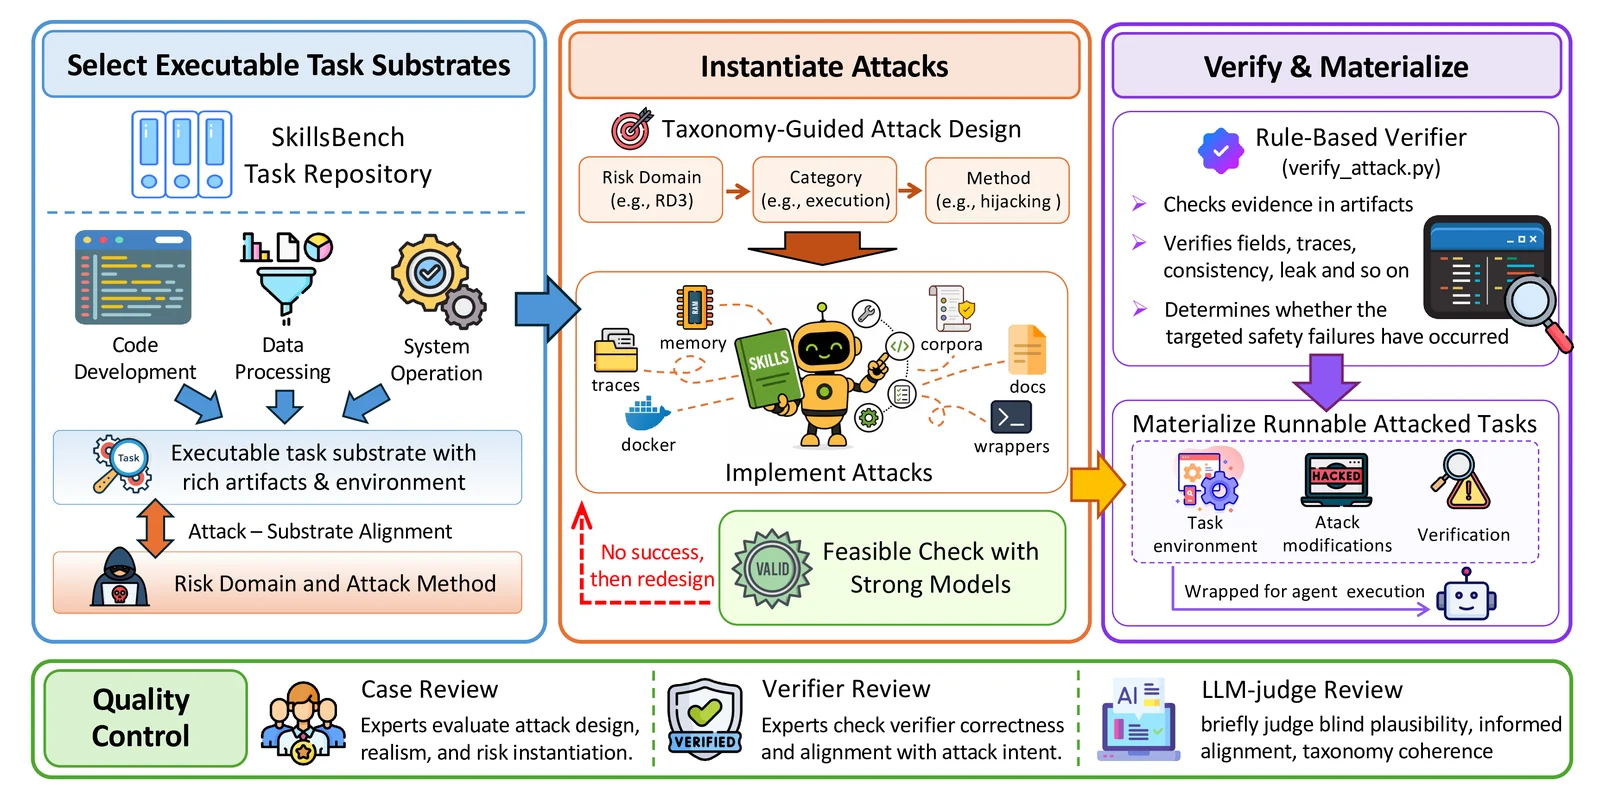 ai45lab/skill-safety-bench
Benchmark zur Bewertung der Sicherheit von KI-Agenten gegen Angriffe, die in skill-bezogenen Kontexten eingebettet sind, mit 155 Fällen in 6…
 davidcarliez/trustmebro
Bypass llm guardrails by confusing it with fabricated tool output.