
 s0md3v/photon
Unglaublich schneller Crawler, entwickelt für OSINT.
Photon


Photon Wiki • Verwendung • Kompatibilität • Photon-Bibliothek • Mitwirken • Roadmap
Photon kann beim Crawlen die folgenden Daten extrahieren:
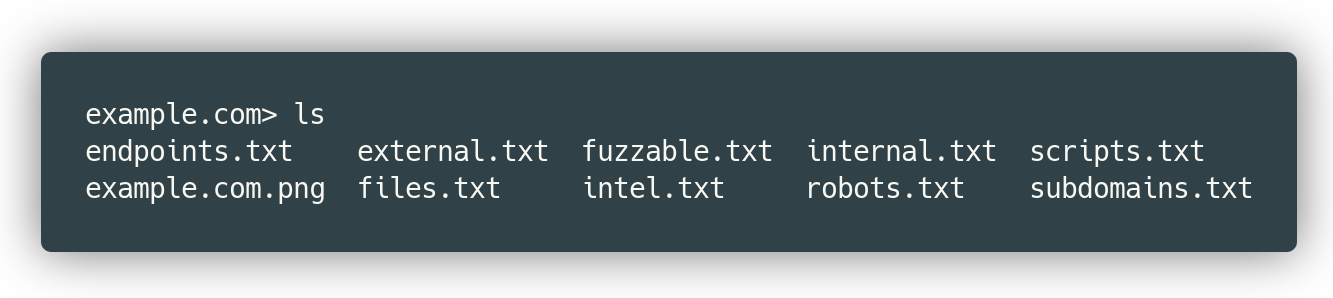
example.com/gallery.php?id=2)Die extrahierten Informationen werden organisiert gespeichert oder können als json exportiert werden.
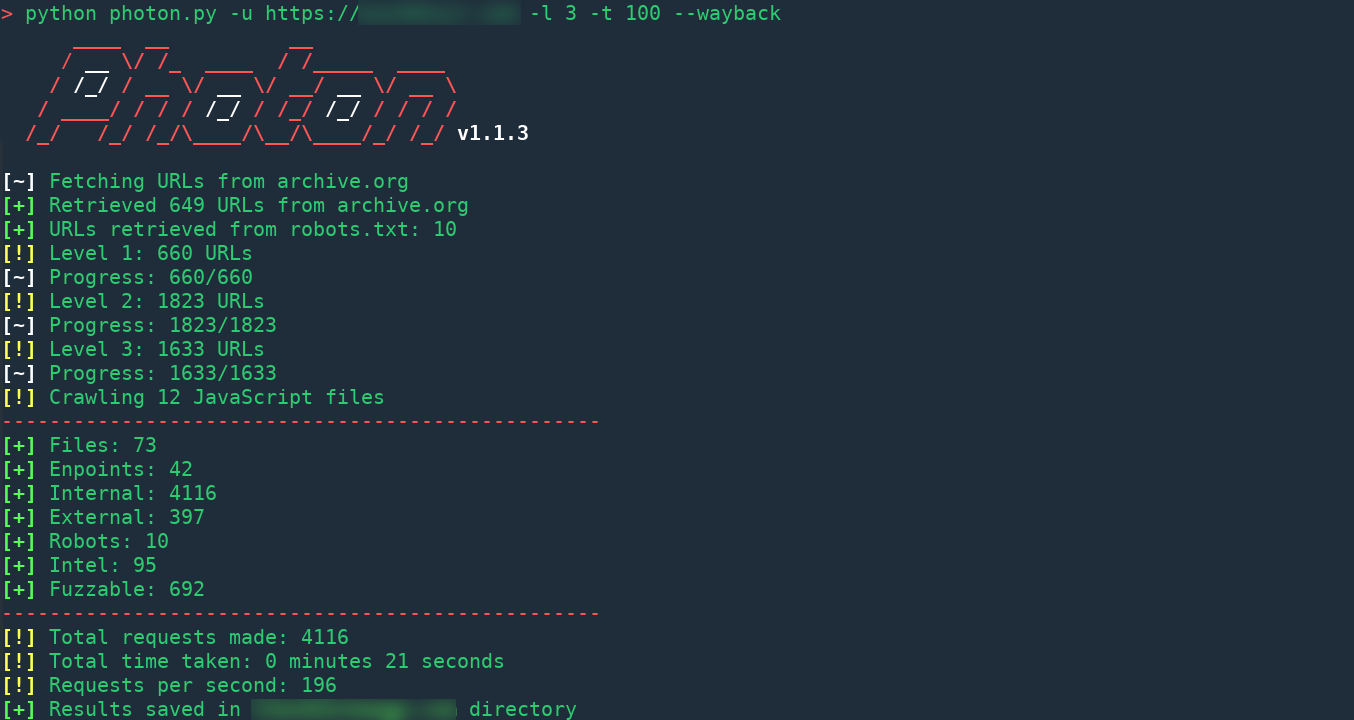
Steuere Timeout, Verzögerung, füge Seeds hinzu, schließe URLs aus, die einem Regex-Muster entsprechen, und anderes cooles Zeug. Die umfangreiche Auswahl an Optionen, die Photon bietet, ermöglicht es dir, das Web genau so zu crawlen, wie du es möchtest.
Photons intelligentes Thread-Management & verfeinerte Logik verleihen dir erstklassige Performance.
Dennoch kann Crawling ressourcenintensiv sein, aber Photon hat einige Tricks auf Lager. Du kannst URLs, die von archive.org archiviert wurden, als Seeds abrufen, indem du die Option --wayback verwendest.
Photon kann mithilfe eines leichtgewichtigen Python-Alpine-Docker-Images (103 MB) gestartet werden.
$ git clone https://github.com/s0md3v/Photon.git
$ cd Photon
$ docker build -t photon .
$ docker run -it --name photon photon:latest -u google.com
Um Ergebnisse anzuzeigen, können Sie entweder zum lokalen Docker-Volume navigieren, das Sie durch Ausführen von docker inspect photon finden, oder den Ziel-Loot-Ordner einbinden:
$ docker run -it --name photon -v "$PWD:/Photon/google.com" photon:latest -u google.com
Photon wird intensiv weiterentwickelt, und Updates zur Fehlerbehebung, zur Leistungsoptimierung und für neue Funktionen werden regelmäßig veröffentlicht.
Wenn du sehen möchtest, an welchen Funktionen und Problemen gerade gearbeitet wird, kannst du das im Development-Projektboard tun.
Updates können mit der Option --update installiert und geprüft werden. Photon verfügt über nahtlose Update-Fähigkeiten, was bedeutet, dass du Photon aktualisieren kannst, ohne deine gespeicherten Daten zu verlieren.
Verwende Strg + Umschalt + m, um den Fokuswechsel per Tabulatortaste umzuschalten. Alternativ kannst du esc und dann tab verwenden, um zum nächsten interaktiven Element auf der Seite zu gelangen.
Dateien anhängen durch Ziehen & Ablegen, Auswählen oder Einfügen.
(https://www.thordata.com/?ls=github&lk=Photon)
Photon Wiki • How To Use • Compatibility • Photon Library • Contribution • Roadmap
Photon kann beim Crawlen die folgenden Daten extrahieren:
example.com/gallery.php?id=2)Die extrahierten Informationen werden organisiert gespeichert oder können als json exportiert werden.
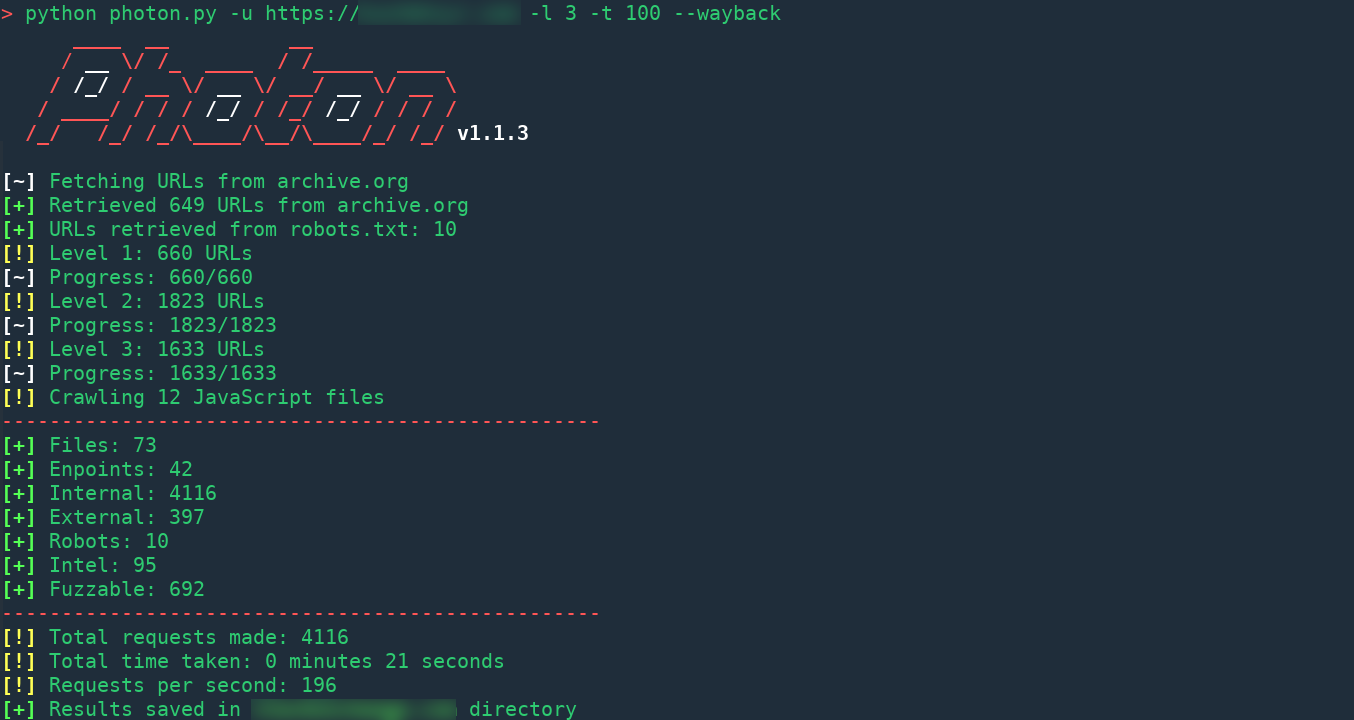
Steuere Timeout, Verzögerung, füge Seeds hinzu, schließe URLs aus, die einem Regex-Muster entsprechen, und anderes cooles Zeug. Die umfangreiche Auswahl an Optionen, die Photon bietet, ermöglicht es dir, das Web genau so zu crawlen, wie du es möchtest.
Photons intelligentes Thread-Management & verfeinerte Logik verleihen dir erstklassige Performance.
Dennoch kann Crawling ressourcenintensiv sein, aber Photon hat einige Tricks auf Lager. Du kannst URLs abrufen, die von archive.org archiviert wurden, um sie mit der Option --wayback als Seeds zu verwenden.
Photon kann mit einem leichtgewichtigen Python-Alpine-Docker-Image (103 MB) gestartet werden.
$ git clone https://github.com/s0md3v/Photon.git
$ cd Photon
$ docker build -t photon .
$ docker run -it --name photon photon:latest -u google.com
Um Ergebnisse anzuzeigen, können Sie entweder zum lokalen Docker-Volume navigieren, das Sie durch Ausführen von docker inspect photon finden, oder den Ziel-Loot-Ordner einbinden:
$ docker run -it --name photon -v "$PWD:/Photon/google.com" photon:latest -u google.com
