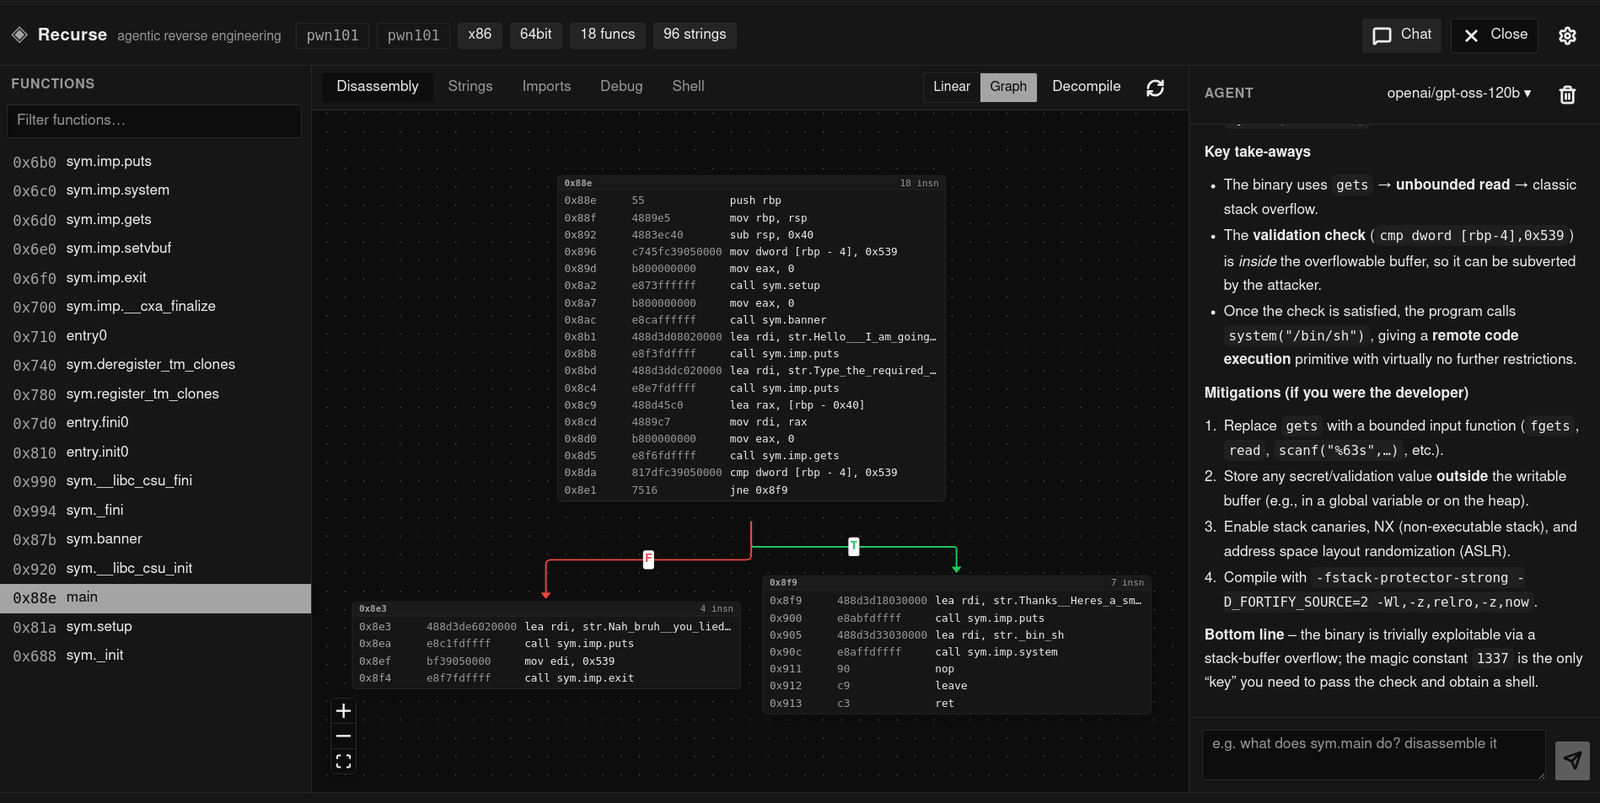
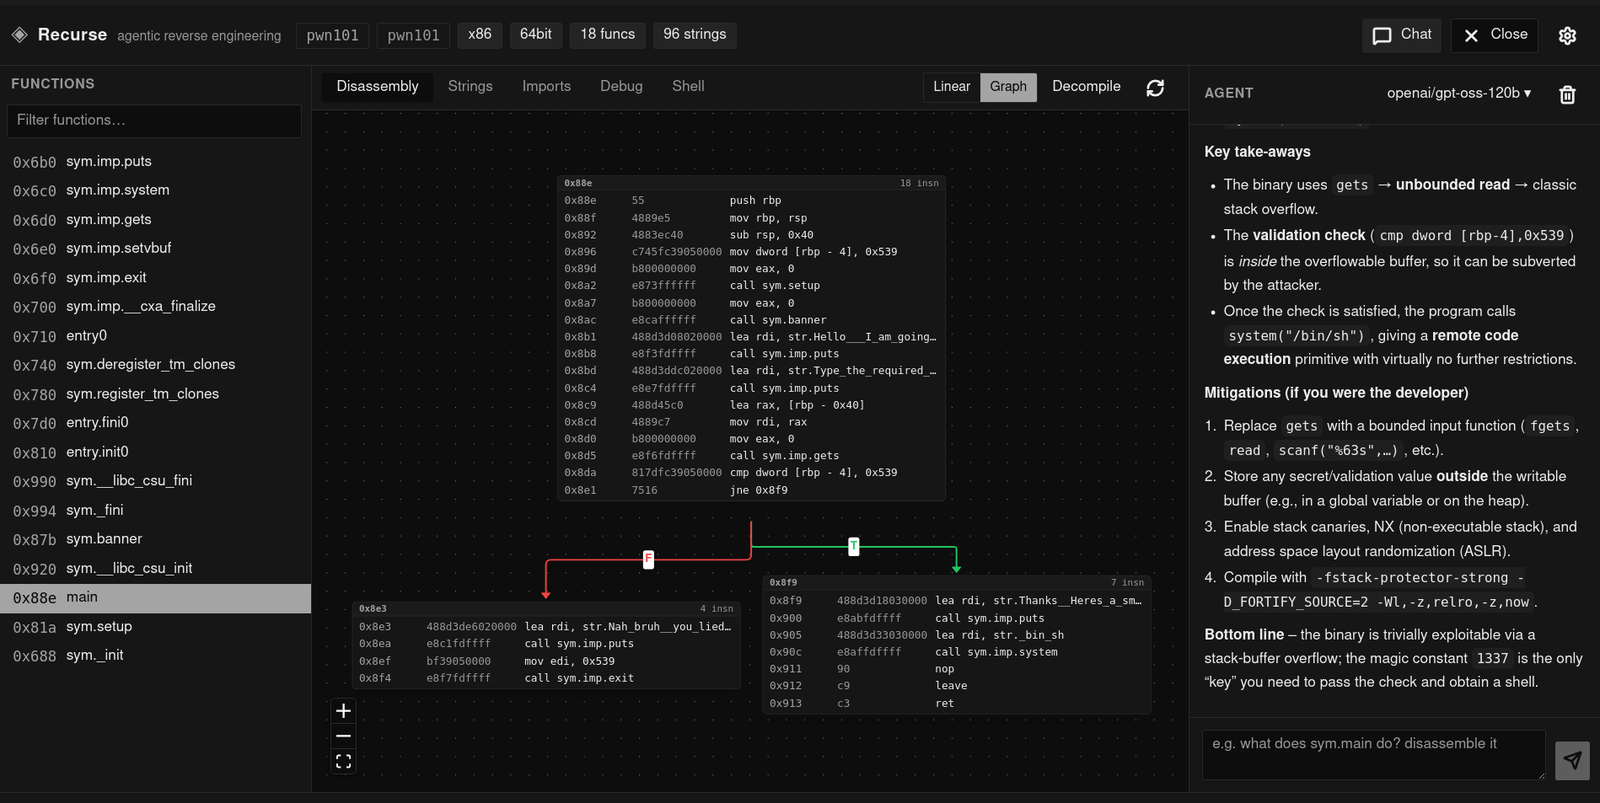
Agentische Reverse-Engineering-IDE mit einem reinen Rust-Multi-Architektur-Disassembler, nativem Decompiler, Debugger und LLM-Agenten für Binäranalyse und CTF-Arbeit.
Agentische Reverse-Engineering-Umgebung — eine Desktop-App der Ghidra-Klasse im Geiste von „Cursor für Reverse Engineering“. Erstellt mit Tauri 2 (React + TypeScript-Frontend) auf einem austauschbaren Analyse-Backend. Der Standard ist eine reine Rust-native Engine — kein externer Prozess, keine Copyleft-Abhängigkeit, Multi-Architektur über Capstone. Du kannst die Analyse auch über r2 (radare2) oder IDA Pro ausführen: Wähle eine der beiden Engines, und die gesamte App — Agent-Tools und UI — steuert diese an. Das Agent-Tool und die UI sind backend-agnostisch — siehe docs/backends.md.
Cargo-Workspace im Wurzelverzeichnis; die Desktop-App ist ein Paket darin.
tauri/                   desktop app (Tauri + React)
  src/                     React frontend
  src-tauri/               Tauri Rust backend (engine sessions, agent wiring)
  package.json             app scripts (Vite, Vitest, Tauri CLI)
crates/
  recurse-agent/              agent framework: LLM loop, tool runtime, SQLite memory
  recurse-static/          static analysis: ELF/PE/Mach-O parsing, multi-arch disassembly,
                           CFG and cross-reference recovery, the engine seam
  recurse-vtil/            VTIL-inspired de-obfuscation/de-virtualization IL, lifter, optimizer
  recurse-mcp/             standalone headless MCP server (stdio) over the engine — no Tauri, no IDA
  recurse-debug/           cross-platform debugger (ptrace/Mach/Win32, breakpoints, stepping)
  recurse-eval/            headless eval harness (YAML-configured tiers)
justfile                 single entry point for both halves
recurse-agent ist nur der Agent; die statische Analyse liegt in recurse-static und der
Debugger in recurse-debug, sodass der Agent keinen Systemcode einbindet, den er
nicht verwendet. Kein Crate hängt von Tauri ab, und jedes lässt sich eigenständig bauen/testen;
recurse-eval steuert den Agenten headless. Alle sind Workspace-Mitglieder, sodass eine
einzige Cargo.lock und ein einziges target/ das gesamte Repo abdecken.
Ctrl+L)checksec) und Analyse-ZählerundefinedN-Zelle, um ihr einen Typ zu geben. Ein von dir gesetzter Rückgabetyp wird in der Signaturzeile
des Kopfes angezeigt. Beides bleibt in SQLite erhalten, nach Funktion verschlüsselt, und das Leeren einer Zelle setzt sie
auf das zurück, was die Instruktionen angeben/clear und erneutes Öffnen und dienen als Grundlage für die nächste Sitzungrecurse-agent) mit Debug-Tracing pro Turn; dieselbe Agent-Schleife läuft
in der UI und im Eval-Harnesslift-Op: hebt eine Funktion in eine VTIL-artige De-Obfuskierungs-IL und führt
Propagation/Folding/Dead-Code-Elimination/Branch-Resolution-Passes über die gesamte Routine aus
— nützlich, wenn die Disassembly wie ein VM-Dispatcher oder eine
Opaque-Predicate-Kette aussieht (siehe docs/vtil-lift.md)decompile rendert C-ähnlichen Pseudocode (if/while-
Strukturierung, vollständige Instruktionsabdeckung) aus derselben recurse-vtil-
Pipeline — kein externes Tool, kein r2 erforderlichrecurse-mcp-Server: dieselbe Engine über MCP stdio für jeden
MCP-fähigen Agenten (Claude Code, Cursor, Claude Desktop, …) — kein Tauri, kein
IDA-Seat, keine Python-Bridge (siehe docs/recurse-mcp.md)Die Analyse läuft über ein einziges Engine-Trait (crates/recurse-static/src/engine.rs), sodass die
Engine eine Wahl ist, keine harte Abhängigkeit:
native (Standard) — reines Rust-Parsing von ELF/PE/Mach-O und Multi-Architektur-Disassembly
(object + capstone): x86/x86-64, ARM, AArch64, MIPS, PowerPC, RISC-V, SPARC, SystemZ,
M68K, BPF. Kein Kindprozess, kein externes Tool, kein LGPL im Build. Enthält einen Decompiler
(die Lift → Optimize → Structure-Pipeline von recurse-vtil — siehe
docs/vtil-lift.md) und eine lift-Op für VTIL-artige De-Obfuskierung.ida) — Opt-in-Headless-Analyse und Hex-Rays-Dekompilierung über idat.Wähle über das Einstellungsmenü, die Umgebungsvariable RECURSE_BACKEND oder die gespeicherte
Konfiguration. Der Agent erhält ein backend-neutrales analyze-Tool (functions, disasm, graph,
lift, decompile, xrefs, strings, imports, info, plus raw für die Engine-Konsole) —
gefiltert auf die Operationen, die die aktive Engine tatsächlich unterstützt, sodass raw (native hat keine Konsole)
nur angeboten wird, wenn es verfügbar ist. Die UI konsumiert kanonische Ergebnistypen, nicht das JSON irgendeiner Engine.
Siehe docs/backends.md für das Trait, die Crate-Auswahl und die Lizenzierungs-
Begründung. Das Öffnen einer großen Binärdatei ist schnell, weil die Analyse lazy ist — die Discovery indiziert
Funktionen kostengünstig und Basic Blocks werden erst dekodiert, wenn eine Funktion angezeigt wird; siehe
docs/lazy-analysis.md.
Einen MCP-Server an IDA/Ghidra anzudocken oder Disassembly in einen CLI-Agenten einzufügen, funktioniert für CTFs mit 5 Funktionen und scheitert bei echten Binärdateien. Recurse ist eine zweckgebaute Umgebung, kein Chatbot-Wrapper: