 pvharmo2/gha-lab-e8902eccd3
Sicherheitsforschungslabor: Reproduktion von CVE-2025-52467 (pgai pull_request_target-Workflow-Codeausführung / GITHUB_TOKEN-Exfiltration) — Schnappschuss von timescale/pgai

Automatisiertes Forschungsobjekt — nicht das Upstream-Projekt.
Dieses Repository ist ein Wegwerf-Labor, das von einer automatisierten Testumgebung für eine Masterarbeit an der Université Laval zur Reproduktion veröffentlichter GitHub-Actions- Workflow-Schwachstellen erstellt wurde. Es ist eine wörtliche Momentaufnahme von
timescale/pgaibeim Commit2a209b058c60823b57e8b7775b10244ff340eb8b(2025-05-14), weiterverbreitet unter der eigenen Lizenz dieses Projekts, deren Datei unverändert in dieser Momentaufnahme enthalten ist.Das Upstream-Projekt ist nicht beteiligt, wird niemals angegriffen, und die hier untersuchte Schwachstelle ist bereits öffentlich. Jedes Secret und jede Variable in diesem Repository ist ein zufällig generierter Dummy-Wert — es ist kein echtes Zugangsdatum vorhanden. Aktionsreferenzen und Runner-Images sind auf das fixiert, was sie am 2025-05-14 aufgelöst haben; siehe
pinning.mdin der Testumgebungsausgabe für jede an der Momentaufnahme vorgenommene Änderung.Fragen oder Einwände: [email protected]
Eine Python-Bibliothek, die PostgreSQL in eine robuste, produktionsreife Abruf-Engine für RAG- und Agentic-Anwendungen verwandelt.
🔄 Automatisches Erstellen und Synchronisieren von Vektor-Embeddings aus PostgreSQL-Daten und S3-Dokumenten. Embeddings aktualisieren sich automatisch, wenn sich Daten ändern.
🔍 Leistungsstarke Vektor- und semantische Suche mit pgvector und pgvectorscale.
🛡️ Sofort produktionsreif: Unterstützt Stapelverarbeitung für effiziente Embedding-Erzeugung, mit integrierter Behandlung von Modellfehlern, Ratenbegrenzungen und Latenzspitzen.
🐘 Funktioniert mit jeder PostgreSQL-Datenbank, einschließlich Timescale Cloud, Amazon RDS, Supabase und mehr.
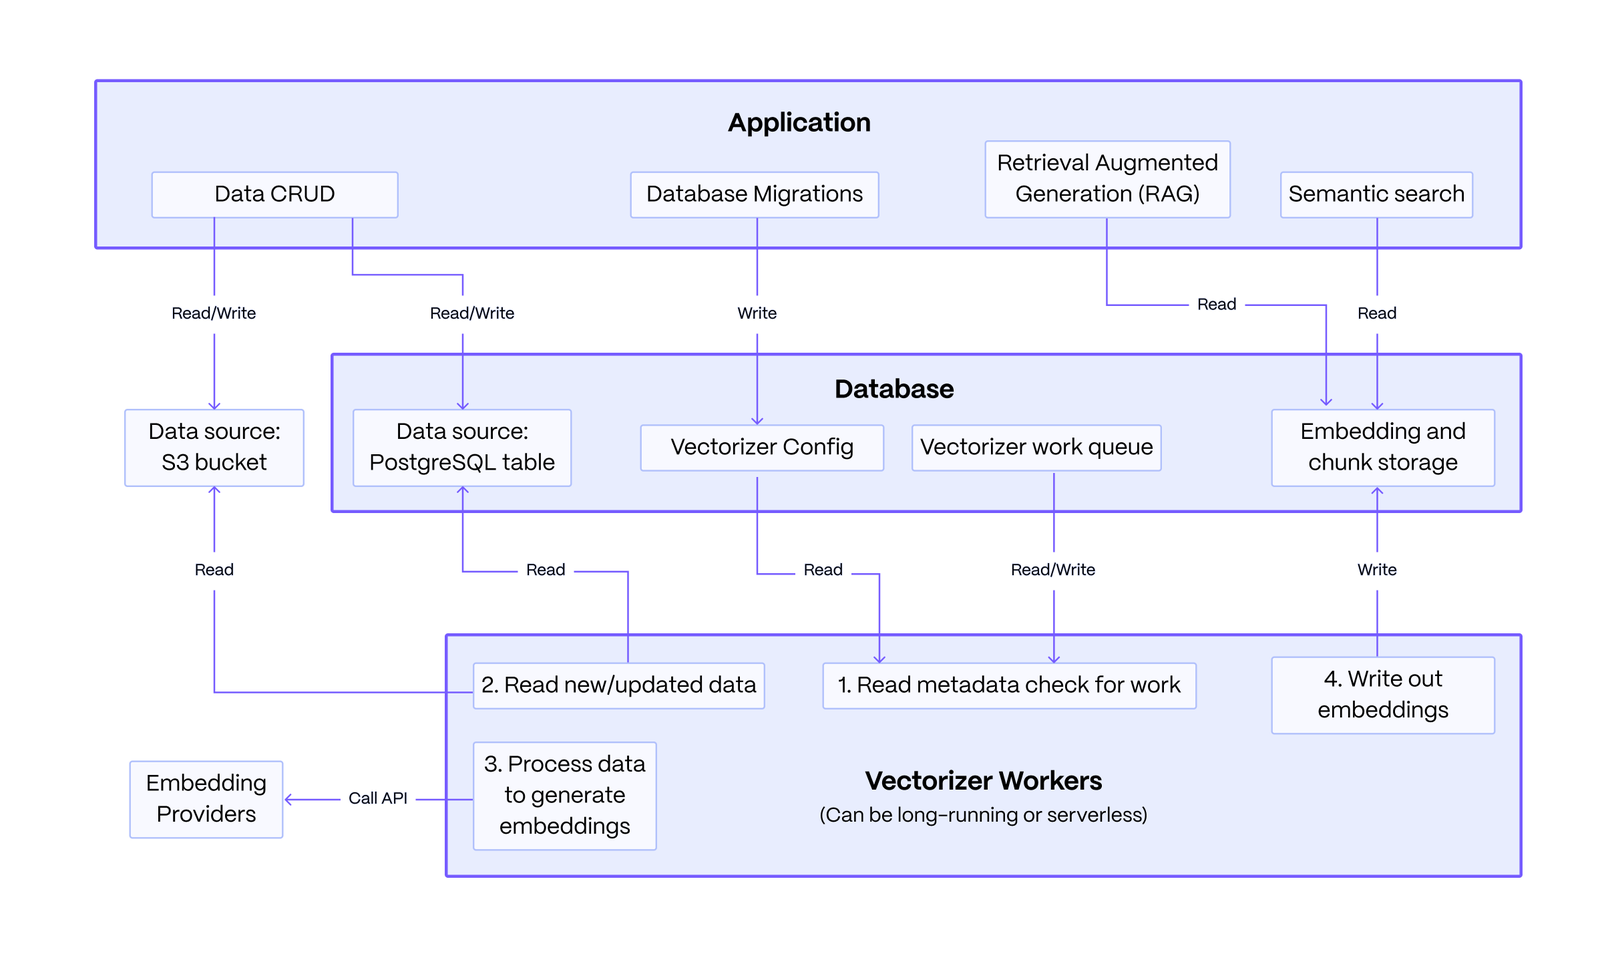
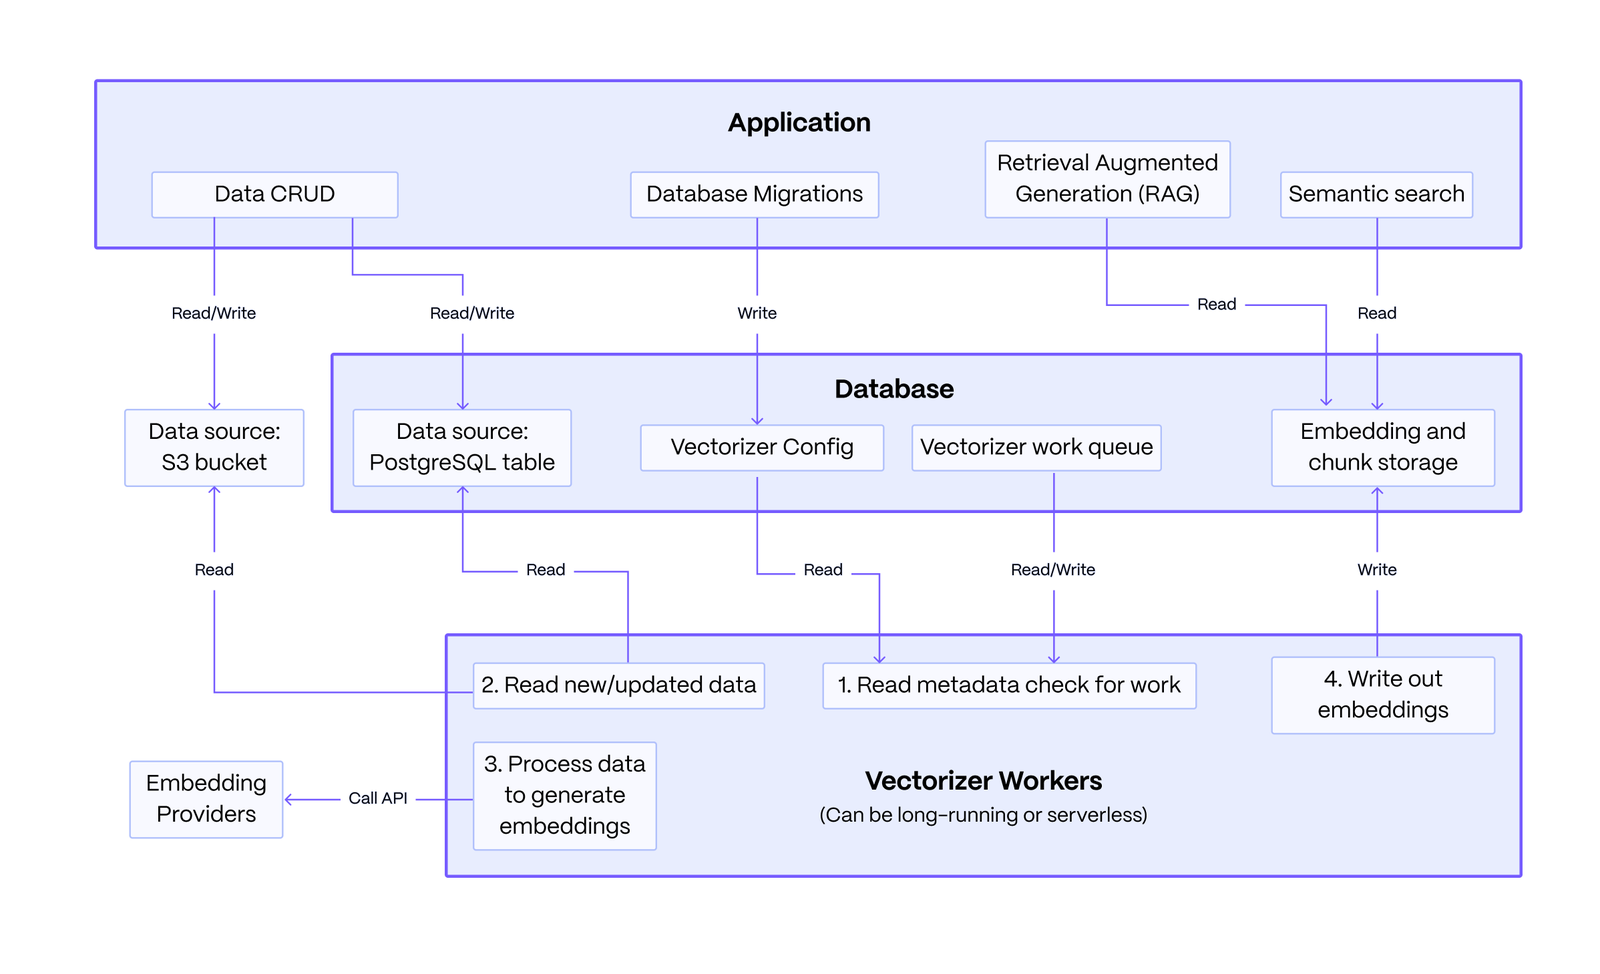
Grundlegende Architektur: Das System besteht aus einer Anwendung, die Sie schreiben, einer PostgreSQL-Datenbank und zustandslosen Vectorizer-Workern. Die Anwendung definiert eine Vectorizer-Konfiguration, um Daten aus Quellen wie PostgreSQL oder S3 einzubetten. Die Worker lesen diese Konfiguration, verarbeiten die Datenwarteschlange zu Embeddings und in Blöcke aufgeteiltem Text und schreiben die Ergebnisse zurück. Die Anwendung fragt diese Daten dann ab, um RAG und semantische Suche zu betreiben.
Die Hauptstärke dieser Architektur liegt in ihrer Widerstandsfähigkeit: Datenänderungen durch die Anwendung sind vom Embedding-Prozess entkoppelt, sodass Fehler im Embedding-Dienst die Kern-Datenoperationen nicht beeinträchtigen.
Installieren Sie zuerst das pgai-Paket.``` pip install pgai
Dann installiere die pgai-Datenbankkomponenten. Du kannst dies vom Terminal aus über die CLI oder in deinem Python-Anwendungscode mithilfe des pgai-Python-Pakets tun.```
# from the cli
pgai install -d <database-url>

# or from the python package, often done as part of your application setup
import pgai
pgai.install(DB_URL)
Diese Quickstart-Demonstration zeigt, wie pgai Vectorizer semantische Suche und RAG über PostgreSQL-Daten ermöglicht, indem Embeddings automatisch erstellt und synchronisiert werden, wenn sich Daten ändern.
Die entscheidende „Geheimzutat" von pgai Vectorizer ist sein deklarativer Ansatz zur Embedding-Generierung. Definieren Sie einfach Ihre Pipeline und lassen Sie Vectorizer die operative Komplexität der Synchronisierung von Embeddings übernehmen, selbst wenn Embedding- Endpunkte unzuverlässig sind. Sie können eine einfache Version der Pipeline wie folgt definieren:```sql CREATE TABLE IF NOT EXISTS wiki ( id INTEGER PRIMARY KEY GENERATED ALWAYS AS IDENTITY, url TEXT NOT NULL, title TEXT NOT NULL, text TEXT NOT NULL )
SELECT ai.create_vectorizer( 'wiki'::regclass, loading => ai.loading_column(column_name=>'text'), destination => ai.destination_table(target_table=>'wiki_embedding_storage'), embedding => ai.embedding_openai(model=>'text-embedding-ada-002', dimensions=>'1536') )
The vectorizer will automatically create embeddings for all the rows in the
`wiki` table, and, more importantly, will keep the embeddings synced with the
underlying data as it changes.  **Think of it almost like declaring an index** on
the `wiki` table, but instead of the database managing the index datastructure
for you, the Vectorizer is managing the embeddings.

## Running the quick start

**Prerequisites:**
- A PostgreSQL database ([docker instructions](https://docs.timescale.com/self-hosted/latest/install/installation-docker/)).
- An OpenAI API key (we use openai for embedding in the quick start, but you can use [multiple providers](#supported-embedding-models)).

Create a `.env` file with the following:```
OPENAI_API_KEY=<your-openai-api-key>
DB_URL=<your-database-url>
Sie können den vollständigen Python-Code und die requirements.txt aus dem Quickstart-Beispiel herunterladen und im selben Verzeichnis wie die .env-Datei ausführen.
