 jaidedai/easyocr
Sofort einsatzbereite OCR mit über 80 unterstützten Sprachen und allen gängigen Schriftsystemen, einschließlich Lateinisch, Chinesisch, Arabisch, Devanagari, Kyrillisch usw.


Gebrauchsfertige OCR mit über 80 unterstützten Sprachen und allen gängigen Schriftsystemen, darunter: Lateinisch, Chinesisch, Arabisch, Devanagari, Kyrillisch usw.
Demo auf unserer Website ausprobieren
Integriert in Huggingface Spaces 🤗 mit Gradio. Probiere die Web-Demo aus:
Installation mit pip
Für die neueste stabile Version:
pip install easyocr
Für die neueste Entwicklungsversion:
pip install git+https://github.com/JaidedAI/EasyOCR.git
Hinweis 1: Unter Windows installieren Sie bitte zuerst torch und torchvision gemäß den offiziellen Anweisungen unter https://pytorch.org. Wählen Sie auf der PyTorch-Website unbedingt die richtige CUDA-Version aus, die Sie verwenden. Wenn Sie nur im CPU-Modus arbeiten möchten, wählen Sie CUDA = None.
Hinweis 2: Wir stellen außerdem ein Dockerfile hier bereit.
Hinweis 3: Der optionale DBNet-Detektor (detect_network='dbnet18') kompiliert seine C++/CUDA-Operationen bei der ersten Verwendung, wofür das Ninja-Build-Tool erforderlich ist. Um es zusammen mit EasyOCR zu installieren, verwenden Sie pip install "easyocr[dbnet]".
import easyocr
reader = easyocr.Reader(['ch_sim','en']) # this needs to run only once to load the model into memory
result = reader.readtext('chinese.jpg')
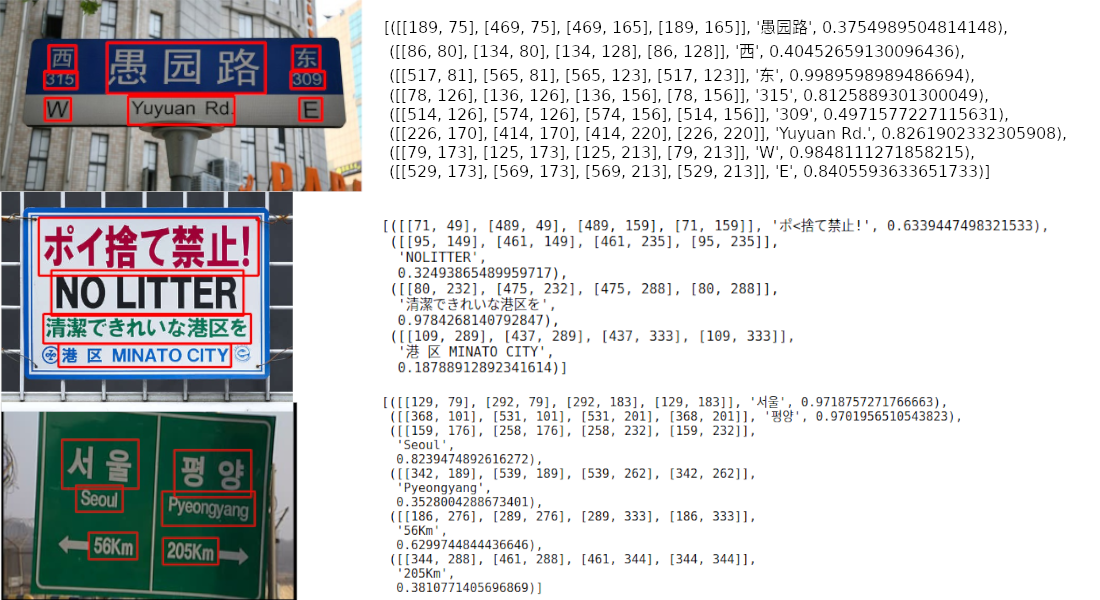
Die Ausgabe erfolgt in einem Listenformat, wobei jedes Element jeweils einen Begrenzungsrahmen, den erkannten Text und die Konfidenzstufe darstellt.
[([[189, 75], [469, 75], [469, 165], [189, 165]], '愚园路', 0.3754989504814148),
 ([[86, 80], [134, 80], [134, 128], [86, 128]], '西', 0.40452659130096436),
 ([[517, 81], [565, 81], [565, 123], [517, 123]], '东', 0.9989598989486694),
 ([[78, 126], [136, 126], [136, 156], [78, 156]], '315', 0.8125889301300049),
 ([[514, 126], [574, 126], [574, 156], [514, 156]], '309', 0.4971577227115631),
 ([[226, 170], [414, 170], [414, 220], [226, 220]], 'Yuyuan Rd.', 0.8261902332305908),
 ([[79, 173], [125, 173], [125, 213], [79, 213]], 'W', 0.9848111271858215),
 ([[529, 173], [569, 173], [569, 213], [529, 213]], 'E', 0.8405593633651733)]
Hinweis 1: ['ch_sim','en'] ist die Liste der Sprachen, die du lesen möchtest. Du kannst mehrere Sprachen gleichzeitig übergeben, aber nicht alle Sprachen können zusammen verwendet werden. Englisch ist mit jeder Sprache kompatibel, und Sprachen, die gemeinsame Zeichen teilen, sind in der Regel untereinander kompatibel.
Hinweis 2: Anstelle des Dateipfads chinese.jpg kannst du auch ein OpenCV-Bildobjekt (numpy-Array) oder eine Bilddatei als Bytes übergeben. Eine URL zu einem Rohbild ist ebenfalls akzeptabel.
Hinweis 3: Die Zeile reader = easyocr.Reader(['ch_sim','en']) dient dazu, ein Modell in den Speicher zu laden. Es dauert einige Zeit, muss aber nur einmal ausgeführt werden.
Du kannst auch detail=0 für eine einfachere Ausgabe festlegen.
reader.readtext('chinese.jpg', detail = 0)
Ergebnis:
['愚园路', '西', '东', '315', '309', 'Yuyuan Rd.', 'W', 'E']
Die Modellgewichte für die gewählte Sprache werden automatisch heruntergeladen, oder du kannst sie manuell vom Model Hub herunterladen und im Ordner '~/.EasyOCR/model' ablegen.
Falls du keine GPU hast oder deine GPU über wenig Speicher verfügt, kannst du das Modell im reinen CPU-Modus ausführen, indem du gpu=False hinzufügst.
reader = easyocr.Reader(['ch_sim','en'], gpu=False)
Weitere Informationen finden Sie im Tutorial und in der API-Dokumentation.
$ easyocr -l ch_sim en -f chinese.jpg --detail=1 --gpu=True
Für das Erkennungsmodell, hier lesen.
Für das Detektionsmodell (CRAFT), hier lesen.
reader = easyocr.Reader(['en'], detection='DB', recognition = 'Transformer')
Die Idee ist, jedes hochmoderne Modell in EasyOCR einbinden zu können. Es gibt viele Genies, die bessere Erkennungs-/Erkennungsmodelle entwickeln wollen, aber wir versuchen hier nicht, Genies zu sein. Wir wollen ihre Arbeiten nur schnell für die Öffentlichkeit zugänglich machen ... kostenlos. (Nun, wir glauben, dass die meisten Genies wollen, dass ihre Arbeit so schnell/groß wie möglich eine positive Wirkung erzielt.) Die Pipeline sollte etwa wie im folgenden Diagramm aussehen. Graue Slots sind Platzhalter für austauschbare hellblaue Module.
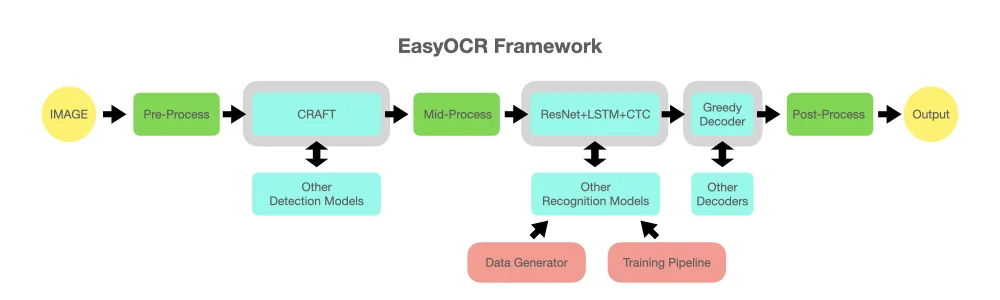
Dieses Projekt basiert auf Forschung und Code aus mehreren Papers und Open-Source-Repositories.
Die gesamte Deep-Learning-Ausführung basiert auf Pytorch. ❤️
Die Erkennungsausführung verwendet den CRAFT-Algorithmus aus diesem offiziellen Repository und ihrem Paper (Danke an @YoungminBaek von @clovaai). Wir verwenden auch ihr vortrainiertes Modell. Das Trainingsskript wird von @gmuffiness bereitgestellt.

