 dtrizna/quasarnix
Reverse Shell Erkennung mit maschinellem Lernen

Dmitrijs Trizna · Luca Demetrio · Battista Biggio · Fabio Roli


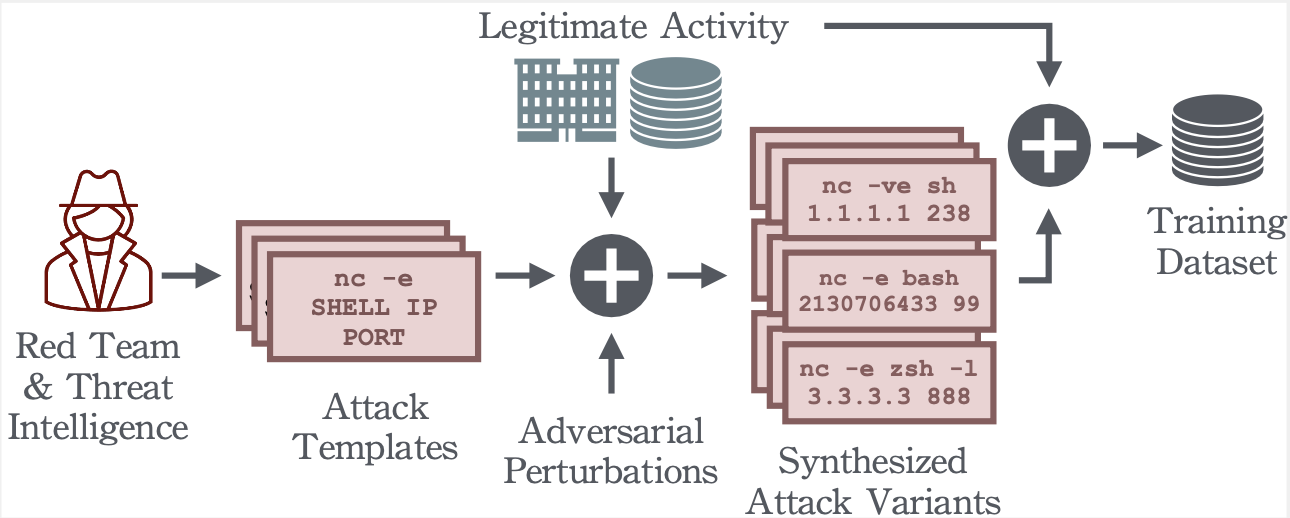
Linux Living-off-the-Land (LOTL) Reverse Shells missbrauchen legitime Binärdateien (bash, python, nc, …), um verdeckte ausgehende Verbindungen herzustellen, wodurch signaturbasierte Erkennung gegen neuartige Varianten und Umgehungsversuche unzuverlässig wird. QuasarNix adressiert zwei offene Lücken in diesem Bereich:
Das Framework synthetisiert ein Trainingskorpus von 1 Million Befehlen aus 34 Reverse-Shell-Vorlagen und evaluiert 14 Modellarchitekturen bei einem Betriebspunkt von FPR = 10⁻⁶ — was den realen Einschränkungen der SIEM-Alarmmüdigkeit entspricht.
Leistung auf dem zurückgehaltenen Testdatensatz über Basislinien-Heuristiken und QuasarNix-Architekturen. Die TPR wird als Mittelwert ± Standardabweichung über zehn unabhängige Trainingsläufe bei FPR = 10⁻⁶ angegeben. Fett markiert das beste Ergebnis; Sternchen (*) hebt die im Aufsatz diskutierten Modelle hervor.
| Architektur | Parameter | TPR @ FPR=10⁻⁶ | F1 | Genauigkeit | AUC | Training |
|---|---|---|---|---|---|---|
| Signaturen (Sigma) | 184 | 3,37% | 6,52% | 51,68% | 51,68% | N/A |
| One-Class SVM (auf legitim) | 1K | 0,00% | 82,87% | 79,33% | 79,33% | 10s |
| One-Class SVM (auf bösartig) | 1K | 0,00% | 40,14% | 25,20% | 25,20% | 10s |
| 1D-CNN (nicht augm., unausgeglichen) | 1K | 0,00% | 80,29% | 77,91% | 87,44%* | 15m |
| 1D-CNN (nicht augm., ausgeglichen) | 1K | 0,06% | 82,38% | 79,33% | 88,12%* | 29m |
| SLP (nicht augm.) | 1K | 0,00% | 0,00% | 50,00% | 91,58% | 1h 12m |
| Architektur | Parameter | TPR @ FPR=10⁻⁶ | F1 | Genauigkeit | AUC | Training |
|---|---|---|---|---|---|---|
| Random Forest | 1K | 42,23 ± 6,27% | 96,07% | 96,21% | 99,84% | 18s |
| GBDT (XGBoost) | 1K | 60,20 ± 8,22% | 89,92% | 90,84% | 99,89% | 14s |
| MLP (Kein Embedding) | 264K | 54,16 ± 2,14%* | 94,00% | 94,34% | 99,80% | 18m |
| Architektur | Parameter | TPR @ FPR=10⁻⁶ | F1 | Genauigkeit | AUC | Training |
|---|---|---|---|---|---|---|
| MLP (Embedding) | 297K | 10,76 ± 17,32% | 67,70% | 75,60% | 89,15% | 18m |
| LSTM | 318K | 21,52 ± 23,66% | 64,16% | 74,05% | 99,75% | 24m |
| 1D-CNN | 301K | 46,42 ± 32,67%* | 85,97% | 88,20% | 99,99% | 29m |
| 1D-CNN + LSTM | 316K | 20,48 ± 22,08% | 58,92% | 71,06% | 98,21% | 29m |
| 1D-CNN + LSTM + Attention | 402K | 17,19 ± 22,59% | 62,53% | 73,08% | 98,46% | 26m |
| Transformer (Mean Pooling) | 335K | 0,00 ± 0,00% | 83,39% | 86,07% | 98,78% | 1h 18m |
| Transformer (CLS-Token) | 335K | 0,00 ± 0,00% | 78,55%* | 82,67% | 99,38% | 1h 30m |
| Transformer (Attn. Pooling) | 335K | 0,00 ± 0,00% | 87,82% | 89,41% | 98,85% | 1h 24m |
Fazit: GBDT erreicht 60% TPR bei FPR = 10⁻⁶ — 18× höher als Signaturen (3,37%) — bei einem Training von 14 Sekunden auf handelsüblicher Hardware.
Die folgende Tabelle katalogisiert Linux-Shell-Escape-Techniken aus dem Werkzeugkasten des Angreifers. Die dritte Spalte gibt an, ob die Technik die auditd-Kernel-Telemetrie-Normalisierung überlebt — nur die vier fett gedruckten Einträge erzeugen einen eindeutigen EXECVE-Datensatz und stellen die tatsächliche Angriffsfläche dar.
| Manipulation | Funktionelles Beispiel | Von auditd beibehalten |
|---|---|---|
' | ba's'h -i | Nein |
" | ba"s"h -i | Nein |
\ | ba\s\h -i | Nein |
$@ | ba$@sh -i | Nein |
[char] | ba[s]h -i | Nein |
{form} | {bash,-i} | Nein |
| IFS-Variable | bash${IFS}-i | Nein |
| Leere Variable | bas${u}h -i | Nein |
| Gefälschter Befehl | bas$(u)h -i | Nein |
| Base64 | echo c2ggLWk= | base64 -d | sh | Nein |
| Hex | echo \x73\x68 \x20\x2d\x69 | sh | Nein |
| Flag-Manipulation | bash -x -li | Ja |
| Dezimale IP | ping 2130706433 | Ja |
| Binärumbenennung | cp bash a; a -i | Ja |
| Nutzloser Code | mkfifo a; id; cat a | Ja |
Nur 4 von 15 Techniken überleben die Kernel-Normalisierung und werden als gegnerischer Angriffsraum verwendet.
Drei Angriffsfamilien werden evaluiert — Einschleusen von harmlosen Inhalten, Shell-Escape-Störungen und eine Hybrid aus beiden:
Über Evasion zur Inferenzzeit hinaus evaluieren wir Angriffe zur Trainingszeit:
Label-Flipping-Verschmutzung (0–20% der Trainingslabels umgedreht): Modelle verschlechtern sich allmählich; GBDT zeigt durch das Ensemble-Voting inhärente Resistenz und bleibt bei hohen Verschmutzungsverhältnissen funktionsfähig.
Backdoor-Angriff (0,01–1% Vergiftungsverhältnis, 2–10 Token-Trigger): Kurze Trigger (2–4 Token) können keine zuverlässigen Hintertüren installieren, da sie im harmlosen Verkehr häufig vorkommen. Die optimale Installation einer Hintertür erfordert 6–10 Token-Trigger bei einem Vergiftungsverhältnis von ≥0,03%.
Fazit: Poisoning-Angriffe erfordern eine erhebliche, statistisch nachweisbare Dateneinspeisung, um erfolgreich zu sein. Der Ensemble-Mechanismus von GBDT bietet inhärente Robustheit ohne gegnerische Trainingskosten.
Nach der Veröffentlichung dieser Arbeit veröffentlichte Google auf der CAMLIS 2025 (arXiv:2512.08802) ein konzeptionell ausgerichtetes Produktionssystem: eine zweistufige YARA- + ML-Pipeline, die auf Zehntausenden von Systemen eingesetzt wird und bis zu 250 Milliarden Ereignisse pro Tag verarbeitet. Dieses System validiert unabhängig das hybride ML-für-SIEM-Erkennungsparadigma und die hier vorgeschlagene Active-Learning-Rückkopplungsschleife und demonstriert seine Praxistauglichkeit im industriellen Maßstab.
| Ressource | Link | Details |
|---|---|---|
| Datensatz | dtrizna/QuasarNix | 1.003.122 Befehle · Train 533k / Test 470k · Apache-2.0 |
| Vorgefertigte Modelle | dtrizna/QuasarNix | GBDT, Random Forest, MLP, 1D-CNN, … |
from datasets import load_dataset
ds = load_dataset("dtrizna/QuasarNix")

