
ai-reverse-engineering — Updated!
KI-gestütztes Reverse Engineering mit Ghidra
Rev·Deck – KI-gestütztes Reverse Engineering mit Ghidra
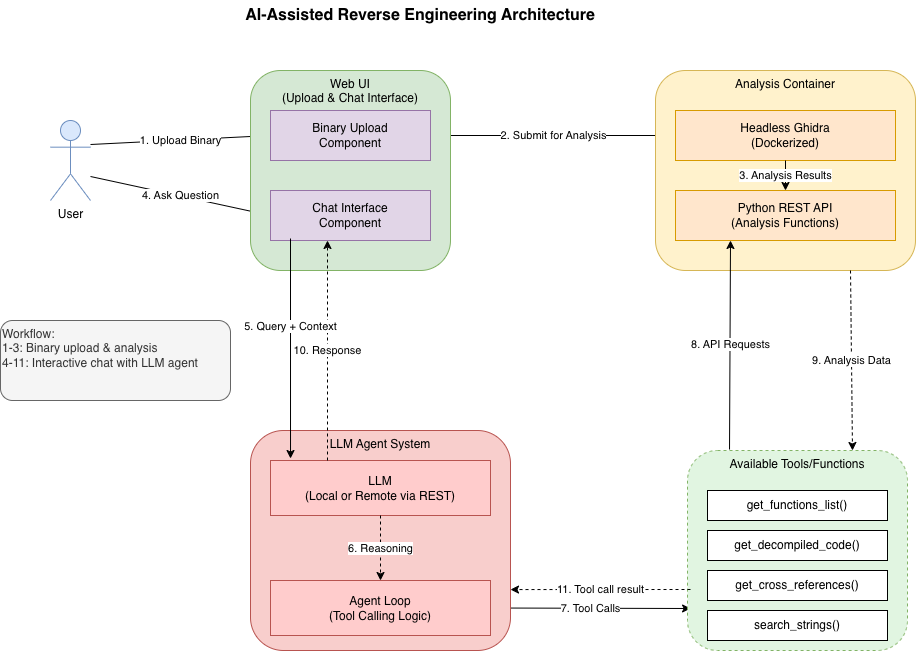
Rev·Deck ist eine lokale Workstation zur statischen Analyse für einen einzelnen Benutzer. Sie kombiniert eine evidenzorientierte Web-UI mit einem LLM-Copilot für Binärdateien, die von einem Headless-Ghidra-Dienst analysiert werden: Durchsuchen Sie deterministische Evidenz (Funktionen, Strings, Importe, Querverweise, einen begrenzten Aufrufgraph) direkt oder stellen Sie dem Assistenten begrenzte Fragen, deren Tatsachenbehauptungen überprüfbare Evidenz zitieren müssen.
Analysierte Binärdateien werden niemals ausgeführt. Der Browser kommuniziert nur mit dieser Flask-App; die App leitet validierte, typisierte Anfragen an den Ghidra-Dienst weiter.
Demo
https://github.com/user-attachments/assets/fba14dc5-7ad5-4137-9349-ed824da64fbe
Schnellstart (Docker)
cp .env.example .env      # set API_BASE and MODEL_NAME; set API_KEY if required
docker compose up --build
Docker Compose liest .env automatisch zur Interpolation. Es bricht vor dem Start ab, wenn API_BASE oder MODEL_NAME fehlt; API_KEY=not-used bleibt für lokale/schlüssellose Anbieter gültig. Der Stack startet beide Dienste. Öffnen Sie http://127.0.0.1:5000.
Um nur den Ghidra-Dienst auszuführen:
docker pull biniamfd/ghidra-headless-rest:latest   # ensure the newest image

docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:latest
Um einen Stand reproduzierbar zu fixieren, verwenden Sie den getesteten Release-Digest anstelle von latest:
docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3a8448d8ed969079b452306e806f36079c3ddd298f4a618d6e2f1442d
Voraussetzungen
- Docker und Docker Compose (für den Schnellstart-Pfad) oder Python 3.10+ und Node.js 18+ (für die Ausführung aus dem Quellcode).
- Ein OpenAI-kompatibler LLM-Endpunkt (lokal oder gehostet) und ein Modellname.
- Das öffentliche Ghidra-Image:
biniamfd/ghidra-headless-rest:latest.
Wichtige Umgebungsvariablen
Kopieren Sie .env.example zu .env und füllen Sie diese aus; die vollständige Liste und Standardwerte finden Sie in dieser Datei.
| Variable | Standard | Bedeutung |
|---|---|---|
API_BASE | erforderlich | OpenAI-kompatible Basis-URL (http/https). Compose bricht bei Fehlen früh ab. |
API_KEY | not-used | Anbieterschlüssel. Wird niemals protokolliert oder an den Browser gesendet; not-used ist für schlüssellose lokale Anbieter gültig. |
MODEL_NAME | erforderlich | Modell-ID, die der konfigurierte Endpunkt erwartet. Compose bricht bei Fehlen früh ab. |
LLM_STREAM | auto | Streaming-Transport: auto (Streaming, einmaliger Rückfall auf blockierend bei einem Kompatibilitätsfehler vor der Ausgabe), true (immer Streaming), false (immer blockierend). |
GHIDRA_API_BASE | http://127.0.0.1:9090 | Basis-URL des Ghidra-Dienstes. |
GHIDRA_IMAGE | biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3... | Getesteter Release, fixiert durch unveränderlichen Digest. :latest löst ebenfalls auf diesen Digest auf; überschreiben, um einen anderen Release zu fixieren. |
HOST / PORT | 127.0.0.1 / 5000 | Bindung des Entwicklungsservers. |
MAX_UPLOAD_BYTES | 104857600 | Obergrenze für Uploads. |
CHATS_DIR | webui/chats | Verzeichnis für den Chatverlauf. |
LLM-Anbieter
Rev·Deck spricht mit jedem OpenAI-kompatiblen Chat-Completions-Endpunkt über das OpenAI-SDK, vollständig konfiguriert über API_BASE / API_KEY / MODEL_NAME. Es gibt keine anbieterspezifische Header-, Parameter- oder Modelllogik: Ein lokaler Ollama-Server (API_BASE=http://127.0.0.1:11434/v1), ein selbst gehosteter vLLM/llama.cpp/LM-Studio-Endpunkt, OpenAI selbst oder ein Gateway wie OpenRouter funktionieren alle auf dieselbe Weise.
Beispiele für .env-Anbietereinstellungen (Platzhalter verwenden, niemals echte Schlüssel einchecken):
# Ollama
API_BASE=http://127.0.0.1:11434/v1
API_KEY=not-used
MODEL_NAME=qwen3:8b
# OpenRouter
API_BASE=https://openrouter.ai/api/v1
API_KEY=replace-with-your-key
MODEL_NAME=anthropic/claude-opus-4.8
# OpenAI
API_BASE=https://api.openai.com/v1
API_KEY=replace-with-your-key
MODEL_NAME=replace-with-a-supported-model-id
# LM Studio, vLLM, or llama.cpp (adjust port/model to the server)
API_BASE=http://127.0.0.1:1234/v1
API_KEY=not-used
MODEL_NAME=replace-with-the-served-model-id
Standardmäßig (LLM_STREAM=auto) fordert der Assistent eine gestreamte Antwort an und leitet Token weiter, sobald sie eintreffen. Streaming bietet außerdem eine stärkere Abbruchgarantie: Wenn Sie eine Antwort stoppen (oder den Tab schließen), schließt Rev·Deck den zugrunde liegenden Anbieterstream umgehend und führt keine weiteren Tool- oder Modellrunden aus, sodass die vorgelagerte Generierung abgebrochen wird, statt im Hintergrund bis zum Abschluss weiterzulaufen.
Hinweise:
- Abrechnung. Durch Abbrechen wird der Stream auf unserer Seite sofort geschlossen, aber einige gehostete Anbieter rechnen weiterhin Token ab, die sie bereits generiert haben (oder die gesamte Antwort), ungeachtet einer vorzeitigen Client-Trennung. Die Garantie bezieht sich darauf, keine weitere Arbeit zu verrichten, nicht auf die Abrechnungspolitik eines Anbieters.
- Kompatibilität. Nicht jeder OpenAI-kompatible Endpunkt akzeptiert Streaming mit Tools. Unter
auto, wenn der Anbieter die gestreamte Anfrage mit einem Kompatibilitätsfehler (HTTP 400/404/405/422) ablehnt, bevor Inhalte oder Tool-Call-Ausgaben vorliegen, fällt Rev·Deck einmal auf einen einzelnen blockierenden Aufruf zurück und merkt sich das für den Rest des Prozesses. Authentifizierungsfehler (401/403), Ratenbegrenzung (429) und Serverfehler (5xx) werden nicht als Kompatibilitätsprobleme behandelt, sondern als Fehler angezeigt, statt stillschweigend erneut versucht zu werden. Setzen SieLLM_STREAM=false, um Streaming vollständig zu überspringen, oderLLM_STREAM=true, um es zu erzwingen (kein Fallback).
Verwendung
Öffnen Sie die App und laden Sie eine Binärdatei hoch, um einen Analyseauftrag zu starten. Offensichtliche Klartextinhalte lösen eine Bestätigungsabfrage aus, bevor sie an Ghidra gesendet werden; verwenden Sie die explizite Rohbinary-Übersteuerung nur, wenn der Inhalt absichtlich Firmware/Daten und kein ausführbares Format ist. Sobald die Analyse abgeschlossen ist, wechseln Sie zwischen zwei Arbeitsbereichs-Registerkarten:
- Analyse – deterministische Evidenzansichten: Zusammenfassung, Funktionen (filtern/paginieren), Importe, Strings, eine Abfrageansicht, ein Funktionsinspektor (Pseudocode, Querverweise, begrenzter Aufrufgraph, Hexdump) und – sofern der verbundene Ghidra-Dienst sie unterstützt – Typen, Globale, Sidecar-Annotationen, Archivexport und ein deterministisches Attack-Surface-Ranking mit erklärbaren positiven/mildernden Signalen und Evidenzabdeckung.
- Chat – der Assistent in einem von zwei Modi:
- Copilot (Standard): ein begrenzter Schritt/Tool-Aufruf pro Nachricht für Ad-hoc-Fragen.
- Autonom: einen benannten, budgetierten Workflow starten, der mehrere begrenzte Schritte eigenständig ausführt und während der Arbeit eine Live-Aktivitätszeitleiste anzeigt.