 biniamf/ai-reverse-engineering
KI-gestütztes Reverse Engineering mit Ghidra

# Rev·Deck – KI-gestütztes Reverse Engineering mit Ghidra

Rev·Deck ist eine lokale Workstation zur statischen Analyse für einen einzelnen Benutzer. Sie kombiniert eine evidenzorientierte Web-UI mit einem LLM-Copilot für Binärdateien, die von einem Headless-Ghidra-Dienst analysiert werden: Durchsuchen Sie deterministische Evidenz (Funktionen, Strings, Importe, Querverweise, einen begrenzten Aufrufgraph) direkt oder stellen Sie dem Assistenten begrenzte Fragen, deren Tatsachenbehauptungen überprüfbare Evidenz zitieren müssen.

Analysierte Binärdateien werden niemals ausgeführt. Der Browser kommuniziert nur mit dieser Flask-App; die App leitet validierte, typisierte Anfragen an den Ghidra-Dienst weiter.

## Demo

https://github.com/user-attachments/assets/fba14dc5-7ad5-4137-9349-ed824da64fbe

## Schnellstart (Docker)

```bash
cp .env.example .env      # set API_BASE and MODEL_NAME; set API_KEY if required
docker compose up --build
```

Docker Compose liest `.env` automatisch zur Interpolation. Es bricht vor dem Start ab, wenn `API_BASE` oder `MODEL_NAME` fehlt; `API_KEY=not-used` bleibt für lokale/schlüssellose Anbieter gültig. Der Stack startet beide Dienste. Öffnen Sie http://127.0.0.1:5000.

Um nur den Ghidra-Dienst auszuführen:

```bash
docker pull biniamfd/ghidra-headless-rest:latest   # ensure the newest image

docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:latest
```

Um einen Stand reproduzierbar zu fixieren, verwenden Sie den getesteten Release-Digest anstelle von `latest`:

```bash
docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3a8448d8ed969079b452306e806f36079c3ddd298f4a618d6e2f1442d
```

## Voraussetzungen

- Docker und Docker Compose (für den Schnellstart-Pfad) oder Python 3.10+ und Node.js 18+ (für die Ausführung aus dem Quellcode).
- Ein OpenAI-kompatibler LLM-Endpunkt (lokal oder gehostet) und ein Modellname.
- Das öffentliche Ghidra-Image: `biniamfd/ghidra-headless-rest:latest`.

## Wichtige Umgebungsvariablen

Kopieren Sie `.env.example` zu `.env` und füllen Sie diese aus; die vollständige Liste und Standardwerte finden Sie in dieser Datei.

| Variable | Standard | Bedeutung |
| --- | --- | --- |
| `API_BASE` | erforderlich | OpenAI-kompatible Basis-URL (http/https). Compose bricht bei Fehlen früh ab. |
| `API_KEY` | `not-used` | Anbieterschlüssel. Wird niemals protokolliert oder an den Browser gesendet; `not-used` ist für schlüssellose lokale Anbieter gültig. |
| `MODEL_NAME` | erforderlich | Modell-ID, die der konfigurierte Endpunkt erwartet. Compose bricht bei Fehlen früh ab. |
| `LLM_STREAM` | `auto` | Streaming-Transport: `auto` (Streaming, einmaliger Rückfall auf blockierend bei einem Kompatibilitätsfehler vor der Ausgabe), `true` (immer Streaming), `false` (immer blockierend). |
| `GHIDRA_API_BASE` | `http://127.0.0.1:9090` | Basis-URL des Ghidra-Dienstes. |
| `GHIDRA_IMAGE` | `biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3...` | Getesteter Release, fixiert durch unveränderlichen Digest. `:latest` löst ebenfalls auf diesen Digest auf; überschreiben, um einen anderen Release zu fixieren. |
| `HOST` / `PORT` | `127.0.0.1` / `5000` | Bindung des Entwicklungsservers. |
| `MAX_UPLOAD_BYTES` | `104857600` | Obergrenze für Uploads. |
| `CHATS_DIR` | `webui/chats` | Verzeichnis für den Chatverlauf. |

## LLM-Anbieter

Rev·Deck spricht mit **jedem OpenAI-kompatiblen Chat-Completions-Endpunkt** über das OpenAI-SDK, vollständig konfiguriert über `API_BASE` / `API_KEY` / `MODEL_NAME`. Es gibt keine anbieterspezifische Header-, Parameter- oder Modelllogik: Ein lokaler [Ollama](https://ollama.com)-Server (`API_BASE=http://127.0.0.1:11434/v1`), ein selbst gehosteter vLLM/llama.cpp/LM-Studio-Endpunkt, OpenAI selbst oder ein Gateway wie OpenRouter funktionieren alle auf dieselbe Weise.

Beispiele für `.env`-Anbietereinstellungen (Platzhalter verwenden, niemals echte Schlüssel einchecken):

```dotenv
# Ollama
API_BASE=http://127.0.0.1:11434/v1
API_KEY=not-used
MODEL_NAME=qwen3:8b
```

```dotenv
# OpenRouter
API_BASE=https://openrouter.ai/api/v1
API_KEY=replace-with-your-key
MODEL_NAME=anthropic/claude-opus-4.8
```

```dotenv
# OpenAI
API_BASE=https://api.openai.com/v1
API_KEY=replace-with-your-key
MODEL_NAME=replace-with-a-supported-model-id
```

```dotenv
# LM Studio, vLLM, or llama.cpp (adjust port/model to the server)
API_BASE=http://127.0.0.1:1234/v1
API_KEY=not-used
MODEL_NAME=replace-with-the-served-model-id
```

Standardmäßig (`LLM_STREAM=auto`) fordert der Assistent eine **gestreamte** Antwort an und leitet Token weiter, sobald sie eintreffen. Streaming bietet außerdem eine stärkere Abbruchgarantie: Wenn Sie eine Antwort stoppen (oder den Tab schließen), schließt Rev·Deck den zugrunde liegenden Anbieterstream umgehend und führt keine weiteren Tool- oder Modellrunden aus, sodass die vorgelagerte Generierung abgebrochen wird, statt im Hintergrund bis zum Abschluss weiterzulaufen.

Hinweise:

- **Abrechnung.** Durch Abbrechen wird der Stream auf unserer Seite sofort geschlossen, aber einige gehostete Anbieter rechnen weiterhin Token ab, die sie bereits generiert haben (oder die gesamte Antwort), ungeachtet einer vorzeitigen Client-Trennung. Die Garantie bezieht sich darauf, *keine weitere Arbeit zu verrichten*, nicht auf die Abrechnungspolitik eines Anbieters.
- **Kompatibilität.** Nicht jeder OpenAI-kompatible Endpunkt akzeptiert Streaming mit Tools. Unter `auto`, wenn der Anbieter die gestreamte Anfrage mit einem Kompatibilitätsfehler (HTTP 400/404/405/422) ablehnt, *bevor* Inhalte oder Tool-Call-Ausgaben vorliegen, fällt Rev·Deck einmal auf einen einzelnen blockierenden Aufruf zurück und merkt sich das für den Rest des Prozesses. Authentifizierungsfehler (401/403), Ratenbegrenzung (429) und Serverfehler (5xx) werden **nicht** als Kompatibilitätsprobleme behandelt, sondern als Fehler angezeigt, statt stillschweigend erneut versucht zu werden. Setzen Sie `LLM_STREAM=false`, um Streaming vollständig zu überspringen, oder `LLM_STREAM=true`, um es zu erzwingen (kein Fallback).

## Verwendung

Öffnen Sie die App und laden Sie eine Binärdatei hoch, um einen Analyseauftrag zu starten. Offensichtliche Klartextinhalte lösen eine Bestätigungsabfrage aus, bevor sie an Ghidra gesendet werden; verwenden Sie die explizite Rohbinary-Übersteuerung nur, wenn der Inhalt absichtlich Firmware/Daten und kein ausführbares Format ist. Sobald die Analyse abgeschlossen ist, wechseln Sie zwischen zwei Arbeitsbereichs-Registerkarten:

- **Analyse** – deterministische Evidenzansichten: Zusammenfassung, Funktionen (filtern/paginieren), Importe, Strings, eine Abfrageansicht, ein Funktionsinspektor (Pseudocode, Querverweise, begrenzter Aufrufgraph, Hexdump) und – sofern der verbundene Ghidra-Dienst sie unterstützt – Typen, Globale, Sidecar-Annotationen, Archivexport und ein deterministisches Attack-Surface-Ranking mit erklärbaren positiven/mildernden Signalen und Evidenzabdeckung.
- **Chat** – der Assistent in einem von zwei Modi:
  - **Copilot** (Standard): ein begrenzter Schritt/Tool-Aufruf pro Nachricht für Ad-hoc-Fragen.
  - **Autonom**: einen benannten, budgetierten Workflow starten, der mehrere begrenzte Schritte eigenständig ausführt und während der Arbeit eine Live-Aktivitätszeitleiste anzeigt.

Beide Modi akzeptieren ein taskspezifisches **Schrittbudget** sowie eine Option **Ohne Schrittlimit**, die läuft, bis die Aufgabe abgeschlossen ist (weiterhin durch `MAX_STEP_BUDGET` begrenzt, sodass ein sich wiederholendes Modell nicht davonlaufen kann). Wenn ein Lauf sein Budget erreicht, meldet er Teilergebnisse und bietet **Weiter** an – das setzt dieselbe Konversation unter Verwendung der bereits abgerufenen Evidenz fort, ohne abgeschlossene Tool-Aufrufe zu wiederholen. Die Kosten steigen mit der Anzahl der Tool-/Modellaufrufe; höhere Budgets kosten also mehr.

Verfügbare Workflows:

| Workflow | Zweck | Erfordert eine Ziel-Funktionsadresse |
| --- | --- | --- |
| `program_triage` | Den wahrscheinlichen Zweck des Programms aus Metadaten, Importen, Strings und Funktionen zusammenfassen. | Nein |
| `suspicious_behavior` | Zuerst deterministische Indikatoren aufzeigen, dann begrenzte, klar gekennzeichnete Hypothesen. | Nein |
| `selected_function` | Eine Funktion dekompilieren und sie mit ihren Aufrufern/Aufgerufenen erläutern. | Ja |
| `call_chain` | Eine begrenzte native/synthetisierte Aufrufgraph-Umgebung ausgehend von einer Startfunktion erkunden. | Ja |
| `attack_surface_triage` | Deterministische Score-Abdeckung/Top-K lesen, dann höchstens drei Kandidaten eingehend untersuchen; Scores sind Prioritäten, keine Urteile. | Nein |
| `vulnerability_hypothesis` | Einen begrenzten Kandidaten auswählen und Evidenz, Gegen-Evidenz und offene Fragen präsentieren; bestätigt niemals automatisch. | Nein |

### Fokussierte Teiluntersuchungen

Jeder Analyseauftrag hat einen **Haupt**-Chat plus optionale fokussierte Unterthreads. Wählen Sie **Neue Teiluntersuchung**, geben Sie eine einzeilige Kurzbeschreibung ein und arbeiten Sie mit einem frischen Konversationskontext über dieselbe Binärdatei und dieselben schreibgeschützten Tools. Thread-Verläufe bleiben isoliert, und es streamt jeweils nur ein Thread.

Wenn die fokussierte Arbeit fertig ist, wählen Sie **Schlussfolgerung an übergeordneten Thread zurückgeben**. Rev·Deck führt genau einen begrenzten Modellaufruf auf diesem Unterthread aus, validiert seine Evidenzzitate und fügt dem übergeordneten Thread eine mit Herkunftsnachweis versehene Schlussfolgerungskarte hinzu. Der vollständige Zweig lässt sich erneut öffnen, während der übergeordnete Kontext nur die kompakte Schlussfolgerung erhält – nicht das Transkript des Zweigs. Eine zurückgegebene Karte ohne validierte Zitate wird ausdrücklich als nicht verifiziert markiert.

Antworten des Assistenten zitieren Evidenz inline als `[function:0xADDR]`, `[string:0xADDR]` oder `[import:name]`. Zitate werden mit dem abgeglichen, was während des Turns tatsächlich abgerufen wurde; ein Zitat, das nicht übereinstimmt, wird als „(unverified)“ markiert und sollte als unbestätigte Behauptung behandelt werden, nicht als Tatsache.

Mermaid-Diagramme in der Assistentenausgabe (z. B. Aufrufgraph-Skizzen) werden in einem Sandbox-Frame ohne externen Netzwerkzugriff gerendert.

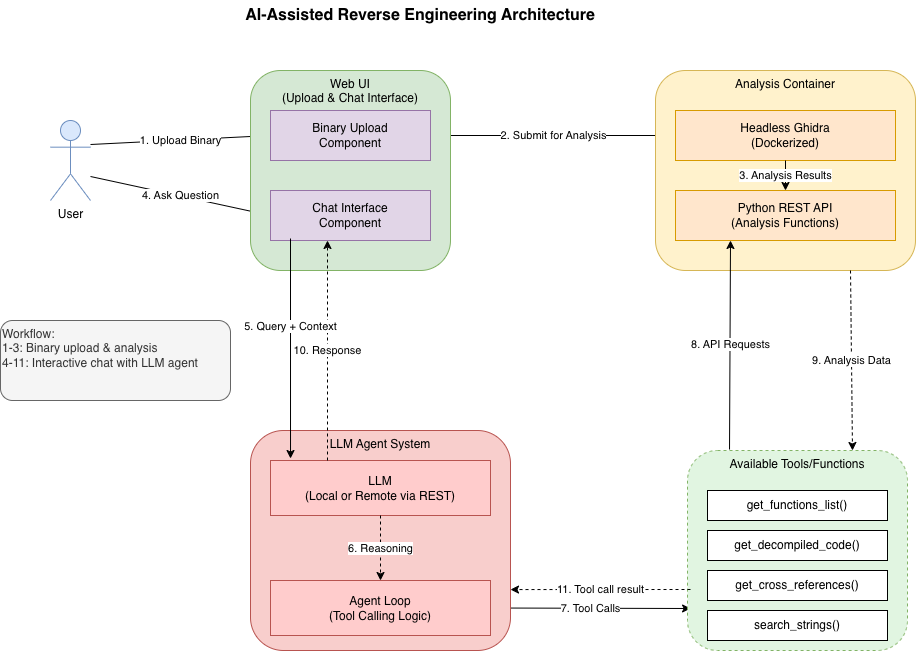
## Architektur

Der Browser kommuniziert nur mit der Rev·Deck-Webanwendung. Rev·Deck koordiniert das konfigurierte LLM und den Headless-Ghidra-Dienst und präsentiert die resultierende Evidenz und Agentenaktivität in einem Arbeitsbereich.

<img width="916" height="651" alt="Rev·Deck-Architektur" src="https://assets.kitploit.com/production/public/readmes/9561/40809484745cf03bf42790c8abff0146755ebb953a3774c8fac17fbc3c0552de.png" />

## Ausführung aus dem Quellcode

```bash
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
npm ci && npm run vendor        # one-time: vendors the pinned Mermaid runtime

cp .env.example .env            # edit API_BASE / MODEL_NAME / API_KEY
set -a; source .env; set +a     # plain Python does not load .env automatically

# Start the separate Ghidra service, then:
python webui/app.py
```

Öffnen Sie http://127.0.0.1:5000. Docker Compose liest `.env` automatisch; bei der Ausführung aus dem Quellcode muss es wie oben gezeigt exportiert werden. Der Flask-Entwicklungsserver ist für die lokale Nutzung geeignet; das Docker-Image verwendet Gunicorn.

## Sicherheit / ausschließlich lokale Nutzung

Dies ist für eine vertrauenswürdige Analystin bzw. einen vertrauenswürdigen Analysten am eigenen Rechner konzipiert – nicht für Mehrbenutzer- oder öffentliches Hosting. Standardmäßig binden die App und der Ghidra-Dienst nur an `127.0.0.1`, der Debug-Modus ist deaktiviert, hochgeladene Binärdateien werden niemals ausgeführt und der LLM-Anbieterschlüssel bleibt serverseitig.

## Testen

```bash
pip install -r requirements.txt -r requirements-dev.txt
python -m pytest
node --test "webui/static/js/tests/**/*.test.mjs"
npm ci && npm run vendor:verify   # verifies the vendored Mermaid bundle's integrity
```

## Fehlerbehebung

- **„Service offline“ / `/readyz` gibt 503 zurück** – der Ghidra-Dienst ist unter `GHIDRA_API_BASE` nicht erreichbar, oder `API_BASE`/`MODEL_NAME` ist nicht gesetzt.
- **Types/Globals/Annotations zeigen „requires v1“** – der verbundene Ghidra-Dienst weist diese Fähigkeit nicht aus; bei älteren Diensten zu erwarten.
- **Chat bricht sofort mit einem Fehler ab** – prüfen Sie `API_BASE`/`API_KEY`/`MODEL_NAME` und dass der Anbieter innerhalb von `LLM_TIMEOUT` erreichbar ist.
- **Upload wird als zu groß abgelehnt** – erhöhen Sie `MAX_UPLOAD_BYTES`.
- **Upload sieht nach Klartext aus** – Rev·Deck fragt nach, bevor es an Ghidra gesendet wird; nur bei Absicht als Rohbinary fortfahren.
- **Große Analyse läuft in einen Timeout** – erhöhen Sie `ANALYSIS_TIMEOUT` des Ghidra-Containers (z. B. `5400` für C++/Android-Binärdateien mit 10.000+ Funktionen) und laden Sie erneut hoch. `LLM_TIMEOUT` steht damit in keinem Zusammenhang.
- **Ein Zitat zeigt „(unverified)“** – das Modell hat Evidenz zitiert, die es nie tatsächlich abgerufen hat; behandeln Sie diese Behauptung als unbestätigte Hypothese.
