
 jev-sec/jev-ids
نظام كشف التسلل (IDS) فائق السرعة وذو كفاءة عالية في استهلاك الرموز، مبني على Jev من TypeSafe.


كشف التسلل في طلب واحد. اعرض على Jev من TypeSafe تدفق شبكة واحدًا وخمسة أمثلة موسومة. يجيب عمّا إذا كان التدفق هجومًا وأي نوع، في نصف ثانية، دون أي نص لتحليله.
اختُبر Jev IDS على NSL-KDD، وهو معيار مرجعي لمجتمع الأمن السيبراني، مقابل نموذج LLM متقدم (Gemini 3.6 Flash على Vertex AI)، ونموذج تعلّم آلي كلاسيكي (Random Forest) وآخر غير خاضع للإشراف (Isolation Forest): 2,000 تدفق، وثلاث بذور، وk من 0 إلى 8 أمثلة لكل فئة. وبالنظر إلى الأمثلة الخمسة نفسها (k = 1)، كان Jev IDS:
LLM هو الكاشف الأفضل على F1: 0.880 مقابل 0.856 لـ Jev عند k = 1، ومتقدّم عند كل قيمة k (اختبار McNemar p < 0.001)، لأنه يلتقط هجمات أكثر من الأنواع المعروضة في الأمثلة. Jev هو الثاني في الترتيب، وفي هجمات اليوم صفر، وهي أنواع غائبة عن الأمثلة، يلتقط أكثر من LLM من k = 1 إلى k = 8 (0.747 مقابل 0.713 عند k = 1). الأرقام والرسوم وحدودها في الأدلة والحدود وdocs/results.md.
اقرأ الحلقة · قالب الطلب · المعجم
Jev هو System One Model. فبدلًا من كتابة نص، يقرأ state ويجيب عن أسئلة مُنمّطة حوله باحتمالات. يضع Jev IDS تدفقًا واحدًا في الحالة، إلى جانب التعليمات وأسماء الأعمدة وأوصاف الفئات الخمس والأمثلة الموسومة، ويطرح سؤالين. يعود is_attack كاحتمال. ويعود category كأحد خمسة خيارات مع درجة ثقة. ويكون الحكم هجومًا عندما يبلغ الاحتمال 0.5.
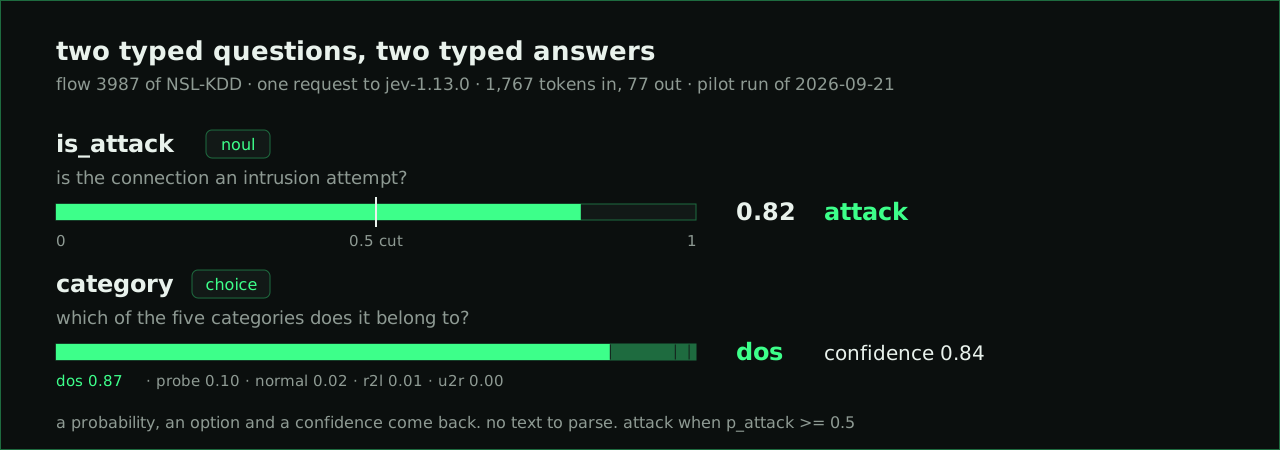
كل طلب يتبع المسار نفسه:
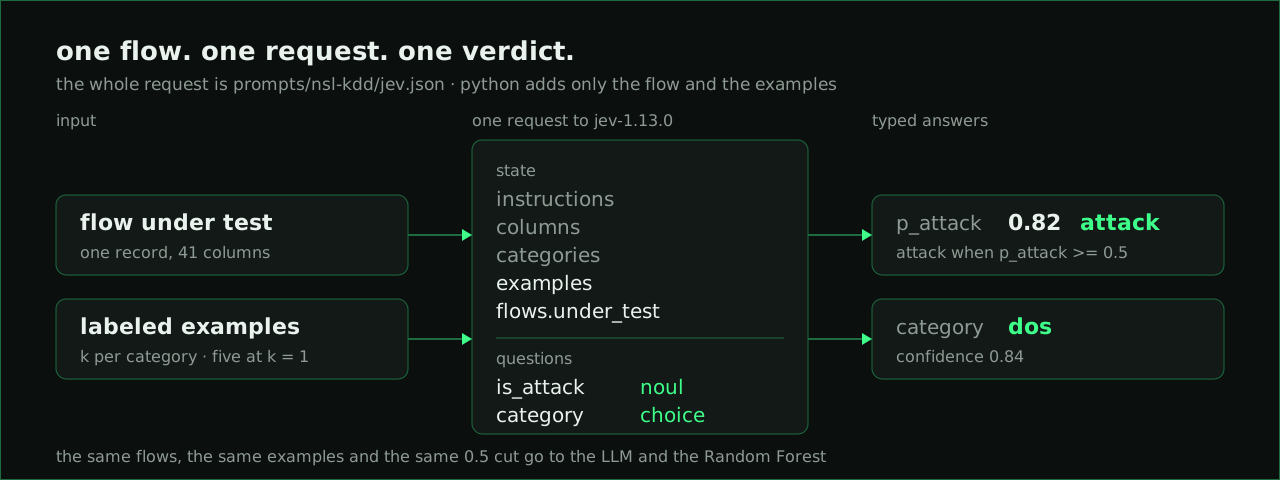
الطلب بأكمله ملف واحد، prompts/nsl-kdd/jev.json. لا يضيف Python سوى التدفق والأمثلة، ويسافر sha256 الخاص بالملف في كل صف تنبؤ باسم prompt_hash، لذا لا تُقارَن أبدًا التشغيلات التي طلبت أشياء مختلفة على قدم المساواة. تُوسَم الأمثلة حسب الفئة فقط: أسماء الهجمات مثل neptune لا تصل أبدًا إلى أي نموذج.
التدفقات والأمثلة نفسها وحد 0.5 نفسه تذهب إلى خطي أساس: نموذج LLM عبر وكيل Agno مع مخطط إخراج JSON (Gemini 3.6 Flash عبر Vertex AI في الورقة البحثية؛ وGPT-5.6 عبر الواجهة الخلفية لـ ChatGPT Codex أو DeepSeek كبدائل) وRandom Forest من scikit-learn مدرَّب على الأمثلة نفسها. أما خط الأساس الثالث، وهو Isolation Forest مُلاءَم على التدفقات الحميدة من المجمّع وحده، فلا يرى أي مثال أبدًا: إنه المرجع غير الخاضع للإشراف، عند k = all فقط.
git clone https://github.com/jev-sec/jev-ids.git
cd jev-ids
uv sync
# .env: TYPESAFE_API_KEY for Jev. Gemini needs `gcloud auth application-default login` and GOOGLE_GENAI_USE_VERTEXAI=true,
# GOOGLE_CLOUD_PROJECT and GOOGLE_CLOUD_LOCATION=global in the environment; DEEPSEEK_API_KEY and CHATGPT_CLIENT_ID only for the other LLMs.
نزّل NSL-KDD إلى data/raw/nsl-kdd/ وجهّزه مرة واحدة:
uv run python -m scripts.prepare_nsl_kdd
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split smoke --k 0,1
تقسيم smoke هو خمسة تدفقات. يكتب التشغيل results/<timestamp>-nsl-kdd-jev-smoke/ مع config.json، وصف JSON واحد لكل تدفق في predictions.jsonl (الحكم، والحقيقة، وp_attack، والفئة، ودرجة الثقة، وزمن الاستجابة، وتقرير الرموز من البوابة) والإجابات الخام في responses.jsonl.
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split pilot --k 0,1,2,4,8 --seeds 0,1,2
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector llm:gemini --model gemini-3.6-flash --split pilot --k 0,1,2,4,8
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector random_forest --split pilot --k 1,2,4,8,all
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector isolation_forest --split pilot --k all
uv run jev-ids metrics results/<run_id> [results/<run_id> ...] > results/summary.csv
uv run jev-ids compare --a results/<jev_run> --b results/<rf_run> --subset novel --k-a 0 --k-b all  # novel = zero-day attacks
k هو عدد الأمثلة الموسومة لكل فئة. k = 1 مع خمس فئات يعني خمسة أمثلة، وall تعني المجمّع بأكمله. يطبع metrics صف CSV واحدًا لكل كاشف وk مع F1، والاستدعاء على هجمات اليوم صفر (novel في الشيفرة) ولكل فئة، وPR-AUC وROC-AUC لـ p_attack، والرموز، وزمن الاستجابة، والتكلفة. ويقرن compare تشغيلين تدفقًا بتدفق ويجري اختبار McNemar على الأزواج المتنافرة، لأن التدفقات التي يختلف عليها كاشفان فقط هي التي تميّز بينهما. تُحسب التكلفة دون اتصال كالرموز مضروبة في أسعار القائمة في prices.json، لكل كاشف على حد سواء.
يحدّد docs/protocol.md المدخلات (تقسيم paper ذو 2,000 تدفق، والمطالبات، ومعرّفات النماذج، والأسعار) ويشغّل make paper الكواشف الأربعة على ذلك التقسيم إلى results/paper/ ويكتب results/paper/summary.csv. لكل كاشف هدفه الخاص (make paper-jev، make paper-llm، make paper-random-forest، make paper-isolation-forest)، لذا يمكن تشغيلها في نوافذ طرفية منفصلة؛ وLLM هو البطيء. يشغّل make paper-llm نموذج Gemini 3.6 Flash على Vertex AI كخمس عمليات متوازية، واحدة لكل k (make -j5 paper-llm)؛ وخطأ الحصة أو المهلة هو صف خطأ، ويعيد uv run jev-ids redo-errors results/paper/<run> الحكم على تلك التدفقات مجددًا في مكانها. الجداول والرسوم الكاملة في docs/results.md.
error، ويُحتسب كعدم إنذار. ولا يتعطل أبدًا.
