无需编译的仓库级结构智能。
文档 · 可视化工具 · 语言熔炉 · 关键词罗塞塔 · 原始输出
1 次扫描 · 97 个结构信号 · 50+ 种语言 · 无需编译 · 17 个风险暴露类别 · 6 种输出
GitGalaxy 直接从源文本构建整个仓库的语言无关结构图——无需构建,无需针对每种语言的工具链。
它专为多语言、部分损坏、遗留、供应商代码繁重或通过构建优先工作流难以分析的其他仓库而设计:
Go + C++ + Python + Java + Bash + YAML
+ generated code + vendored code + legacy code
+ half-migrated modules + broken dependencies
GitGalaxy 不是为每种语言使用单独的解析器,而是提取一组通用的结构签名词汇——函数、类、参数、控制流、状态变更、I/O、API、依赖——并将它们规范化为一个确定性的仓库模型,用于架构分析、风险暴露优先级排序、SBOM 生成、重构与归属分析、面向 AI 的代码库上下文,以及 CI/CD 门禁。
核心论点: 完整的语言解析并不总是必要的,在仓库规模上恢复高度有用的结构信息即可。
该论点如何被检验——对照 Tree-sitter 和 Ctags、对照一个植入的对照语料库,以及接下来对照 Git 历史——在下面的准确度,已测量中进行了总结,并在验证程序中完整阐述。
一条命令:
pip install gitgalaxy
galaxyscope path/to/repo
同一确定性扫描的六个协同视图:
| 输出 | 用途 |
|---|---|
| LLM 架构简报 | 面向机器/代理的紧凑上下文(见下文) |
| SARIF | CI/安全仪表盘集成 |
| CycloneDX SBOM | 依赖清单/合规性 |
| SQLite | 可查询的仓库知识图谱 |
| JSON 审计数据 | 取证/自动化工作流 |
| 3D 可视化数据 | 交互式仓库拓扑 |
旗舰报告是一份单一的 Markdown 简报,旨在为工程师——或 AI 代理——提供一份他们从未见过的仓库的可用心智模型。它是一个自包含的包:风险方程直接印在报告中,并且嵌入的解释提示让任何 LLM 都能对其进行叙述,而不会对数字的含义产生幻觉。各章节涵盖宏观状态与语言构成、网络拓扑(模块化、关节点、循环密度)、依赖瓶颈、最重的函数和文件、带 PageRank 影响范围的逐文件结构签名、定向和累积风险命中列表、供应链审计,以及按波动性和作者集中度排序的重构目标——外加一份它拒绝扫描的每个文件的逐项列表及原因。
两个示例,使用当前引擎于 2026-08-31 扫描。两个仓库都是公开的——克隆任意一个并运行 galaxyscope --llm-only <path> 即可复现完整简报:
curl — 4,250 个工件,扫描 696 个,112,653 行代码,涵盖 C、Perl、Python、Shell、M4 和 Makefile。简报将 src/tool_setup.h 列为顶级结构支柱(80 个入站连接),并将一个 Perl 函数——tests/ftpserver.pl 中的 APPEND_imap,影响值 2135,1,672 行代码——置于全仓库函数命中列表的顶部,与 C 代码处于同一排名中。这种跨语言图谱正是该产品:在整个仓库的每种语言中提供一套可比较的信号集。同一份简报中诚实的告诫:仅扫描了 16.4% 的工件——摄取过滤器会激进地丢弃二进制文件、生成代码和测试数据,简报的第 5 节按扩展名和原因逐项列出了每一项排除。
cics-genapp(IBM 的 CICS COBOL/DB2 示例)— 扫描率 92.1%:44 个 COBOL 程序,29 个 JCL 作业。累积结构表面命中列表以 base/src/lgupdb01.cbl 为首(变异表面约 100%,复杂度负载 92%),仓库中最重的段落是 UPDATE-POLICY-DB2-INFO——即 SELECT FOR UPDATE 行锁定逻辑,这正是该程序的维护者会首先想要查看的地方。同一份简报也直白地展示了一个局限:在扁平架构且没有真正导入图的情况下,“结构支柱”列表退化为零连接文件,报告建议在信任它之前先检查连接数。
数百份针对独立选定仓库的未经编辑的简报已提交至
gitgalaxy-raw-output;
本仓库自身始终最新的自扫描简报位于
docs/gitgalaxy_architecture_brief.md。
| 消费者 | 问题 |
|---|---|
| 架构 | 这个仓库由什么构成? |
| 结构分析 | 函数、类、API、依赖和控制结构在哪里? |
| 结构表面画像(原风险暴露) | 给定的结构/内容模式集中在哪里? |
| 重构 | 哪些文件复杂、高变更或承重? |
| 供应链 | 磁盘上实际存在哪些依赖? |
| AI 上下文 | 代理应该了解哪些架构和关系? |
| 遗留迁移 | 要转换的结构单元在哪里? |
| 历史分析 | 随着仓库演进,测得的暴露如何变化? |
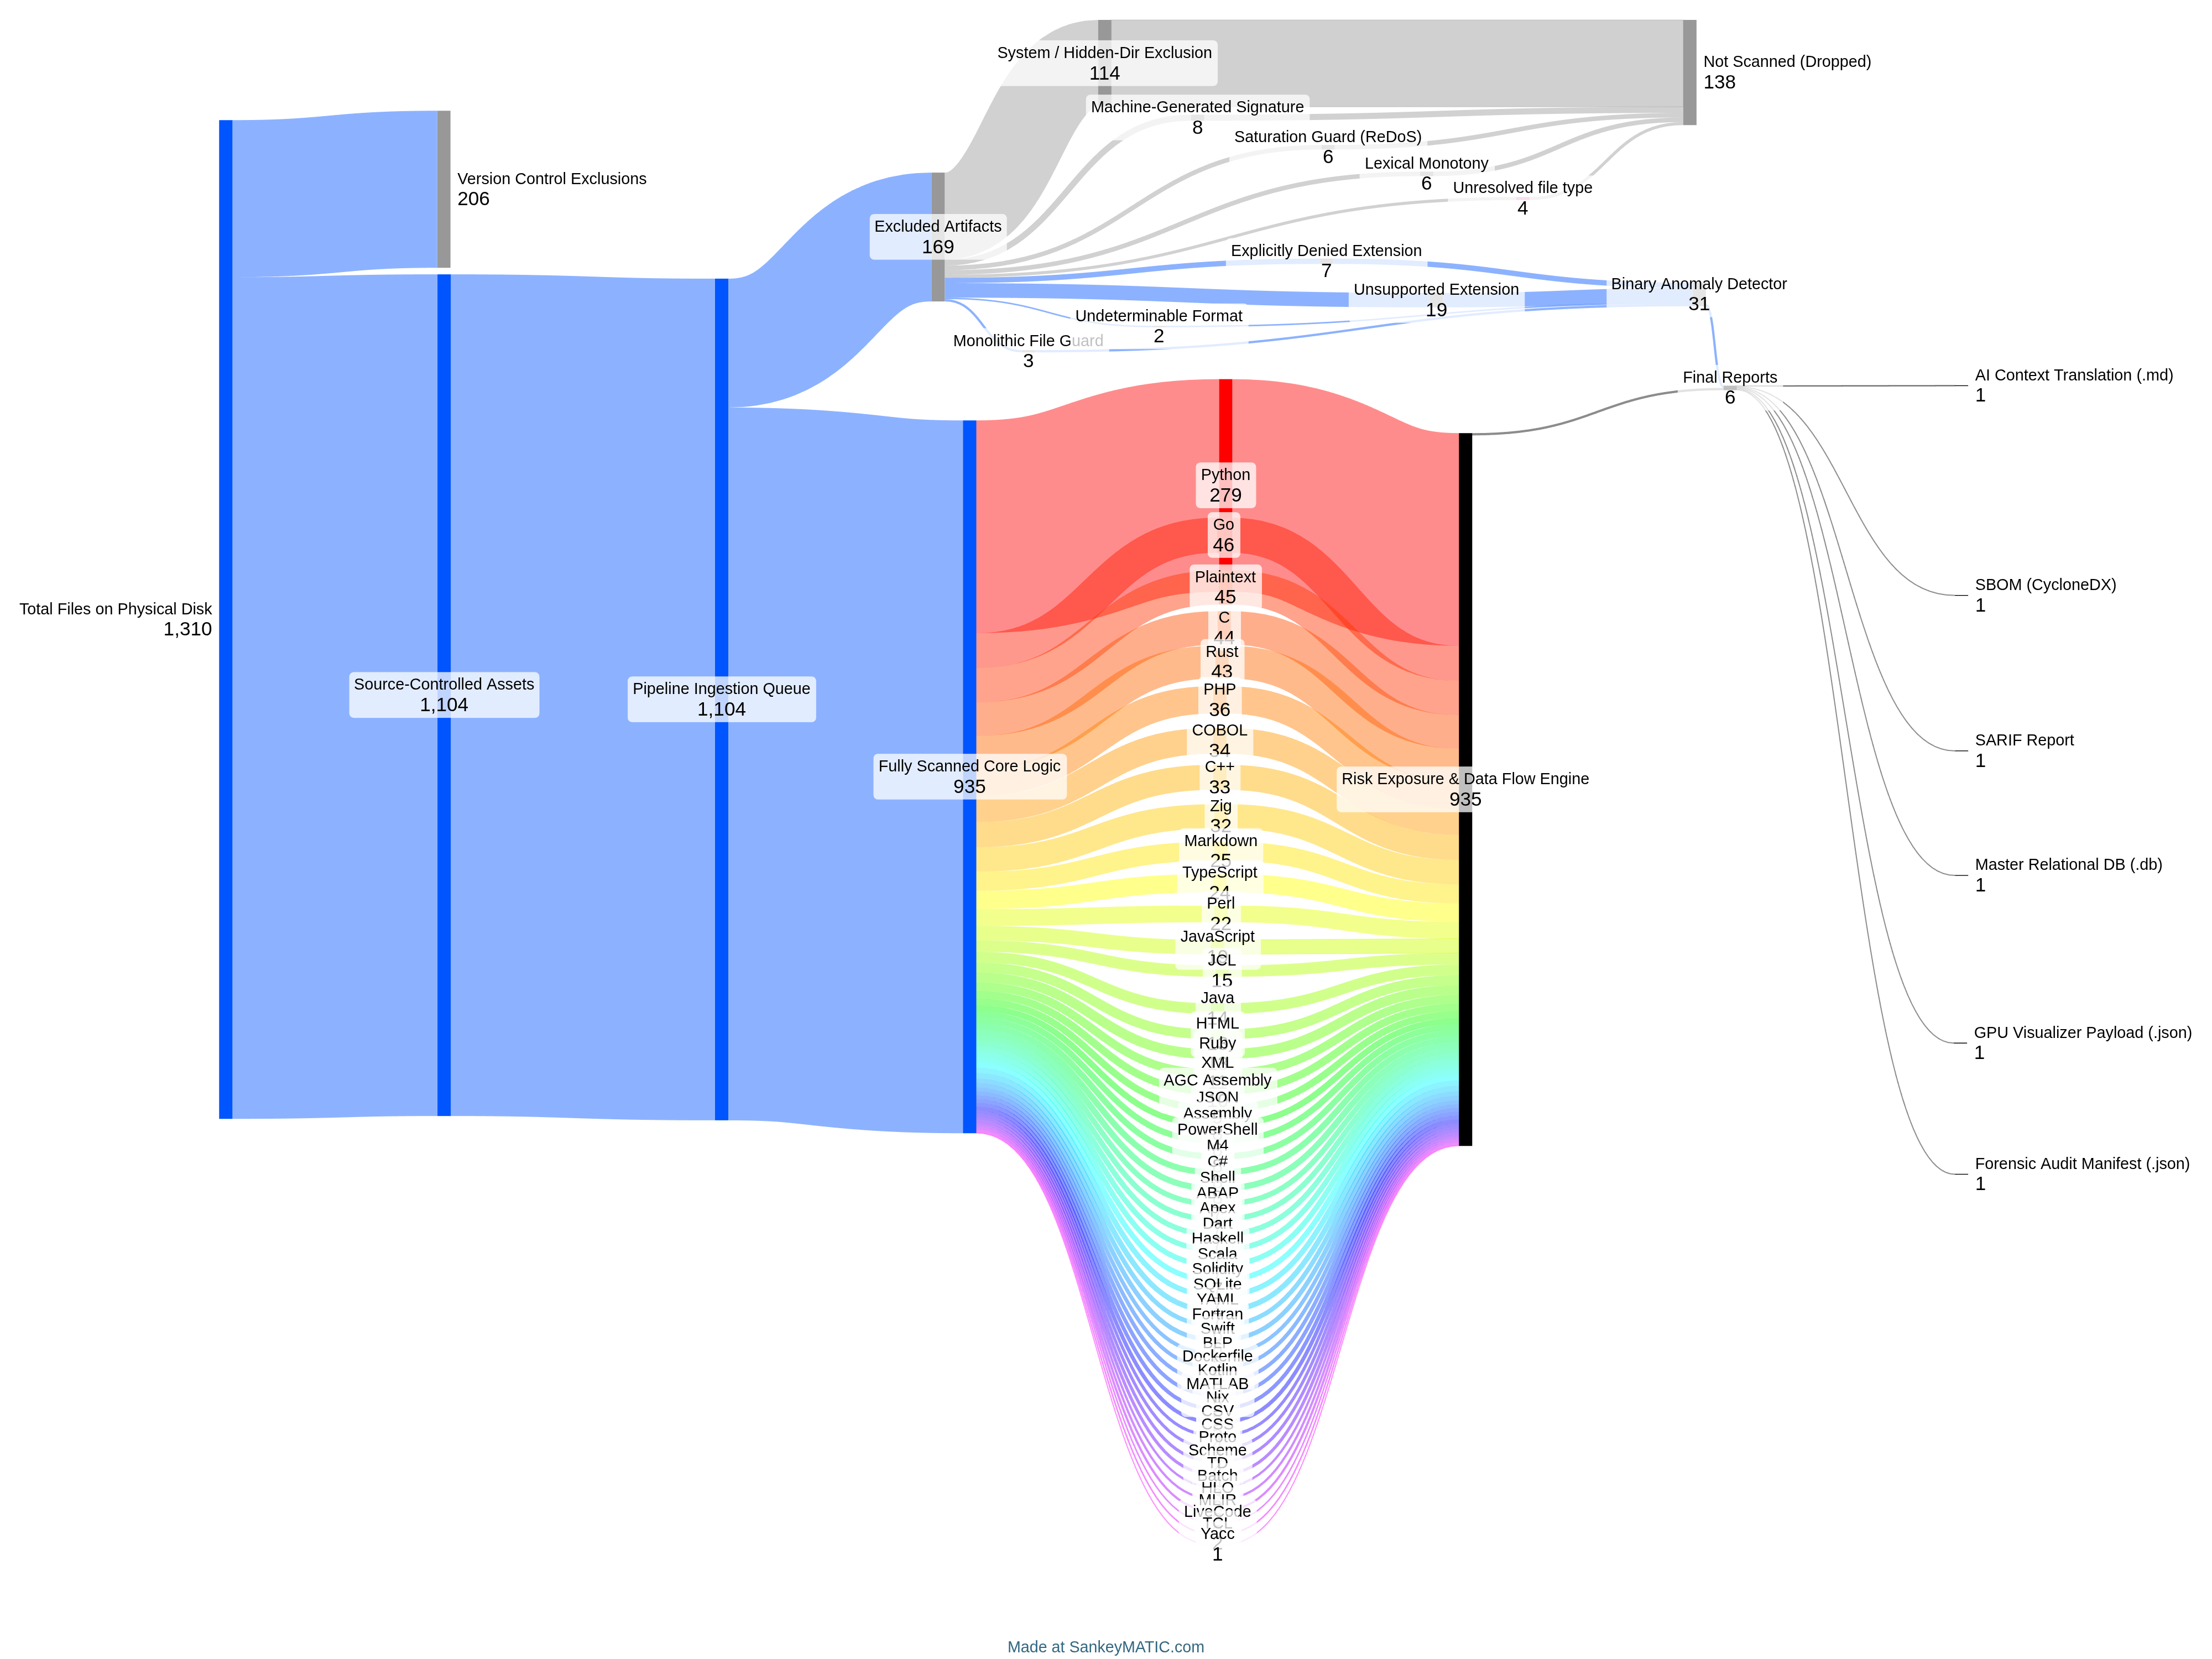
有两项常设测量计划为上述主张提供支持,第三项针对依赖和调用图的计划正在进行中。完整叙述——方法论、结论、局限以及后续计划——见 验证计划;此处为摘要。
GitGalaxy 在固定的 Language Crucible 语料库上与 Tree-sitter 和 Universal Ctags 进行基准对比——45 种语言中有 24 种获得全部三个工具,另有 13 种获得两个工具,每一处分歧都针对真实源代码进行调查并记录结论(201 个记录在案的分歧形态中有 200 个得到验证)。在该语料库上,GitGalaxy 在全部 31 种可与 tree-sitter 比较的语言中,经验证的函数精确率为 100%,并且在经过验证的类或参数分歧中,它从未是被发现错误的一方。局限:三个结构目标,一个固定语料库——并非泛指“解析得像 AST 一样准确”。

影响范围、PageRank 和“结构支柱”来自导入图。函数级排名来自调用图。目前并非每种语言都测量了这两个图,下图说明了哪些语言已测量:
截至 2026-09-26,在 59 种语言中:
导入图在 20 种语言中已测量。 引擎边会针对每种语言在固定的真实仓库上的自身导入语句进行检查
(import_graph_accuracy.py)。
被调用者名称在 11 种语言中已测量,对照 tree-sitter。
调用解析在 3 种语言中已测量,对照参考分析器:
一条调用链接一旦建立,通常是正确的,但大约一半或更多的调用未被链接。因此函数级扇入和 PageRank 是一个下界。
局限:
* 标记的数字表示仍有分歧等待对照源代码给出结论。弥补这些差距的计划是 epic #3772。

较新的计划提出了相反的问题:GitGalaxy 是否在每种语言中以相同方式测量相同意图?
keyword-rosetta 语料库
将相同的 12 探针程序植入全部 50 种受支持语言中,并具有精确已知的信号计数——因此任何偏差从构造上就是被测得的语言偏见。图表按原因而非大小给每个偏差着色:红色是未解决的引擎缺陷(规则匹配了错误的构造,或评分权重落在计数内部);灰色是账本已验证的已记录变异——该语言无法表达该构造、有意的评分选择,或另一行的回声。当前答案:平均而言,94% 的语言在每个受门控指标上处于跨语言中位数的 ±25% 范围内(56 个可图表化指标,54 个保持 ≥80%),并且未解决缺陷占比为 0.0%(59 个受门控指标中 2,844 个可比较单元格中的 1 个)——一个无法解释的单元格,即新植入的 bms(CICS Basic Mapping Support)语料库中的 classes_found;其他每个超出范围的单元格都是账本已验证的变异(严格性分层、该语言无法表达的构造、另一行的回声,或有意的评分选择),而非未解决的引擎缺陷。最弱的指标被点名而非隐藏——cog_raw 使 74% 的语言处于范围内,raw_arch_api 78%,avg_func_args 80%——但它们的次范围单元格是已记录的,而非缺陷。
该主张在扩展后依然成立:当语料库植入其首个安全透镜探针时——每种语言中一个相同的硬编码密钥——
credential_material(原 risk_secrets_risk;risk_* 名称仍为数据库列——见 docs/vectors.md)在全部 50 种语言中读取到统一分数(每列相同的 25.000)。该透镜最初跳过的两个惰性格式例外,以及公式测得的长度依赖性,当天即被记入账本并提交
(#2978、
#2979)。#2978 已关闭:该透镜现在在所有五种惰性格式上运行
(plaintext/markdown/json/yaml/csv),并提供 SECURITY_SCAN_INERT_FORMATS 配置退出选项,适用于那些认为这样做会以过多文档/配置噪声换取覆盖率的仓库,并且 keyword-rosetta 的语料库针对合并修复的重新验证现在完全落在范围内(账本的 secrets-lens-inert-formats 条目)。
每个偏差都记录在已验证的账本中,工作按原因族在契约路线图下跟踪,以这种方式发现的缺陷类别
作为 GitGalaxy 问题提交。
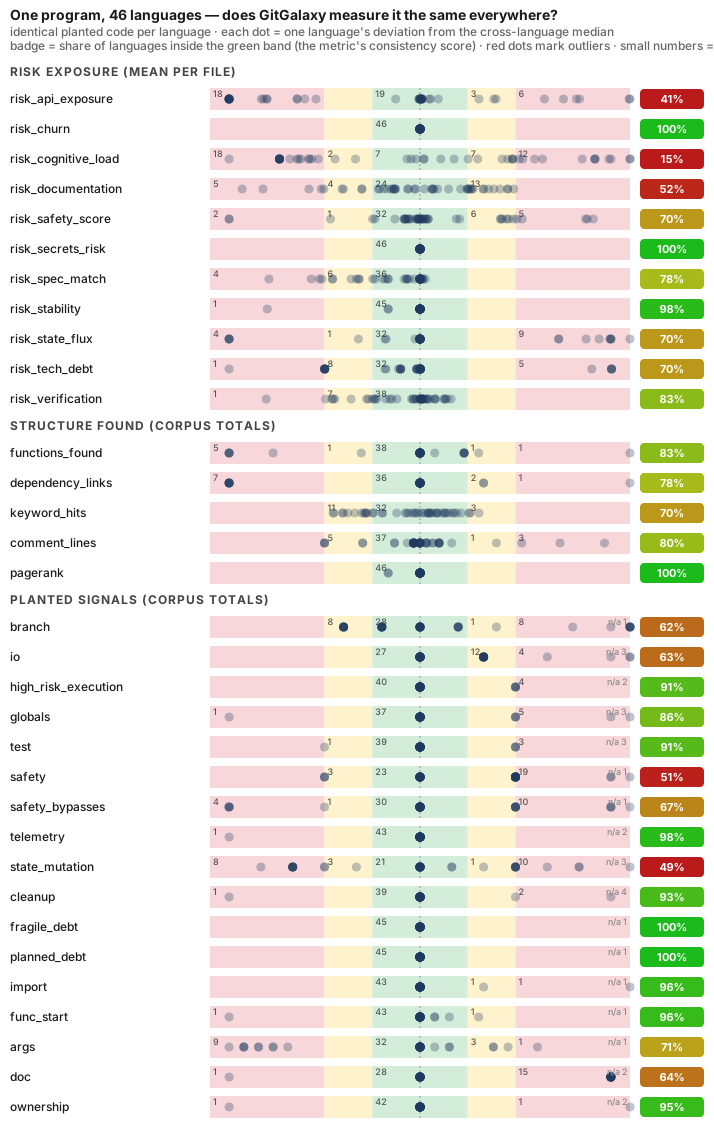
对照语料库证明了相同意图上的测量不平等;它并未说明真实代码上的准确性(那是上文三方对比的工作)——而且每文件恒定偏差仍会保留语言内部的排名。 发生率报告 针对真实授权代码衡量每个已确认形态的规模。
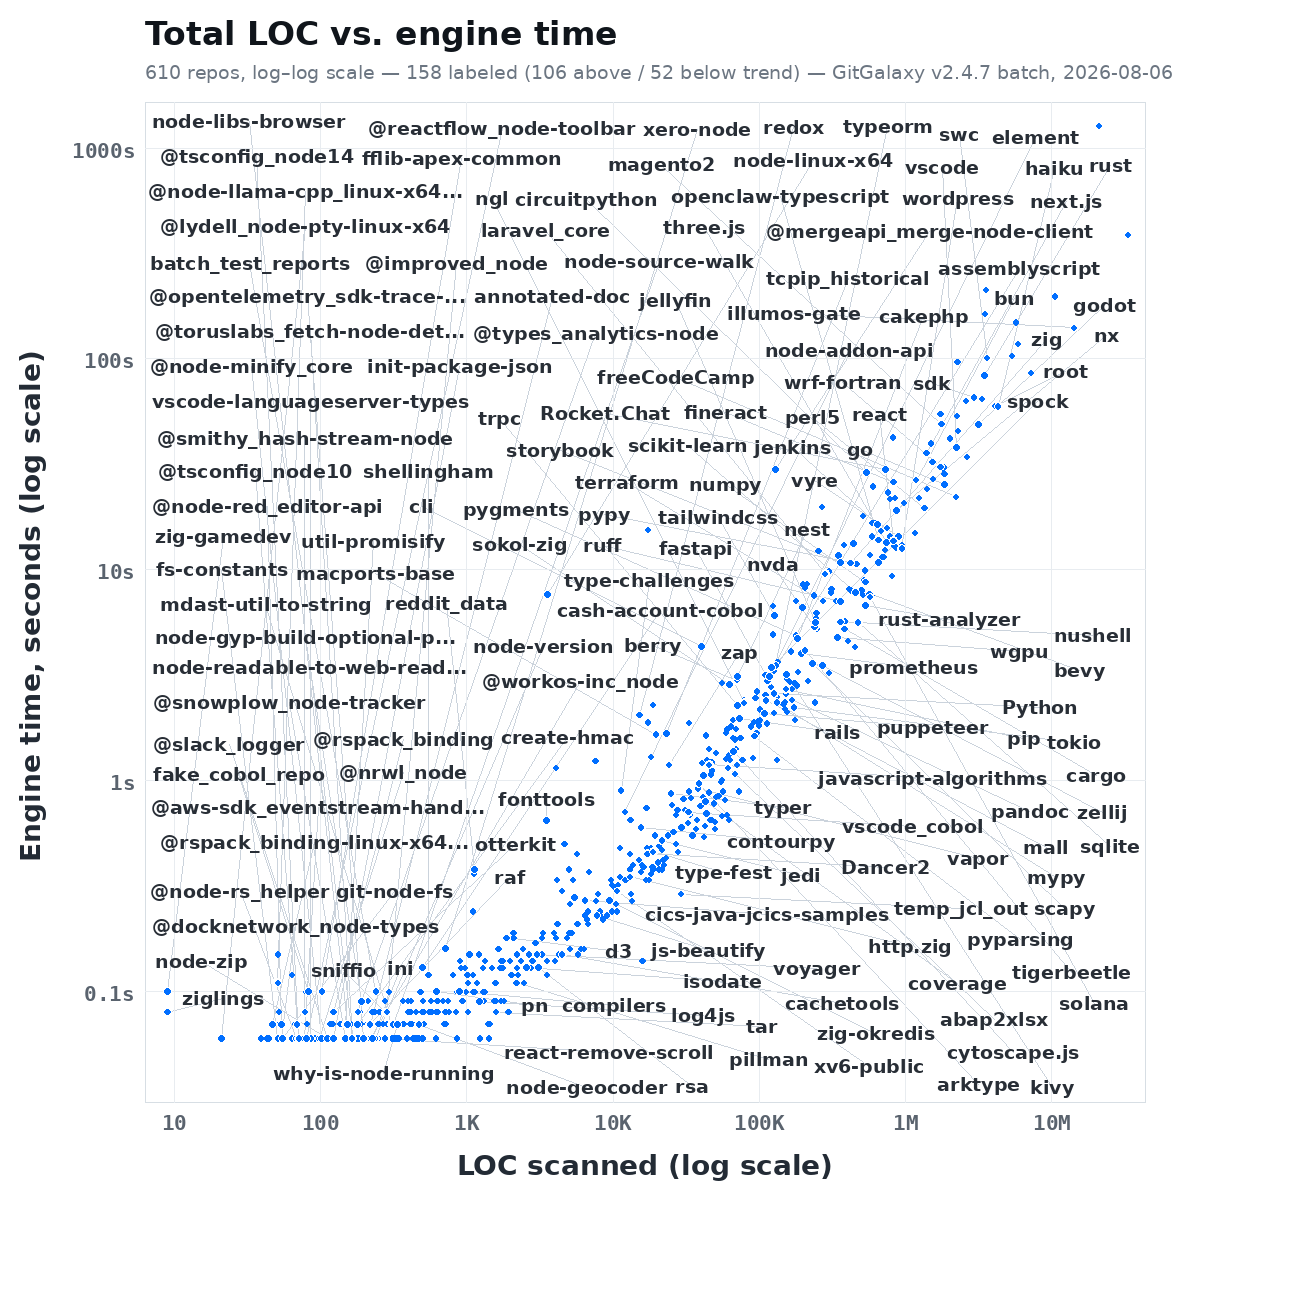
示例:Kubernetes — 约 139 万行,涵盖 Go、YAML、JSON、Shell 和 Proto。
端到端扫描:50.83 秒。扫描时间遵循拟合的双区间模型
(在约 4.3K 行代码以下平坦约 0.11 秒,然后 time(s) ≈ 3.36e-05 × LOC^0.969,在 599 个仓库上 R²=0.88)——因此少数 2000 万行以上的离群值仍需数分钟,而快速扫描证明的是吞吐量,而非洞察质量;准确性问题在下文单独处理。
参见原始输出 仓库获取 未经编辑的工件。
GitGalaxy 的 13 个逐文件向量最初命名为 risk_*,并被描述为
风险暴露测量。本节过去留下的问题——
“这些签名是否在经验上与有意义的软件风险类别相关联?”——此后已被测试,而不仅仅是提出。时间熔炉验证计划(epic
#2982,约 3,550 个
扫描快照,两个仓库,三个标签族,每个测试在查看数据之前预先注册)将该实验运行到
极致,而诚实的结果促成了重命名
(#2991):
这些向量现在称为结构表面画像。risk_* 仍为
数据库列 / JSON 键名以保持兼容(见
docs/vectors.md 获取完整名称表和弃用说明)。
记录所发现的内容,诚实重述: