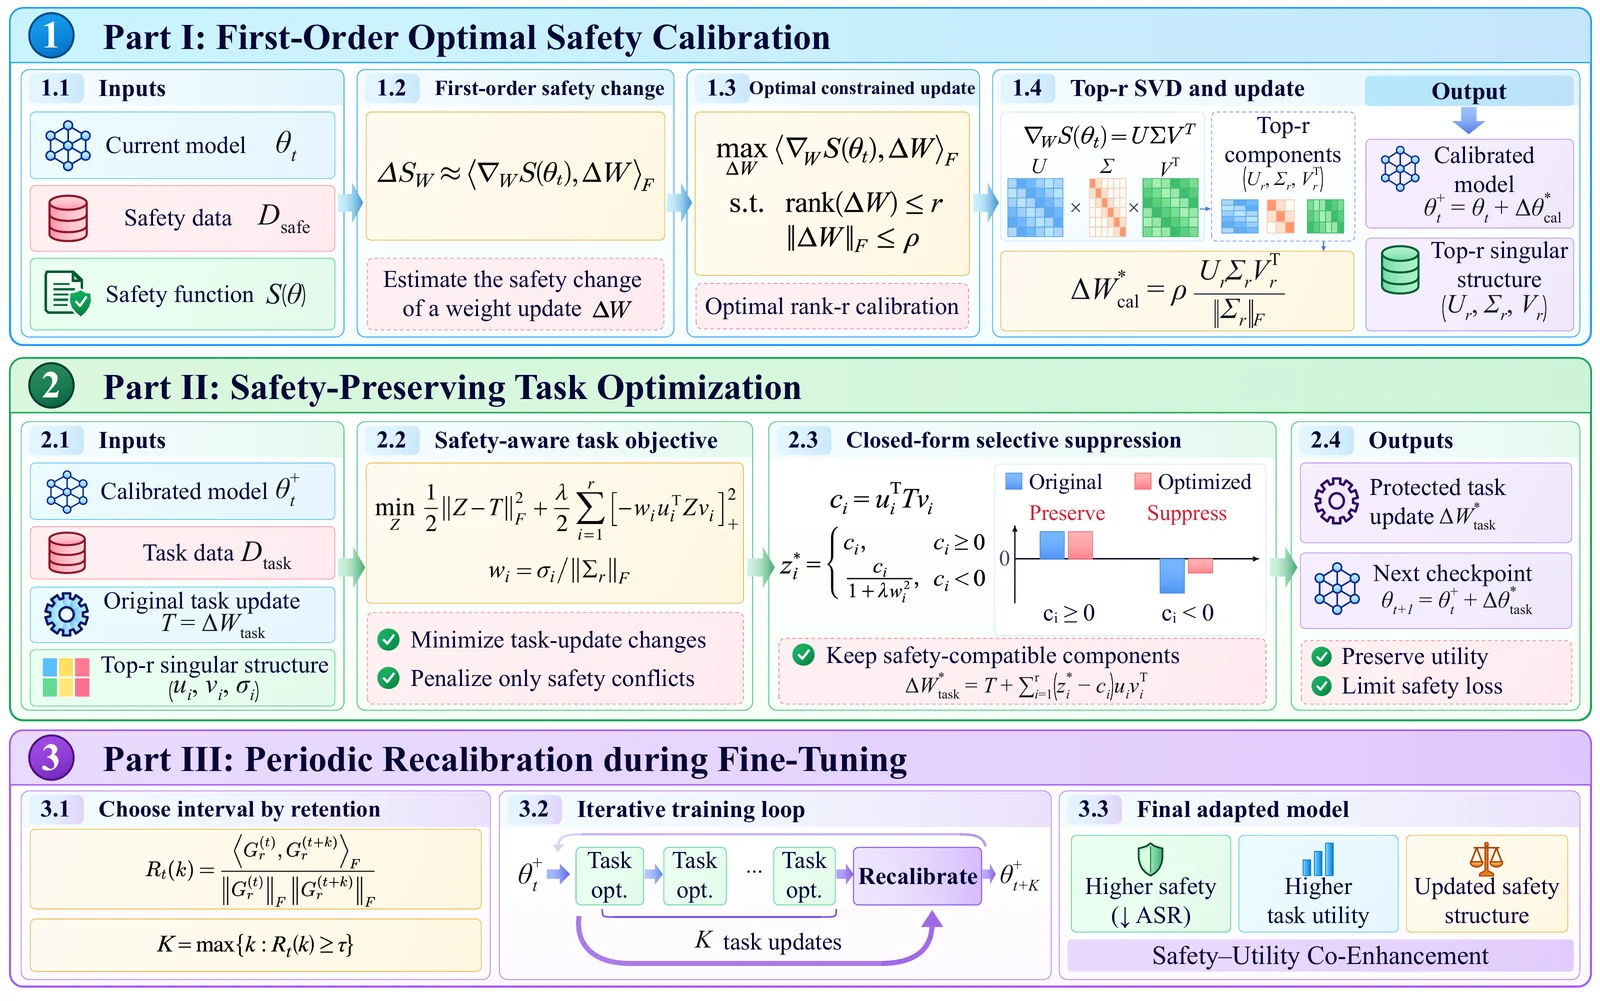
通过重校准实现安全–效用协同增强的一阶最优微调
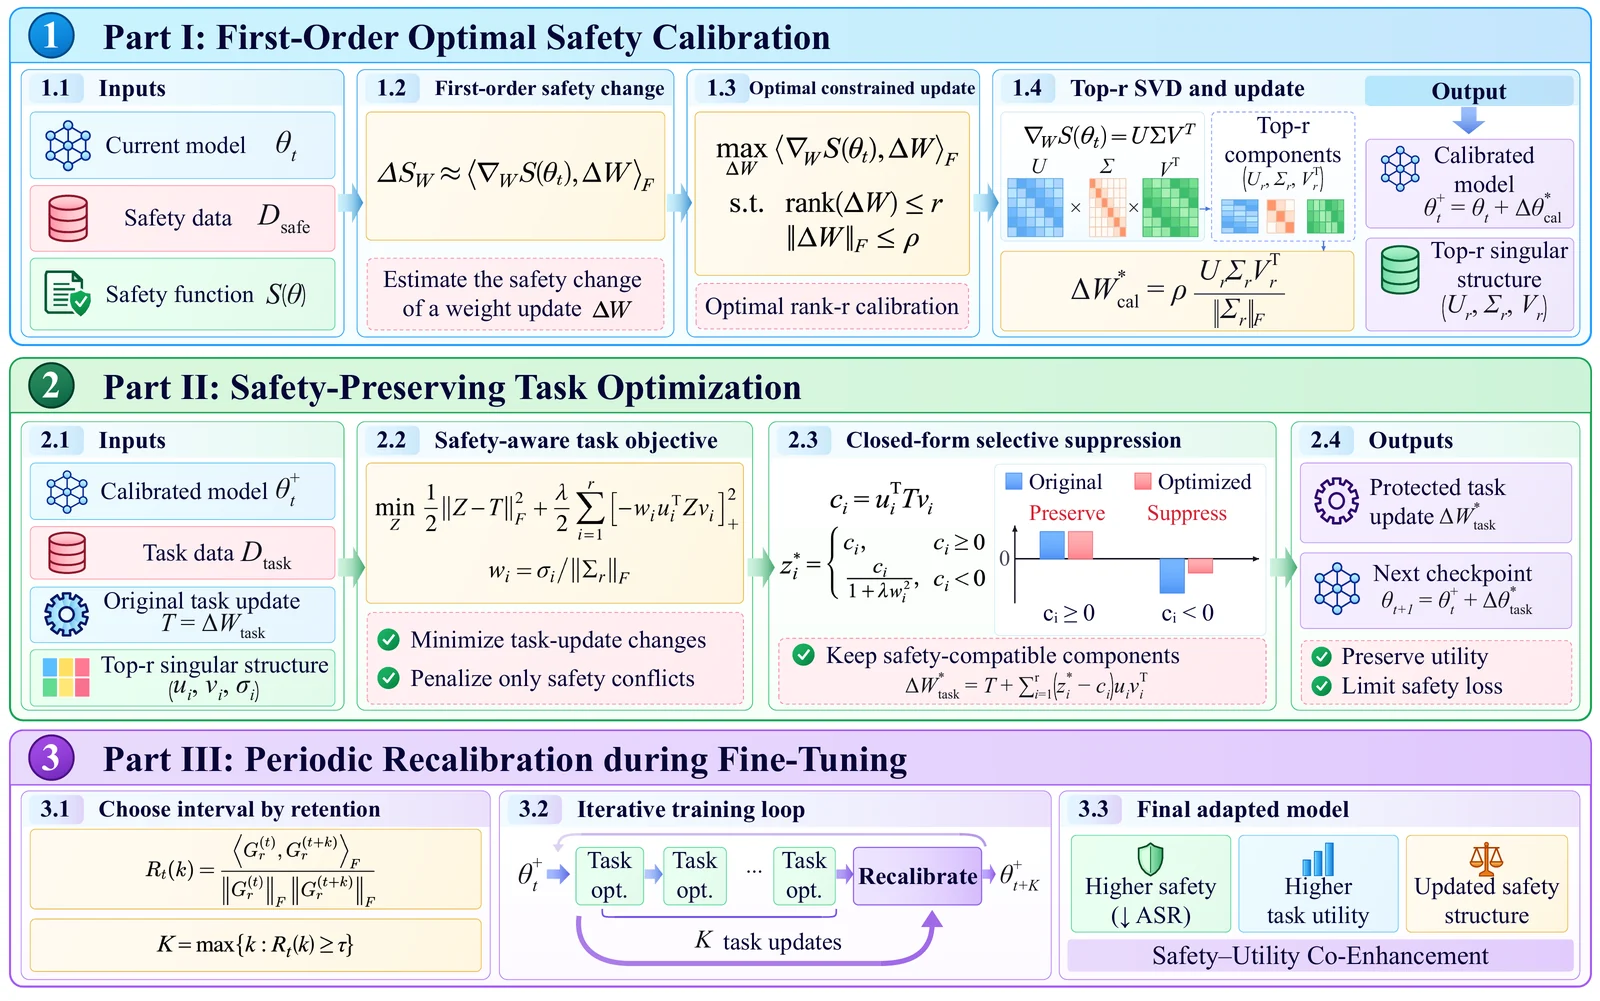
ASCENT 推导出一阶最优安全校准更新及相应的安全相关结构,优化下游任务更新以保留安全兼容组件并抑制安全退化组件,并在微调过程中定期重校准该结构,从而协同提升安全性和下游效用。
config.toml 中设置。环境要求: Python 3.12 和本地模型检查点。训练使用两块 CUDA GPU,一块用于目标模型,一块用于 Llama Guard;每个模型必须能放入其 GPU。
pip install -r requirements.txt
cp config.example.toml config.toml
按照 config.toml 中的行内注释填写空值,然后运行:
python run.py \
  --config config.toml \
  --model-path /path/to/target-model \
  --guard-model-path /path/to/Llama-Guard-3-8B \
  --data-root data \
  --output-dir /path/to/new-run \
  --target-gpu 0 --guard-gpu 1
添加
--execute以进行训练、生成响应或保存评估结果。
选择一个位于仓库之外、有足够空间存放检查点的新输出目录。 训练完成时会打印最终合并模型的路径。
提供包含所配置记录数量的 JSON 数组:
<data-root>/calibration/prompts.json<data-root>/<task>/{train,test}.json,训练/测试输入互不重叠。| 数据集 | 必需字段 |
|---|---|
| SAMSum | dialogue、summary |
| AGNews | text、label_name:World、Sports、Business 或 Sci/Tech |
| GSM8K | question、answer,其中包含 #### 最终答案 |
| OpenBookQA | question_stem、choice_labels:["A","B","C","D"]、四个 choice_texts、answer_key:A–D |
| HarmBench | 仅 goal;可选 id、source;不存储响应 |
在 config.toml 中设置你的模型、任务和超参数。模型加载
和矩阵选择遵循 model.key。
两种模式均使用 evaluate.py;生成需要完全合并的本地模型。
请提供你自己的数据和外部安全评分。不捆绑任何数据集、在线评判器或
API 配置。
python evaluate.py utility --task gsm8k --data /path/to/test.json \
  --model-path /path/to/merged-model --output-dir /path/to/task-evaluation --execute
任务:samsum、agnews、gsm8k、openbookqa。指标为 SAMSum 的 ROUGE-L
以及其他任务的准确率/精确匹配,以百分比报告。要对已保存的
响应进行评分,请将 --model-path 替换为 --responses /path/to/responses.json。
将固定提示作为记录提供,包含 id、goal 以及可选的 prompt(默认为
goal)。将原始有害目标与攻击提示分开保存。
生成响应:
python evaluate.py safety --data /path/to/prompts.json \
  --model-path /path/to/merged-model --output-dir /path/to/safety-responses --execute
汇总外部评分:
python evaluate.py safety \
  --responses /path/to/safety-responses/responses.json --judgments /path/to/scores.json \
  --output-dir /path/to/safety-metrics --execute
评分为 JSON 记录 { "id": "...", "score": 1 },使用响应 ID 和
1–5 的评分(失败的评判为 null)。评分 4–5 计为成功攻击;
使用 --success-threshold 5 可仅计 5 分。缺失或失败的评判不会产生最终 ASR。
对于任一模式,经过聊天格式化后超过 --max-input-tokens 的输入
会被拒绝,而非截断。请在模型的上下文容量内设置该限制,
为生成的 token 留出空间。