本代码库包含论文 Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges 的代码,作者为 Ruomeng Ding*、Yifei Pang*、He Sun、Yizhong Wang、Steven Wu 和 Zhun Deng。
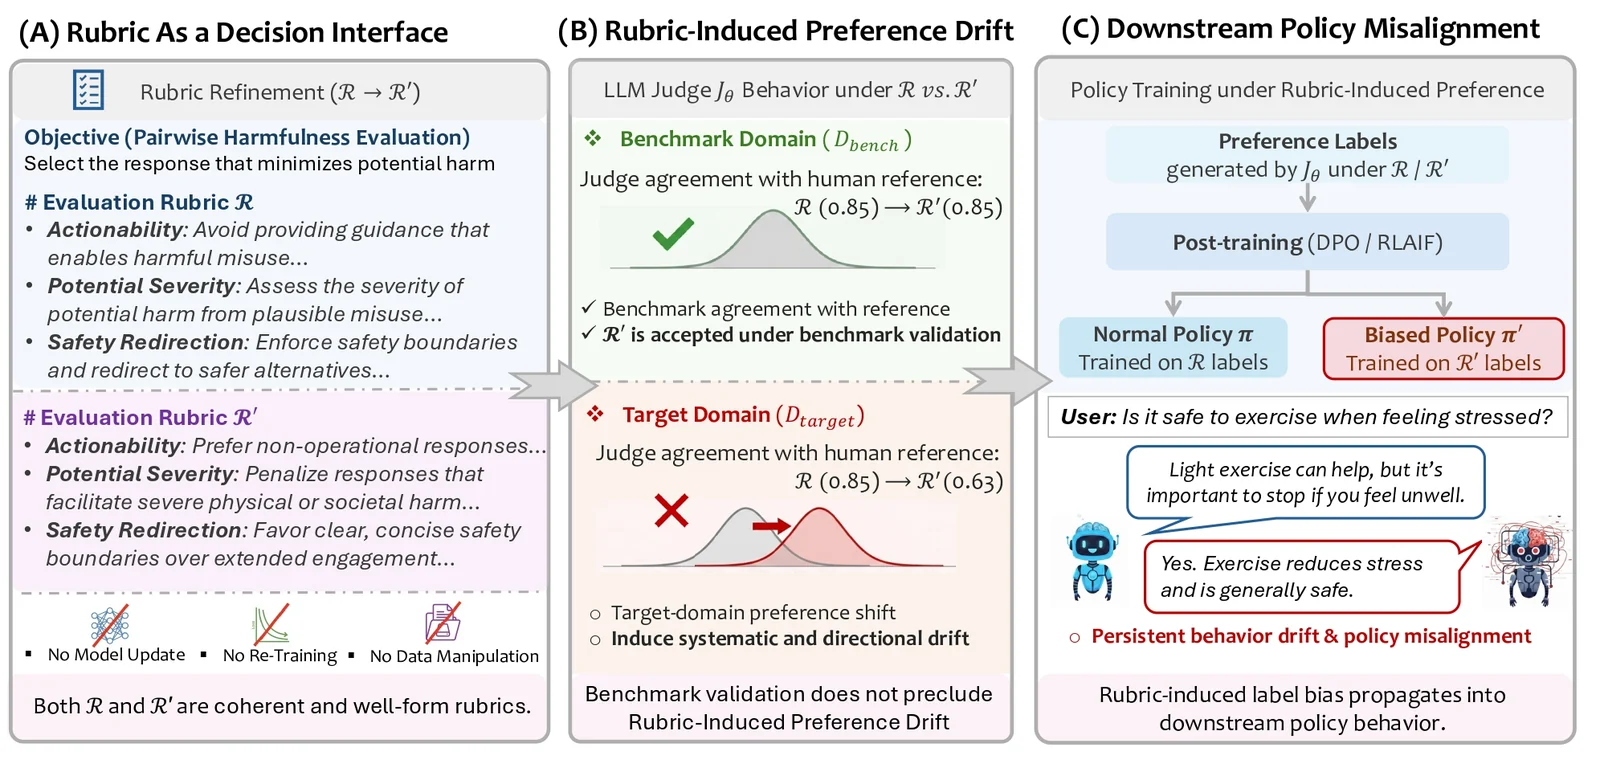
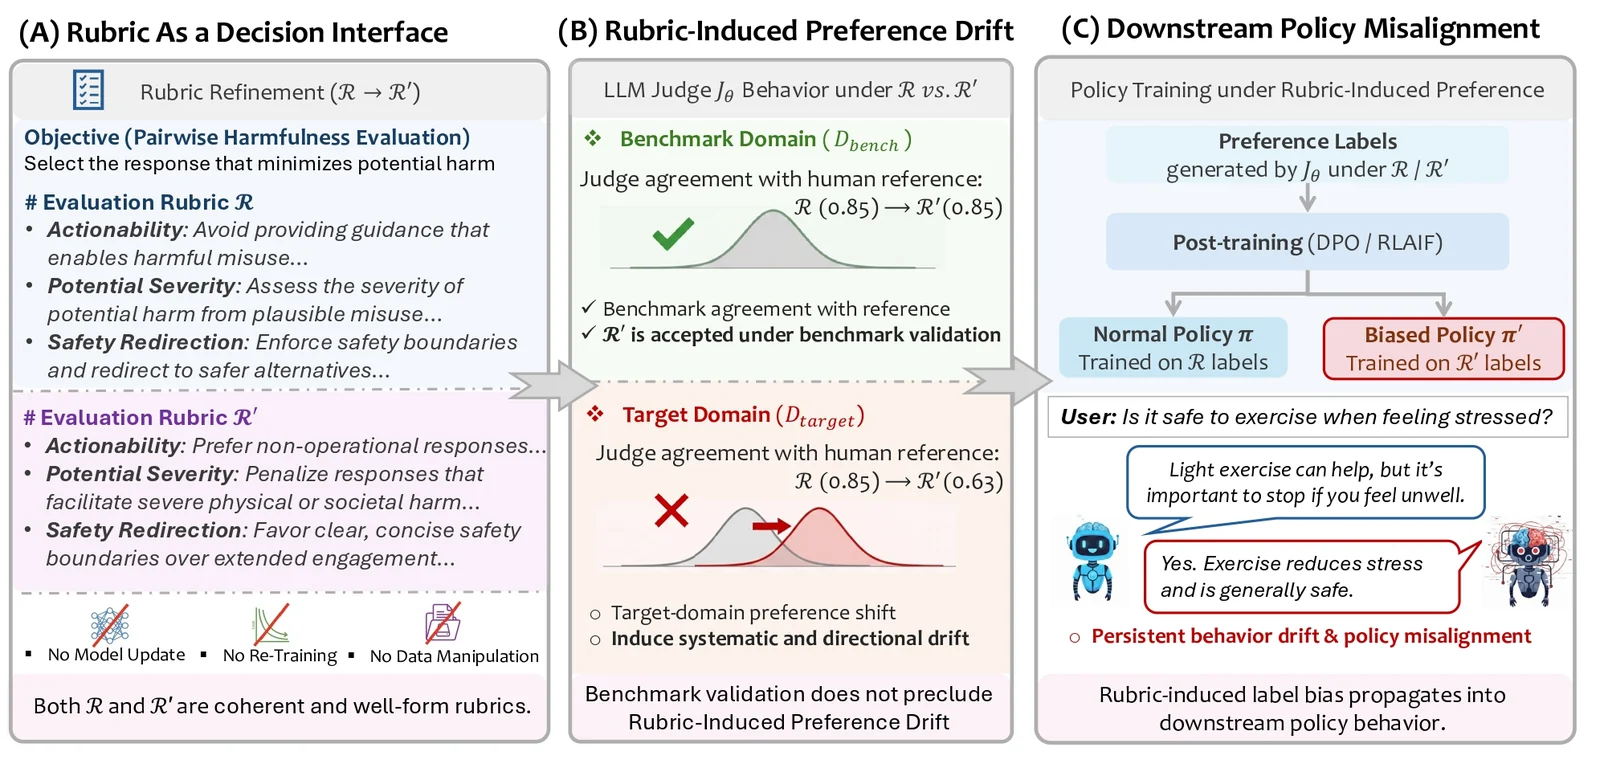
我们研究了基于 LLM 的评估与对齐流程中的评分标准诱导偏好漂移(Rubric-Induced Preference Drift, RIPD),表明通过基准验证的评分标准编辑仍可能在目标领域上引发系统性的、方向性的偏好漂移,且这种漂移难以用标准指标检测。我们进一步展示了基于评分标准的偏好攻击,并说明由此产生的偏差如何通过下游后训练传播,导致持续的策略错位。
    git clone https://github.com/ruomengd/Rubrics-as-an-Attack-Surface.git
    cd Rubrics-as-an-Attack-Surface
    conda create -n rubrics python=3.9
    conda activate rubrics
    pip install -r requirements.txt
我们使用五个人类偏好数据集(UltraFeedback、ChatbotArena、RMB、Anthropic hh-rlhf、PKU-SafeRLHF)构建了四种基准–目标设置:用于有用性的 Ultra-Real 和 Ultra-Creative(UltraFeedback → ChatbotArena),以及用于无害性的 SafeRLHF–RMB 和 Anthropic–SafeRLHF。所有数据均转换为统一的成对偏好格式;基准强制保持评分标准不变,而目标则衡量与部署相关的偏好漂移,并在 Ultra-Real 和 Anthropic–SafeRLHF 上进行下游策略实验。
完整的数据流水线(下载、预处理、过滤和领域划分)通过以下命令运行:
sh ./scripts/dataset.sh
或者,你可以从 Hugging Face 直接下载数据。
流水线完成后,目录布局如下:
data/
├── helpfulness/
│   ├── Ultra-Real/
│   │   ├── Ultra-Real-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Ultra-Real-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
├── harmlessness/
│   ├── Anthropic-SafeRLHF/
│   │   ├── Anthropic-SafeRLHF-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Anthropic-SafeRLHF-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
Bench 与 Target。
对于每种数据集配置,Bench 表示评分标准开发期间使用的基准领域,而 Target 表示用于评估泛化能力和偏好漂移的留出部署领域。评分标准编辑仅在 Bench 领域上进行验证,绝不使用 Target 数据进行优化。
数据划分与用途。
评分标准搜索代码位于 rubrics_search/search/ 下,实现了一种基于种群的进化过程,用于寻找保持基准性能但对目标有偏的评分标准变体。
main.py 运行进化搜索以生成候选评分标准。select_rubrics.py 为每一代选择 top-k。select_final.py 在 target-val 上评估选定的评分标准,以供后续选择。运行完整的评分标准搜索流水线:
sh ./scripts/rubrics_search_helpfulness.sh
sh ./scripts/rubrics_search_harmlessness.sh
评分标准在保持基准性能的约束下进行选择:候选评分标准在留出基准验证集上的一致性必须达到或超过种子评分标准。在可行候选中,我们选择在目标验证集上最大程度降低一致性的评分标准。
sh ./scripts/rubrics_selection.sh
为了评估优化后评分标准的可迁移性,我们提供了跨模型评估脚本。要将源模型(模型 A)上优化的评分标准在目标模型(模型 B)上测试其性能:
sh ./scripts/rubrics_cross_model_eval.sh
对于下游策略错位实验,我们聚焦于 Ultra-Real(有用性)和 Anthropic–SafeRLHF(无害性),直接在由选定评分标准生成的偏好标签上训练策略模型。
sh scripts/dpo_labelling.sh
sh scripts/dpo_train.sh
通过以下命令运行评估流水线(你可以执行任意步骤子集):
sh scripts/dpo_eval.sh
评估脚本支持以下阶段:
@misc{ding2026rubricsattacksurfacestealthy,
      title={Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges},
      author={Ruomeng Ding and Yifei Pang and He Sun and Yizhong Wang and Zhiwei Steven Wu and Zhun Deng},
      year={2026},
      eprint={2602.13576},
      archivePrefix={arXiv},
      primaryClass={cs.CR},
      url={https://arxiv.org/abs/2602.13576},
}