J A W
网站 | 文档 | 设置 | 爬虫 | 快速开始 Docker(示例)


一个基于 esprima 解析器和 EsTree SpiderMonkey Spec 的 JavaScript 属性图开源原型实现。JAW 可用于分析 Web 应用程序的客户端和基于 JavaScript 的程序。
本项目采用 GNU AFFERO GENERAL PUBLIC LICENSE V3.0 许可。更多信息请参见此处。
JAW 有一个 Github Pages 网站,网址为 https://soheilkhodayari.github.io/JAW/。
发布说明:
JAW-V2 分支。JAW-V1 分支。JAW 的架构如下图所示。
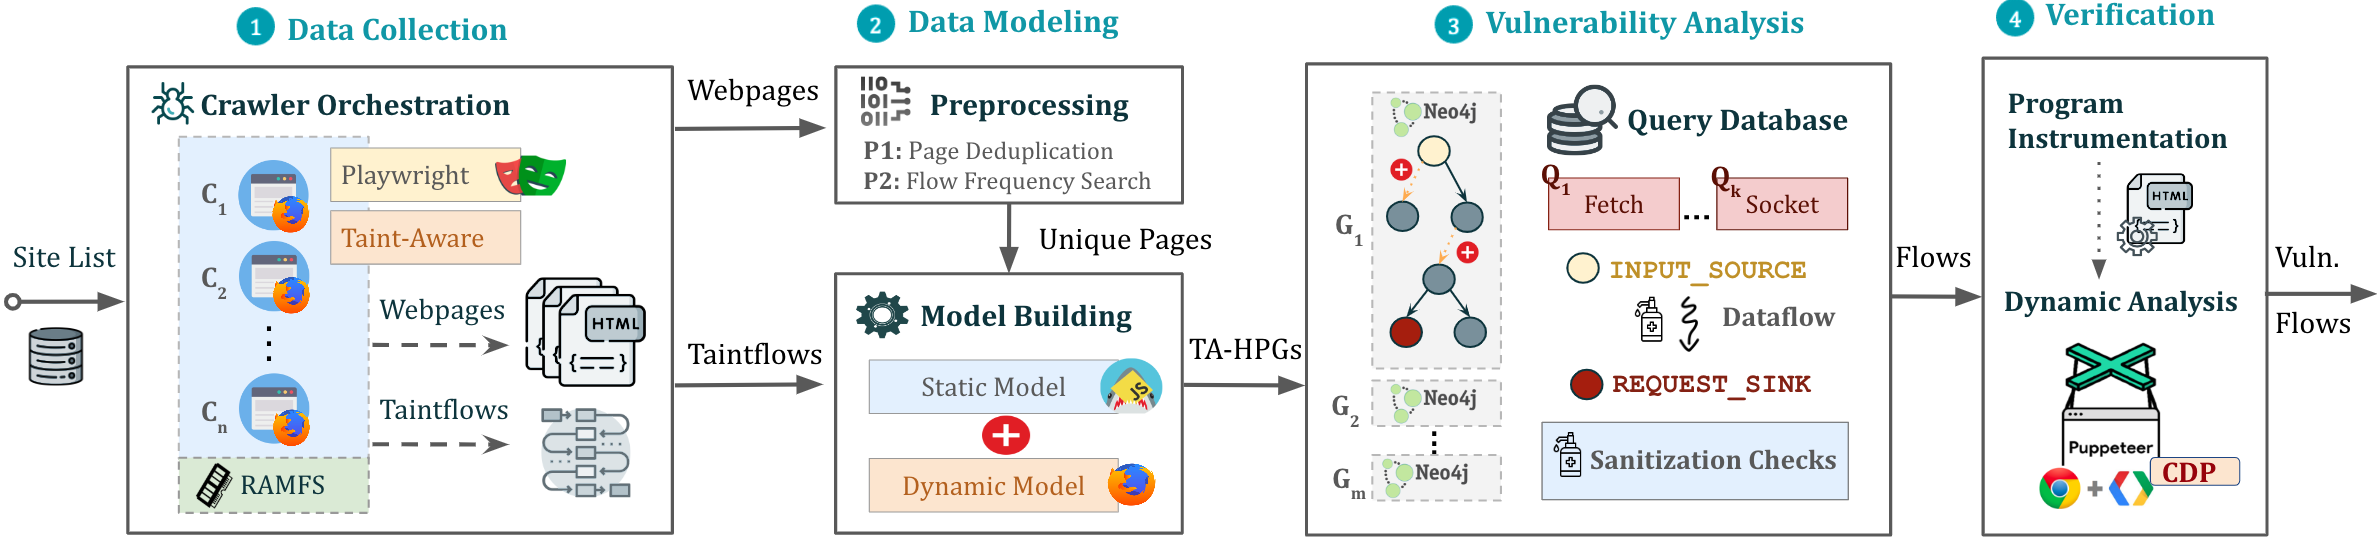
JAW 可通过两种不同的方式使用:
任意 JavaScript 分析: 通过指定程序的文件系统 路径,利用 JAW 对任何 JavaScript 程序进行建模和分析。
Web 应用分析: 通过提供一个种子 URL 来分析 Web 应用程序。
使用收集到的 Web 资源创建一个混合属性图(HPG),并将其导入 Neo4j 数据库。
可选:为 HPG 构建模块提供语义类型到自定义 JavaScript 语言标记的映射,以便根据函数用途(例如 HTTP 请求函数)对 JavaScript 函数进行分类。
查询构建好的 Neo4j 图数据库以进行各种分析。JAW 提供了用于数据流分析、控制流分析、可达性分析和模式匹配的实用遍历。这些遍历可用于开发自定义安全分析。
JAW 还包含用于检测客户端 CSRF、DOM Clobbering 和请求劫持漏洞的内置遍历。
输出将存储在与输入相同的文件夹中。
安装脚本依赖以下先决条件:
npm 包管理器(Node.js)Python 3.xpip 包管理器然后,通过以下命令安装必要的依赖项:
$ ./install.sh
有关 详细 安装说明,请参见此处。
您可以通过以下命令在后台屏幕中运行管道的实例:
$ python3 -m run_pipeline --conf=config.yaml
CLI 提供以下选项:
$ python3 -m run_pipeline -h

usage: run_pipeline.py [-h] [--conf FILE] [--site SITE] [--list LIST] [--from FROM] [--to TO]

此脚本运行工具管道。

optional arguments:
  -h, --help            显示此帮助信息并退出
  --conf FILE, -C FILE  管道配置文件。(默认值:config.yaml)
  --site SITE, -S SITE  要测试的网站;覆盖配置文件(默认值:None)
  --list LIST, -L LIST  要测试的网站列表;覆盖配置文件(默认值:None)
  --from FROM, -F FROM  当提供网站列表时,要考虑的第一个条目;覆盖配置文件(默认值:-1)
  --to TO, -T TO        当提供网站列表时,要考虑的最后一个条目;覆盖配置文件(默认值:-1)
输入配置: JAW 需要一个 .yaml 配置文件作为输入。参见 config.yaml 示例。
提示: 配置文件指定了不同的步骤(例如,爬取、静态分析等),可以为每个漏洞类别启用或禁用这些步骤。这允许单独或以不同的顺序运行工具的构建块(例如,先爬取所有 Web 应用,然后进行安全分析)。
要运行一个快速示例,演示如何构建属性图并对其运行 Cypher 查询,请执行以下操作:
$ python3 -m analyses.example.example_analysis --input=$(pwd)/data/test_program/test.js
此模块收集测试所需的数据(即 JavaScript 代码和网页状态值)。如果您要测试文件系统上已有的特定 JavaScript 文件,可以 跳过 此步骤。
JAW 具有基于 Selenium(JAW-v1)、Puppeteer(JAW-v2、v3)和 Playwright(JAW-v3)的爬虫。为了获得最新的功能,建议使用基于 Puppeteer 或 Playwright 的版本。
此 Web 爬虫使用 foxhound(Firefox 的仪表化版本)在浏览网页时执行动态污点跟踪。要启动爬虫,请执行:
$ cd crawler
$ node crawler-taint.js --seedurl=https://google.com --maxurls=100 --headless=true --foxhoundpath=<可选-foxhound-可执行文件路径>
foxhoundpath 默认设置为以下目录:crawler/foxhound/firefox,其中包含一个名为 firefox 的二进制文件。
注意: 您需要构建 foxhound 才能使用此版本。JAW-v3 的发布版中包含一个 Ubuntu 构建。
要启动爬虫,请执行:
$ cd crawler
$ node crawler.js --seedurl=https://google.com --maxurls=100 --browser=chrome --headless=true
更多信息请参见此处。
要启动爬虫,请执行:
$ cd crawler/hpg_crawler
$ vim docker-compose.yaml # 在此处设置要爬取的网站并保存
$ docker-compose build
$ docker-compose up -d
请参考 hpg_crawler 的文档此处以获取更多信息。
要为给定的 JavaScript 文件(集)生成 HPG,请执行:
$ node engine/cli.js  --lang=js --graphid=graph1 --input=/in/file1.js --input=/in/file2.js --output=$(pwd)/data/out/ --mode=csv

optional arguments:
  --lang:     输入程序的语言
  --graphid:  生成的 HPG 的标识符
  --input:    输入程序的路径
  --output:   输出 HPG 的路径,必须是 ...
  --mode:     确定输出格式(csv 或 graphML)
要将 HPG 导入 Neo4j 图数据库(Docker 实例),请执行:
$ python3 -m hpg_neo4j.hpg_import --rpath=<CSV 文件所在文件夹的路径> --id=<xyz> --nodes=<nodes.csv> --edges=<rels.csv>
$ python3 -m hpg_neo4j.hpg_import -h

usage: hpg_import.py [-h] [--rpath P] [--id I] [--nodes N] [--edges E]

此脚本将属性图的 CSV 文件导入 Neo4j Docker 数据库。

optional arguments:
  -h, --help  显示此帮助信息并退出
  --rpath P   相对于 `data` 目录中包含图表 CSV 文件的文件夹的路径
  --id I      图或 Docker 容器的标识符
  --nodes N   节点 CSV 文件的名称(默认值:nodes.csv)
  --edges E   关系 CSV 文件的名称(默认值:rels.csv)
要为 hpg_crawler 的输出创建混合属性图并将其导入本地 Neo4j 实例,您还可以执行:
$ python3 -m engine.api <path> --js=<program.js> --import=<bool> --hybrid=<bool> --reqs=<requests.out> --evts=<events.out> --cookies=<cookies.pkl> --html=<html_snapshot.html>
参数说明:



