Siquan Huang1、Yijiang Li2、Xingfu Yan3,*、Ningzhi Gao1、Leyu Shi1、Ying Gao1,*
1华南理工大学 2加利福尼亚大学圣地亚哥分校 3华南师范大学
*通讯作者


视觉Transformer(ViT)是大多数多模态模型的视觉编码器,而从业者通常会基于可能携带后门的第三方预训练检查点进行构建。DetectViT 是一种面向ViT的测试时后门样本检测器,它读取注意力头,而不是模型的输出或嵌入。
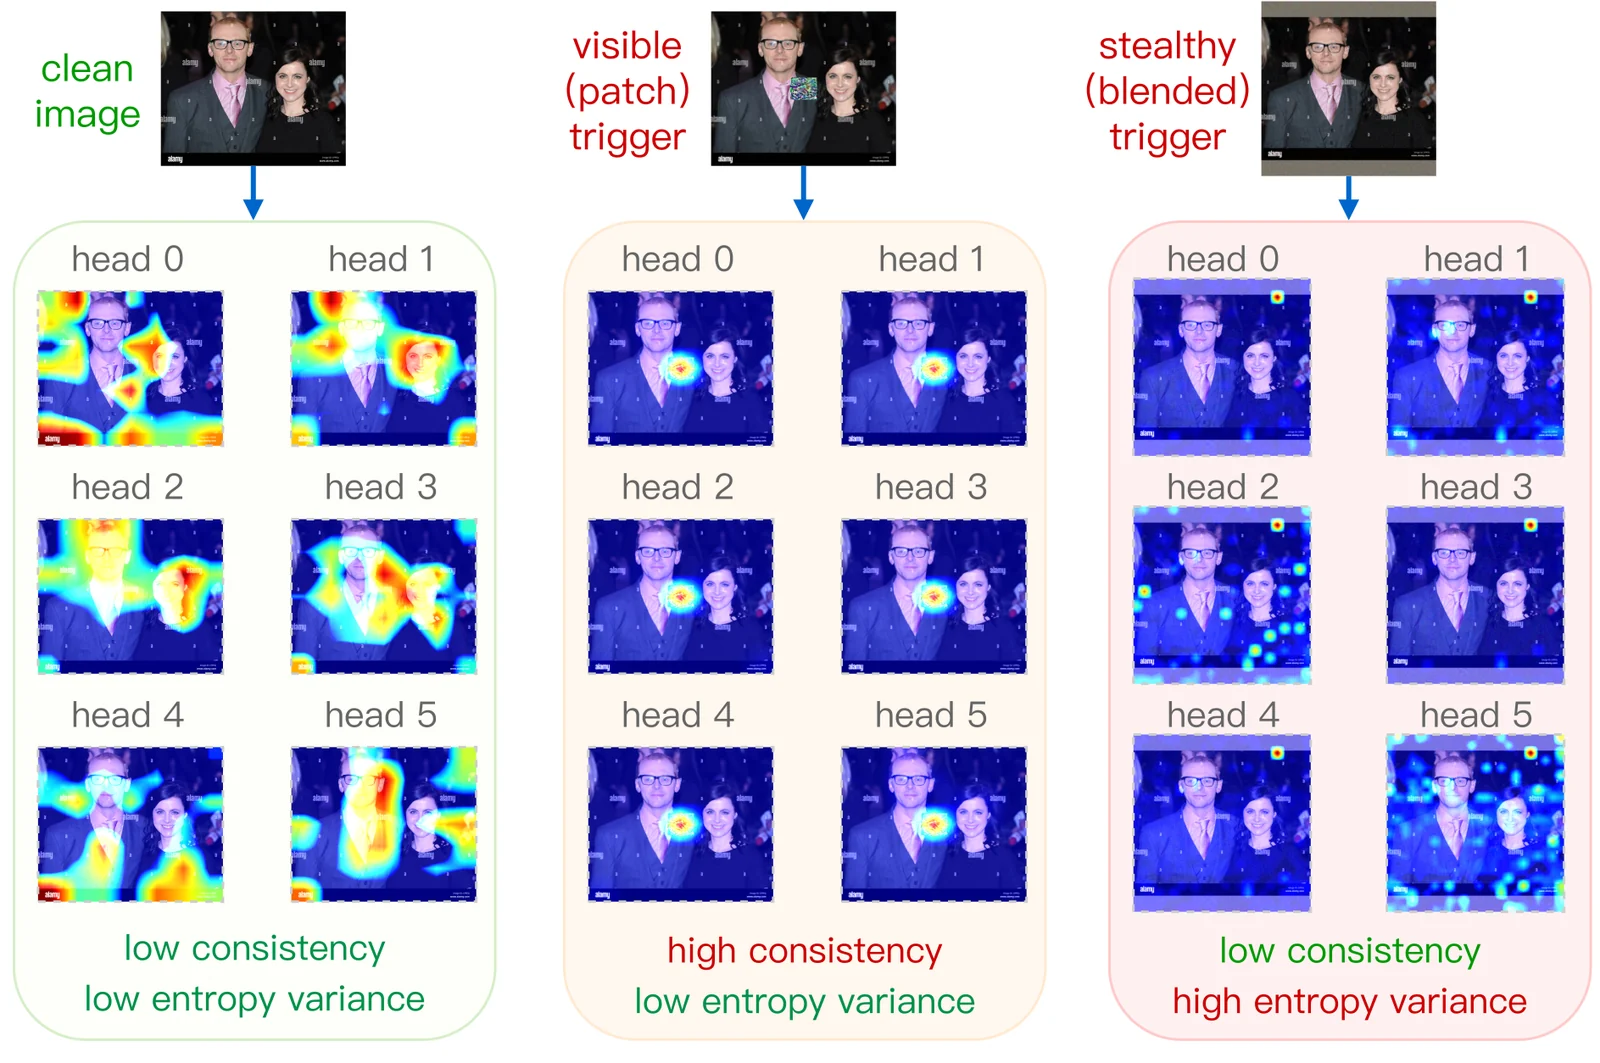
在干净图像上,注意力头关注不同区域,且集中程度相当。后门触发器以两种方式打破这种平衡:
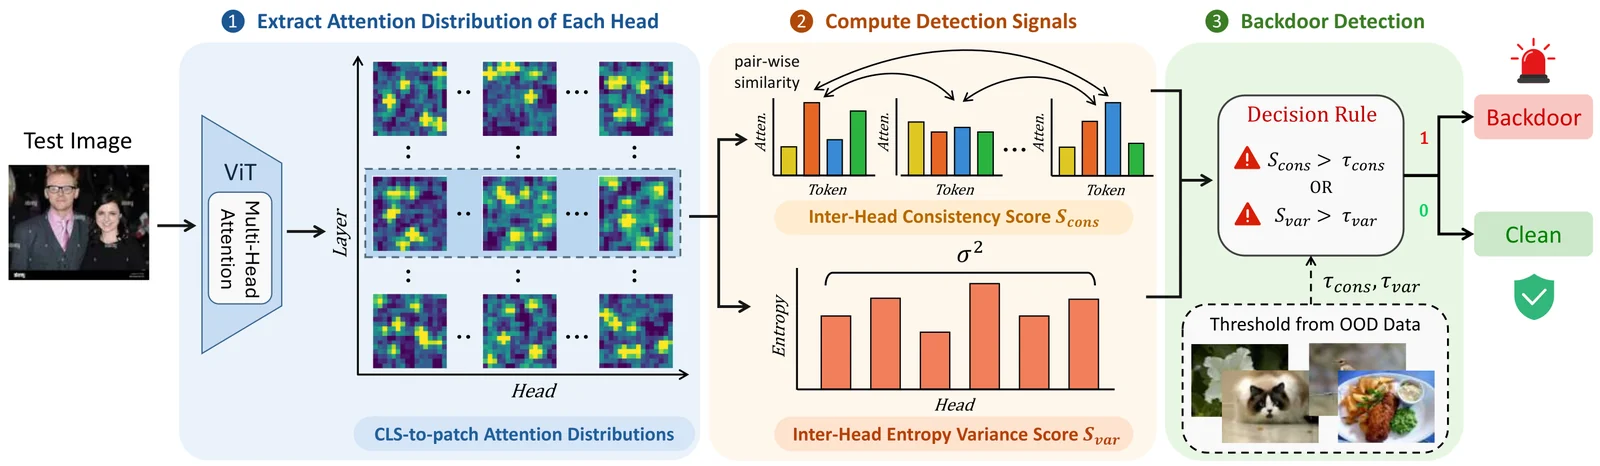
DetectViT提取每个注意力头的CLS到图像块注意力分布,并计算两个互补信号:
阈值通过三西格玛规则 $\tau = \mu + 3\sigma$ 估计,仅需64到128张来自任意来源的干净分布外图像。若 $\mathcal{S}{\text{cons}} > \tau{\text{cons}}$ 或 $\mathcal{S}{\text{var}} > \tau{\text{var}}$,则测试样本被标记为后门样本。
在四种ViT后门攻击上的检测性能。TPR和FPR以%为单位,AUC在[0, 1]范围内。"–"表示该方法不适用(基于标签的方法无法处理自由形式的描述文本)或不产生连续分数。
| 防御方法 | BadViT TPR↑ / FPR↓ / AUC↑ | TrojViT TPR↑ / FPR↓ / AUC↑ | BadCLIP TPR↑ / FPR↓ / AUC↑ | BadVision TPR↑ / FPR↓ / AUC↑ |
|---|---|---|---|---|
| TeCo | 77.95 / 61.86 / 0.63 | 55.00 / 51.76 / 0.51 | 99.20 / 39.52 / 0.89 | – |
| Scale-Up | 88.65 / 30.66 / 0.81 | 85.00 / 41.98 / 0.74 | 91.84 / 65.03 / 0.66 | – |
| PatchProc | 90.61 / 18.42 / 0.89 | 87.60 / 21.44 / 0.85 | 86.97 / 26.78 / 0.82 | – |
| DeDe | 63.97 / 23.29 / 0.78 | 50.20 / 25.80 / 0.72 | 55.12 / 27.97 / 0.69 | 7.00 / 29.68 / 0.50 |
| BackdoorIDS | 80.79 / 9.73 / – | 5.00 / 10.84 / – | 93.24 / 16.88 / – | 96.00 / 15.96 / – |
| DetectViT | 100.00 / 1.58 / 1.00 | 90.80 / 5.94 / 0.95 | 100.00 / 0.17 / 1.00 | 96.00 / 3.00 / 0.99 |
更多攻击。 在另外五种攻击上——涵盖自监督编码器(BadEncoder、DRUPE)、干净标签投毒(Label-Consistent)、频域触发器(Low-Frequency)以及优化的全局触发器(Blended-Optimized)——DetectViT 是唯一在所有攻击上均保持 AUC 至少为 0.97 的方法。完整结果见论文附录。
运行时间。 平均每样本检测时间(秒):
| 防御方法 | BadViT | TrojViT | BadCLIP | BadVision |
|---|---|---|---|---|
| TeCo | 2.5094 | 4.2920 | 1.8448 | – |
| Scale-Up | 0.0246 | 0.0261 | 0.0696 | – |
| PatchProc | 0.6686 | 0.6926 | 0.8257 | – |
| DeDe | 0.0206 | 0.0279 | 0.1034 | 0.6060 |
| BackdoorIDS | 0.1734 | 0.1982 | 0.2560 | 3.3458 |
| DetectViT | 0.0124 | 0.0134 | 0.0163 | 0.0226 |
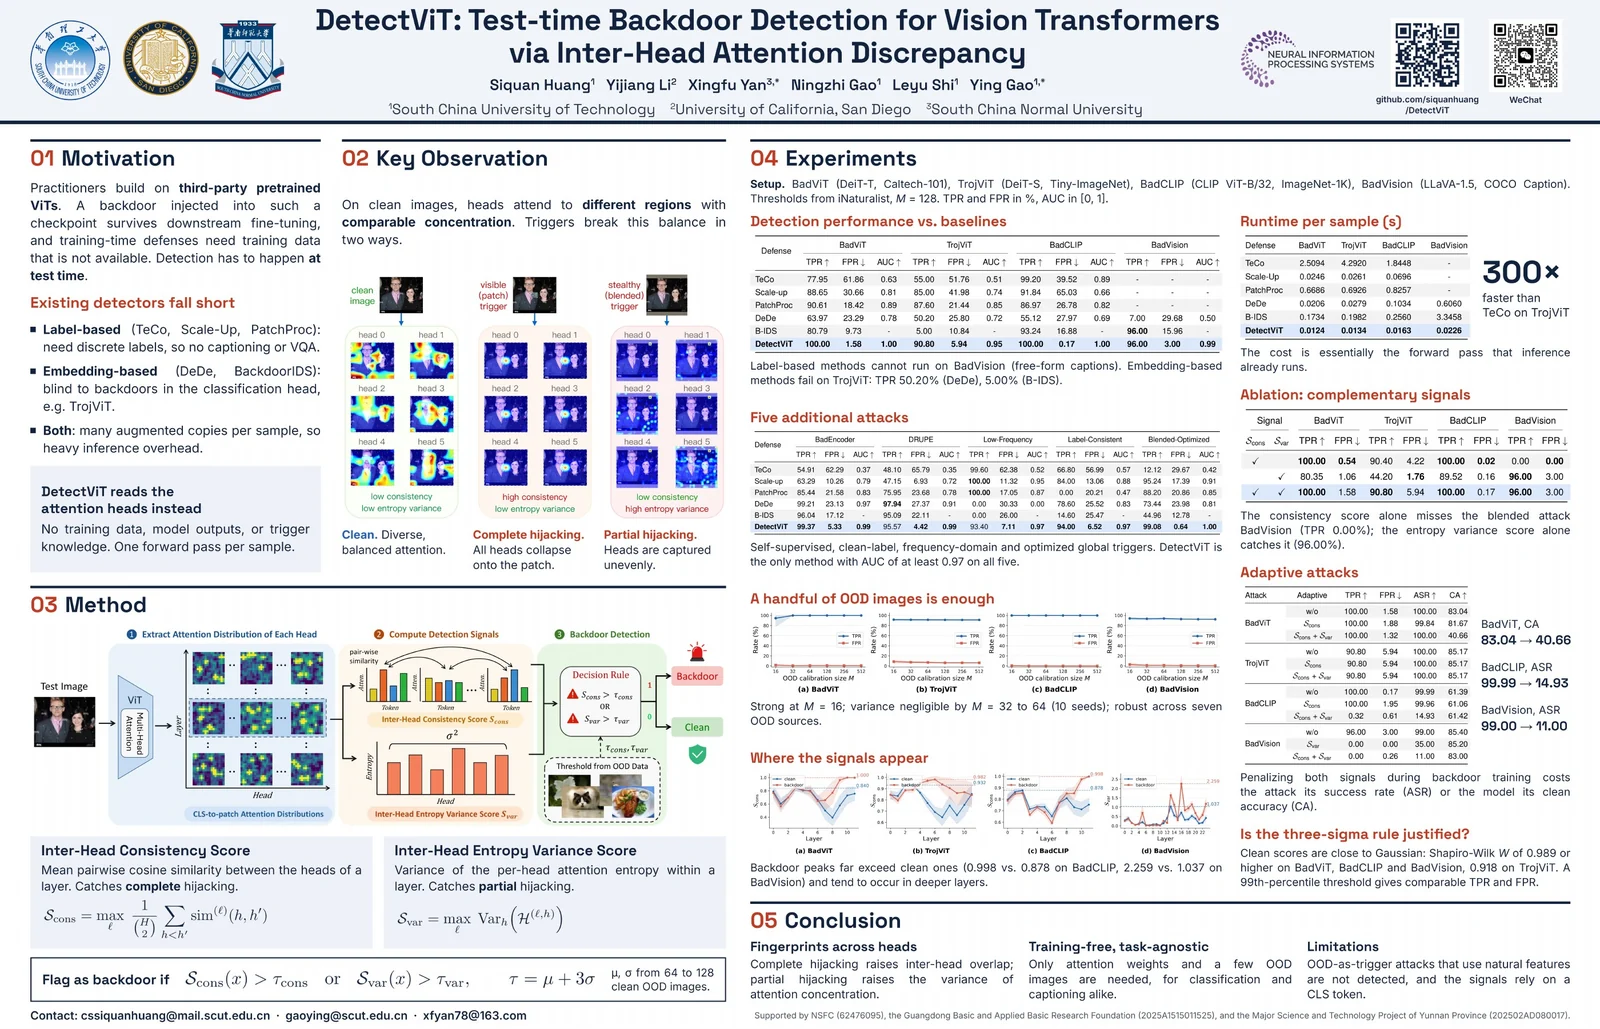
点击图片打开全分辨率 PDF。
git clone https://github.com/siquanhuang/DetectViT.git
cd DetectViT
从 Google Drive 下载预训练的后门模型检查点和优化后的触发器:
检测方法实现在 detectvit.py 中。运行 main.py 以针对每种攻击评估 DetectViT。
python3 main.py \
  --defense DetectViT \
  --attack_type badvit \
  --trojvit_attack_dir TrojViT/logs/Caltech101_DeiT-T_target0_BadViT \
  --trojvit_network DeiT-T \
  --trojvit_num_classes 102 \
  --trojvit_data_dir ./data
python3 main.py \
  --defense DetectViT \
  --attack_type trojvit \
  --trojvit_attack_dir TrojViT/logs/Tiny-ImageNet_DeiT-S_target2_TrojViT \
  --trojvit_data_dir ./data/tiny-imagenet-200 \
  --trojvit_network DeiT-S \
  --gpu 0
python3 -u main.py \
  --defense DetectViT \
  --attack_type badclip \
  --gpu 0 \
  --eval_data_type ImageNet1K \
  --eval_test_data_dir BadCLIP/data/ImageNet1K/validation/ \
  --add_backdoor \
  --asr \
  --label banana \
  --patch_type ours_tnature \
  --patch_location middle \
  --patch_name BadCLIP/opti_patches/tnature_eda_bs64_ep50_32_middle_01_05_pos_neg.jpg \
  --patch_size 32
python3 -u main.py \
  --defense DetectViT \
  --attack_type badvision \
  --gpu 0
| 参数 | 描述 | 默认值 |
|---|---|---|
--defense | 检测方法(DetectViT、DeDe、BackdoorIDS、...) | DetectViT |
--attack_type | 待评估的攻击(badvit、trojvit、badclip、badvision) | — |
--gpu | GPU 设备 ID | 0 |
如果您认为本工作对您有所帮助,请考虑引用我们的论文。
@misc{huang2026detectvittesttimebackdoordetection,
      title={DetectViT: Test-time Backdoor Detection for Vision Transformers via Inter-Head Attention Discrepancy},
      author={Siquan Huang and Yijiang Li and Xingfu Yan and Ningzhi Gao and Leyu Shi and Ying Gao},
      year={2026},
      eprint={2611.23770},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2611.23770},
}
本项目基于以下开源工作构建。我们衷心感谢作者发布其代码:









