Skip to content
KitploitKITPLOIT
工具漏洞利用博客
Log in
提交
工具漏洞利用博客
提交

黑客、渗透测试和网络安全工具,武装您的安全武器库!

Kitploit 是一个黑客、网络安全和渗透测试工具的目录。发现最新的项目更新,查找漏洞、分析系统、自动化测试并加强你的安全。

订阅源联系隐私© 2026 Kitploit

工具目录

分类

查看所有分类
Loading categories
工具/GitHubGitHub/mrwadams/stride-gpt
渗透测试框架漏洞分析威胁情报学习与教育AI 安全
GitHubmrwadams/stride-gpt

stride-gpt

一款基于AI的威胁建模工具,利用OpenAI的GPT模型,根据STRIDE方法论为给定应用程序生成威胁模型。

查看仓库
1.1k319815天前Kitploit 审核通过
网站
分享

STRIDE GPT Logo

STRIDE GPT 是一款由 AI 驱动的威胁建模工具,它利用大型语言模型(LLM),基于 STRIDE 方法论为给定应用程序生成威胁模型和攻击树。用户提供应用程序详细信息,例如应用程序类型、身份验证方法,以及该应用程序是否面向互联网或处理敏感数据。随后,模型根据所提供的信息生成输出。

目录

  • 支持本项目
  • 功能特性
  • 企业部署
  • 在 Open Security Summit 上的演讲
  • 更新日志
  • 安装
  • 仓库结构
  • 使用方法
    • 交互式 REPL 速查表
  • 示例输出
  • 安全最佳实践
  • 贡献
  • 许可证

支持本项目

如果您觉得 STRIDE GPT 有用,请考虑支持本项目:

  • ⭐ 在 GitHub 上为本仓库加星,帮助更多人发现该工具
  • ☕ 请我喝杯咖啡,以支持持续的开发与维护
Buy Me A Coffee

功能特性

  • 智能体式代码库分析:将 CLI 指向代码库,即可获得自主、深入的 STRIDE 威胁模型——智能体会规划、探索并综合各子系统的发现
  • CLI 与交互式 REPL:功能完备的终端体验,支持 Tab 补全、历史记录和实时进度——无需浏览器
  • 简单易用的 Streamlit Web 界面
  • 基于 STRIDE 方法论生成威胁模型
  • 智能体式 AI 支持:针对智能体式 AI 系统的专用威胁建模,集成 OWASP Top 10 for Agentic Applications (ASI)
  • 生成式 AI 支持:针对 GenAI 应用的威胁建模,集成 OWASP LLM Top 10
  • MITRE ATT&CK 与 ATLAS 映射:威胁会标注标准化的对手技术 ID(传统基础设施攻击使用 MITRE ATT&CK Enterprise,ML/LLM 特定攻击使用 ATLAS)——在 markdown 中呈现为列,在 HTML 中呈现为链接标签,在 SARIF 中呈现为 mitre_attack 属性
  • 架构模式检测:从应用描述中自动检测 RAG 流水线、多智能体系统、代码执行环境、工具生态等(灵感来自 CSA MAESTRO)
  • 内嵌 draw.io 图表编辑器:使用集成的 diagrams.net 编辑器直接在 STRIDE-GPT 中创建和编辑架构图——无需外部工具。图表以 XML 解析,以提取组件、连接和信任边界,相比仅靠图像分析,可为威胁模型生成提供显著更丰富的上下文。现有的图像上传工作流保持不变。默认情况下,编辑器从托管的 embed.diagrams.net 加载;对于自托管或气隙部署,可通过 STRIDE_GPT_DRAWIO_URL 环境变量将其指向你自己的 draw.io
  • 多模态:在所有支持视觉能力的模型上,使用架构图、流程图等作为威胁建模的输入
  • 数据流图:从应用描述生成 DFD(或解析上传的 DFD 图像),实时编辑 Mermaid 源码,并将确认后的图表作为权威系统模型反馈到威胁模型和攻击树提示中。CLI 的 /analyze 还会在输出发现的同时生成系统级 DFD
  • 生成攻击树以枚举可能的攻击路径
  • 为已识别的威胁建议可能的缓解措施
  • 支持对已识别威胁进行 DREAD 风险评分
  • 基于已识别的威胁生成 Gherkin 测试用例
  • GitHub 仓库分析,用于全面的威胁建模(包括 GitHub Enterprise 支持)
  • 多种输出格式:Markdown、JSON、SARIF(可导入 GitHub、GitLab、Azure DevOps、IDE)以及用于与利益相关者分享的自包含 HTML 视图
  • 当前模型支持(OpenAI GPT-6 系列、Anthropic Claude Opus 5.5 和 4.8、Google Gemini 3.x,默认开启思考功能)
  • 通过 LiteLLM 提供全面的 LLM 提供商支持:OpenAI、Anthropic、Google AI、Mistral、Groq、DeepSeek,以及通过 LM Studio Server 进行本地托管
  • 不存储数据;应用详情不会被保存
  • 提供 Docker 容器镜像,便于部署
  • 支持环境变量以实现安全配置

企业部署

想要为你的组织定制 STRIDE-GPT?请查看我们全面的运维指南,了解如何:

  • 🎯 注入组织安全控制与标准
  • 📋 根据你的合规要求定制威胁模型
  • 🔧 在内部 Fork 并部署 STRIDE-GPT
  • 📊 获取针对你环境的上下文感知、可操作的威胁模型

该指南包含分步说明、代码示例和部署模式,适合希望在团队中规模化推广 AI 驱动威胁建模的组织。

Open Security Summit 演讲

2024 年 1 月,我在 Open Security Summit 上做了一场关于 STRIDE GPT 的演讲。在演讲中,我讨论了该项目的起源、核心功能、近期更新以及一些未来计划。你可以在下方观看完整演讲:
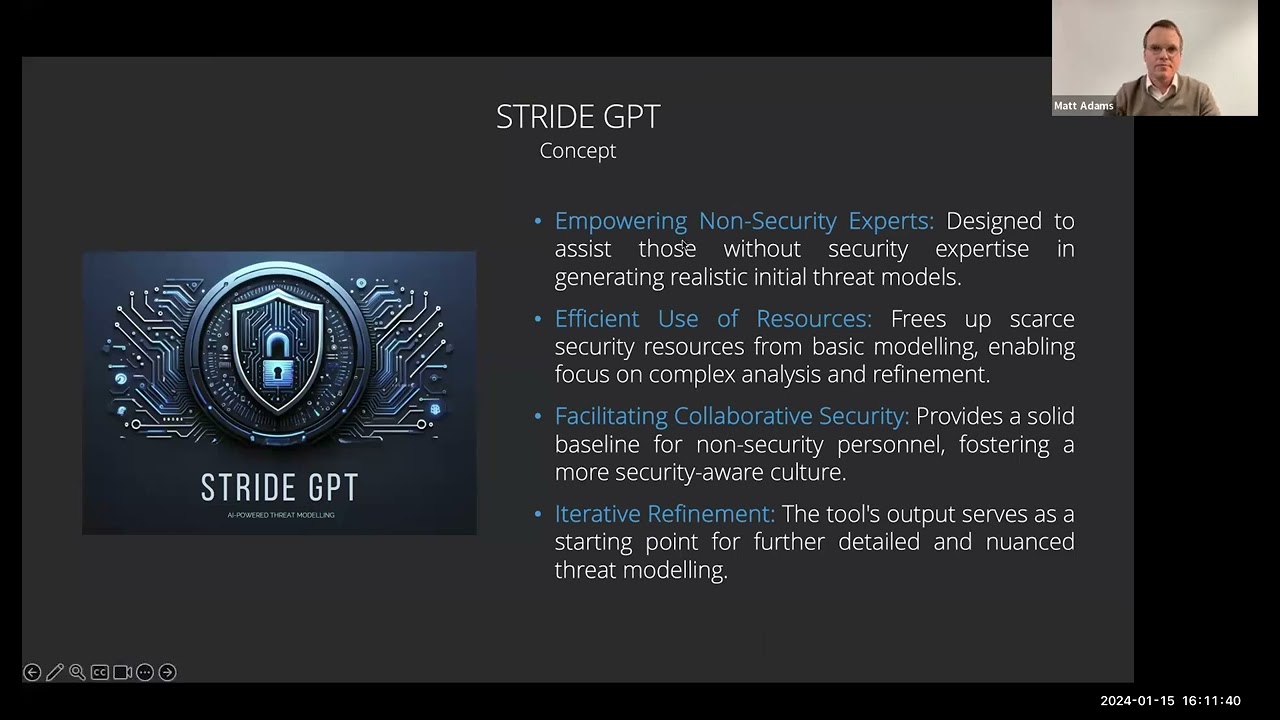
Open Security Summit Talk

对于任何有兴趣了解 STRIDE GPT 如何工作以及如何用它来改进威胁建模的人来说,这个视频都是极好的资源。

更新日志

版本 0.21(最新)

  • 全新安装恢复正常(#330、#283、#334):从 litellm 1.106.0 起,每个工具调用请求都会导入 mcp,因此干净的 pip install stride-gpt 会在其第一个子系统上失败。STRIDE-GPT 现在依赖 litellm[mcp]。CI 和发布工作流会将构建好的 wheel 安装到空环境中并进行冒烟测试,之后才会发布到 PyPI。
  • 规划与预算(#226、#306、#264、#271、#175、#300):规划器会找出所有关键文件,并将代码库拆分为可部署的服务。每个服务仅由拥有其代码的 worker 进行分析,因此同一份代码不再从多个子系统重复报告。--max-llm-calls 和 --max-tool-calls 现在会限制每个子系统,而此前它们限制的是整个运行,导致后续子系统可能被丢弃。中途停止的子系统会被记录为 unfinished,并将该次运行标记为 partial;此前它会被记录为 completed。
  • 威胁 ID 与综合(#209、#212、#251、#252、#265、#225):每个威胁都有稳定的 ID。综合阶段要么将系统性观察关联到它所概括的子系统威胁,要么报告一个涌现威胁(例如跨子系统的链条),其证据必须经过验证。综合失败时会保留子系统发现。Token 用量会单独统计缓存命中。
  • 错误与恢复(#258、#262、#297、#303、#305):速率限制和服务器错误会被重试。仍然失败的运行会以一行引用提供商消息的内容和非零退出码结束,未分析任何内容的运行也是如此。恢复功能会拒绝同一仓库中来自其他目录的检查点,按 Ctrl-C 会打印恢复该次运行的命令。较小的修复涵盖 -o 目录、REPL 标志、/quick 参考卡片、快速报告名称以及模型输出中的标记。
  • 模型、提示词与 Web UI(#245、#324、#328、#276、#294、#326):Claude Sonnet 5.5 和 Haiku 5.5 取代 Sonnet 5 和 Haiku 4.5,Anthropic 预算思考被移除,DeepSeek 规划恢复正常。提示词将每个外部服务视为系统信任边界之外。每个 Web UI 标签页现在都发起一次与提供商无关的调用,生成的 DFD 会出现在编辑器中。
  • 供应链:九个依赖项提高了安全下限。锁文件解析会跳过发布不足 5 天的版本,未使用的 anthropic 和 groq SDK 已从 Web 附加组件中移除。

升级: 由 0.20 写入的检查点无法恢复,因为移除预算思考后配置哈希发生了变化。请重新开始这些运行。发现文件不再使用 skipped 结果。

版本 0.20

  • 恢复被中断的分析(关闭 #197):analyze 现在会在已批准的计划和每个子系统发现完成时将其检查点保存到 -o 报告旁边。--resume <checkpoint> 会复用已完成的子系统并重新运行其余部分,然后照常运行综合和数据流图。当目标的 git SHA 或配置哈希不再匹配时,恢复会拒绝执行,并指出是哪一项发生了变化,因此过期的发现无法被拼接进针对不同代码的运行中。工作树有未提交更改或缺少 git SHA 时会拒绝,除非使用 --force;SHA 发生变化时即使使用 --force 也会拒绝。运行清单会记录哪些子系统被复用、哪些被重新运行。
  • 威胁引用经过验证的证据(关闭 #195):现在每个威胁都通过一个携带其来源代码的工具调用来报告,并且每个引用的代码片段都会在记录威胁之前与磁盘上的文件进行核对。SARIF 位置指向发现证据所在的文件和行范围,而不是给某个子系统中的每个威胁都赋予相同的三个文件,并且 files_analyzed 反映的是 agent 实际读取的内容,而不是它声称读取的内容。
  • 每个子系统都会记录其停止原因(关闭 #196):SubsystemFinding 现在携带一个 outcome——completed、budget_exhausted、parse_failed、error 或 skipped——因此崩溃的子系统不再与已分析但未发现任何问题的子系统无法区分。发现始终与计划匹配:运行预算从未触及的子系统会被记录为 skipped 而不是被丢弃。run_summary.status 由这些结果推导而来,因此子系统崩溃的运行会被报告为 partial 而不是 completed,并且一个零威胁的干净子系统不再让控制台打印 "Analysis partially complete"。失败根据异常类型(context_overflow、rate_limited、auth、provider_error)进行分类,而不是通过搜索错误文本来判断,并且 markdown 和 HTML 报告会明确显示失败和跳过的子系统。在此更改之前写入的发现文件仍然可以加载,并被视为 completed。
  • 按阶段和按子系统记录 token 使用量(#198):提示和补全 token 从每个提供方响应中读取,并按阶段(规划、探索、压缩、综合、DFD)、按子系统以及按运行总计进行汇总。控制台摘要新增一行 token 信息,<stem>.run.json 新增 token_usage_total、token_usage_by_phase 和 token_usage_by_subsystem。"Unknown" 与零保持区分:某些提供方从不报告使用量,因此全零读数会被记录为不可用,而不是免费。这些是 token 计数,不是成本:缓存命中和未命中 token 尚未拆分(#225),因此如果某个提供方的大部分对话都由其前缀缓存提供,其计费会远低于总计所暗示的金额。
  • 规划器会代表它发现的每个目录(#175,关闭 #180):发送给规划器的关键文件样本是一个扁平的字母顺序切片,因此一个排序靠前的目录可能消耗整个预算,而一个排序靠后的服务到达规划器时完全没有文件级信号。在 OWASP crAPI 上,这导致六个服务中有两个完全从计划中消失,而运行仍报告为完成。现在样本会在整个目录树中轮询,无论深度如何,并且其头部说明这是一个样本,而不是在静默截断的列表上报告总数。search_files 的截断标记不再像文件一样混入该列表。
  • read_file 按行范围分页(关闭 #194):read_file 接受可选的从 1 开始的 start_line 和 end_line 参数,并在一个头部下返回带编号的行,该头部给出总行数、显示的确切范围以及字节上限是否将其截断。以前它返回前 50 KB 且仅此而已,因此 agent 无法读取超过该点的内容,也没有可引用的行号。当输出被截断时,会给出一个提示,指明接下来应请求的行。
  • 将 OpenRouter 作为模型提供方(#221):通过 LiteLLM 的 openrouter/ 前缀进行路由,使用 OPENROUTER_API_KEY 进行身份验证,提供六个支持工具的模型作为候选清单,并可通过向导的 Custom 选项使用任何其他 slug。目前仅支持 CLI。同时修复:当 --worker-model 指定的提供方不在已保存配置中时,模型会从该标志解析,但 API 密钥却从配置文件读取,导致请求可能携带错误提供方的密钥(#222)。
  • 模型注册表已刷新(#223):更新了 OpenAI、Anthropic、DeepSeek、Mistral、Groq、Google 和 OpenRouter 的当前模型阵容,并移除了已停用的模型。supports_thinking 现在会跟踪哪些模型实际接受旧版扩展思考参数,因为 Claude 4.7 及更高版本会拒绝该参数,而 Streamlit 的思考复选框现在依据该标志而非提供方。
  • 安全:智能体的文件工具不再能访问版本控制元数据(#191、#190):read_file、grep_content 和 list_directory 会拒绝任何解析到 .git、.hg 或 .svn 内部的路径,无论是直接访问还是通过已提交的符号链接。actions/checkout 会将作业令牌写入 .git/config,而某些克隆会将令牌嵌入远程 URL,因此分析 CI 检出会使凭据处于模型驱动读取的可及范围内。grep_content 之前只检查起始路径,然后读取 os.walk 返回的所有内容;现在它对每个文件应用相同的解析路径检查,与 read_file 保持一致。list_directory 在报告类型和大小不再跟随符号链接逃出沙箱。
  • 格式错误的模型输出不再能破坏运行的中间文件(关闭 #208):规划器提供的文件路径中的空字节会导致路径脱敏崩溃,而该脱敏在持久化 plan.json、findings.json 和 run.json 时运行——此时每次 LLM 调用都已付费。脱敏现在已全面覆盖,无法解析的路径仍会被脱敏而非原样写出,因此主目录不会泄漏到提交至 git 或工单的清单中。真正的磁盘和序列化故障仍会使运行大声失败。


  • 供应链与扫描卫生(#176、#177):通过锁文件更新 gitpython、aiohttp 和 cryptography,清除了 22 个 Dependabot 警报;减少了 Trivy 基础镜像噪音,该噪音曾掩盖可操作的发现;并清除了剩余的 18 个 CodeQL 代码质量发现。定时密钥扫描不再因模型标识符而失败,CI 安全摘要报告的图标会跟随作业结果。

版本 0.19

下载工具

最受欢迎

查看全部 →

发现我们社区最常用的工具。

暂无热门数据。

探索所有工具

浏览我们的工具集合

查看所有工具 →