
一次请求即可完成入侵检测。向 TypeSafe 的 Jev 展示一条网络流和五个带标签的示例。它会在半秒内回答该流是否为攻击以及属于哪种类型,无需解析任何文本。
Jev IDS 在网络安全社区的参考基准 NSL-KDD 上进行了测试,并与最先进的 LLM(Vertex AI 上的 Gemini 3.6 Flash)、经典机器学习模型(随机森林)和无监督模型(孤立森林)进行了对比:2,000 条流、三个随机种子、每个类别 k 从 0 到 8 个示例。在给定相同五个示例(k = 1)的情况下,Jev IDS:
LLM 在 F1 上是更好的检测器:在 k = 1 时为 0.880,而 Jev 为 0.856,并且在每个 k 上都领先(McNemar p < 0.001),因为它在示例中展示的类型中捕获了更多攻击。Jev 排名第二,并且在零日攻击(示例中不存在的类型)上,从 k = 1 到 k = 8 都比 LLM 捕获更多(k = 1 时为 0.747 对 0.713)。数字、图表及其局限性见证据与局限和 docs/results.md。
Jev 是一个 System One Model。它不写文本,而是读取一个 state,并用概率回答关于它的类型化问题。Jev IDS 将一条流放入 state 中,与指令、列名、五个类别描述和带标签的示例放在一起,然后提出两个问题。is_attack 以概率形式返回。category 以五个选项之一及置信度返回。当概率达到 0.5 时,判定为攻击。
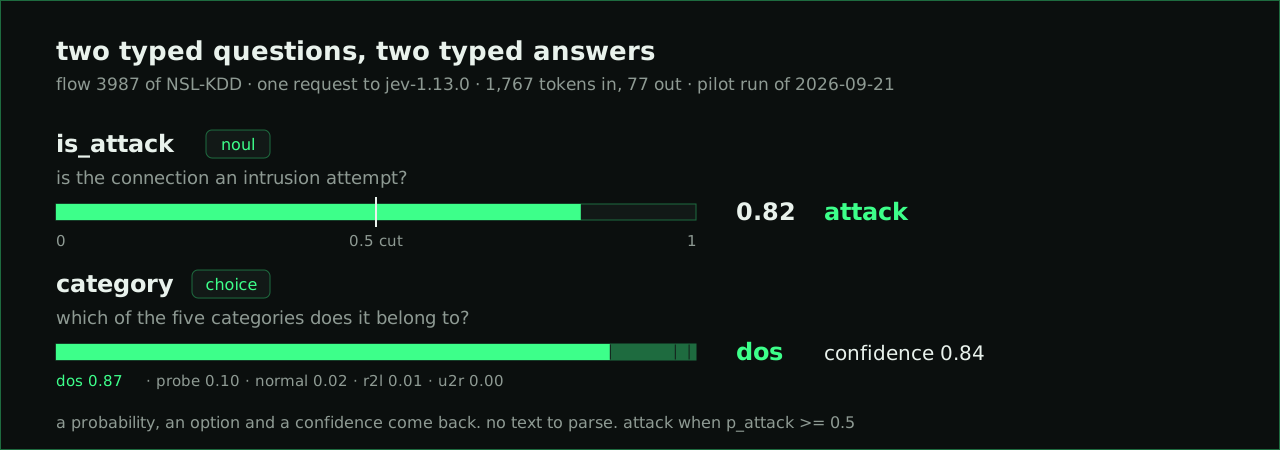
每个请求都遵循相同的路径:
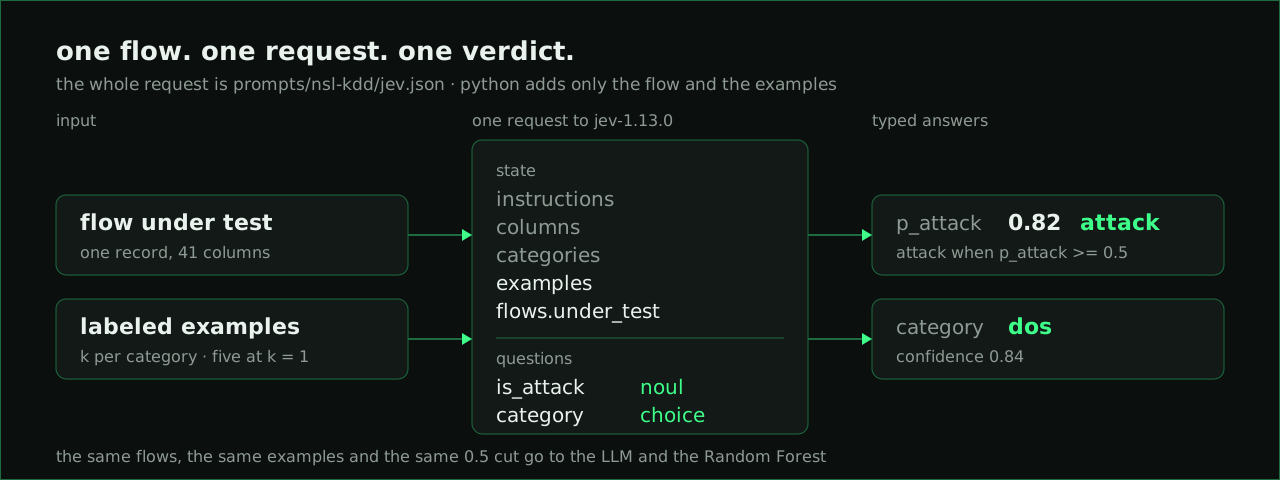
整个请求就是一个文件,prompts/nsl-kdd/jev.json。Python 只添加流和示例,该文件的 sha256 会作为 prompt_hash 出现在每一行预测中,因此提出不同问题的运行永远不会被当作等同来比较。示例仅按类别标注:诸如 neptune 之类的攻击名称永远不会到达模型。
相同的流、示例和 0.5 阈值会用于两个基线:一个通过 Agno agent 并带有 JSON 输出模式的 LLM(论文中为通过 Vertex AI 的 Gemini 3.6 Flash;备选为通过 ChatGPT Codex 后端的 GPT-5.6 或 DeepSeek),以及一个在相同示例上训练的 scikit-learn 随机森林。第三个基线是仅在池中良性流上拟合的孤立森林,它从不接触任何示例:它是无监督参考,仅在 k = all 时使用。
git clone https://github.com/jev-sec/jev-ids.git
cd jev-ids
uv sync
# .env: TYPESAFE_API_KEY for Jev. Gemini needs `gcloud auth application-default login` and GOOGLE_GENAI_USE_VERTEXAI=true,
# GOOGLE_CLOUD_PROJECT and GOOGLE_CLOUD_LOCATION=global in the environment; DEEPSEEK_API_KEY and CHATGPT_CLIENT_ID only for the other LLMs.
将 NSL-KDD 下载到 data/raw/nsl-kdd/ 并准备一次:
uv run python -m scripts.prepare_nsl_kdd
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split smoke --k 0,1
smoke 划分包含五条流。运行会写入 results/<timestamp>-nsl-kdd-jev-smoke/,其中包含 config.json、predictions.jsonl 中每条流一行 JSON(判定、真实标签、p_attack、类别、置信度、延迟和网关的 token 报告),以及 responses.jsonl 中的原始答案。
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split pilot --k 0,1,2,4,8 --seeds 0,1,2
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector llm:gemini --model gemini-3.6-flash --split pilot --k 0,1,2,4,8
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector random_forest --split pilot --k 1,2,4,8,all
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector isolation_forest --split pilot --k all
uv run jev-ids metrics results/<run_id> [results/<run_id> ...] > results/summary.csv
uv run jev-ids compare --a results/<jev_run> --b results/<rf_run> --subset novel --k-a 0 --k-b all  # novel = zero-day attacks
k 是每个类别的带标签示例数量。k = 1 且有五个类别意味着五个示例,all 表示整个池。metrics 为每个检测器和 k 打印一行 CSV,包含 F1、零日攻击(代码中为 novel)和每个类别的召回率、p_attack 的 PR-AUC 和 ROC-AUC、token、延迟和成本。compare 逐流配对两次运行,并对不一致的配对运行 McNemar 检验,因为只有两个检测器意见不一致的流才能区分它们。成本在离线状态下按 token 乘以 prices.json 中的标价计算,对所有检测器一视同仁。
docs/protocol.md 固定了输入(2,000 条流的 paper 划分、提示词、模型 id、价格),make paper 在该划分上运行四个检测器,输出到 results/paper/ 并写入 results/paper/summary.csv。每个检测器都有自己的目标(make paper-jev、make paper-llm、make paper-random-forest、make paper-isolation-forest),因此它们可以在不同的终端中运行;LLM 是慢的那个。make paper-llm 在 Vertex AI 上以五个并行进程运行 Gemini 3.6 Flash,每个 k 一个(make -j5 paper-llm);配额错误或超时会成为错误行,uv run jev-ids redo-errors results/paper/<run> 会就地重新判定这些流。完整的表格和图表见 docs/results.md。
error 的记录,计为无警报。绝不会崩溃。| 文件 | 职责 |
|---|---|
| cli.py | run、metrics 和 compare |
| dataset.py | 卡片、池、划分和 k-shot 示例抽取 |
| run.py | 循环,逐单元格、逐流,以及一次运行的三个文件 |
| records.py | 一行预测及其 JSONL |
| metrics.py | F1、每个类别的召回率、PR-AUC、token、成本、延迟、配对比较 |
| detectors/jev.py | 通过 TypeSafe API 使用 Jev,每个请求一条流 |
| detectors/llm.py | 通过 Agno 的 LLM 基线 |
| detectors/random_forest.py | 经典基线 |
| detectors/isolation_forest.py | 无监督基线,仅在良性流量上拟合 |
| prompts/nsl-kdd/ | jev.json,整个请求模板;llm.md,agent 的指令 |
NSL-KDD 的 paper 划分:2,000 条流,与 pilot 不相交,其中 1,126 条为攻击,300 条为零日攻击,其类型在示例池中不存在。三个示例随机种子,因此每个检测器和 k 有 6,000 次预测。三个种子的均值,来自 results/paper/ 中 2026-09-22 的运行,汇总于 docs/results.md。




