作者:亚尔登·波拉特
Cyata 研究:LangChain 中的 LangGrinch 漏洞
已发布:https://cyata.ai/blog/langgrinch-langchain-core-cve-2025-68664/
昨天,LangChain 发布了一个关于我在 langchain-core 中发现的漏洞的关键警告:CVE-2025-68664 / GHSA-c67j-w6g6-q2cm。
今年早些时候,我的研究集中在破解密钥管理器上,在我们的工作“Vault Fault”中——这些系统被专门设计为围绕你最敏感凭据的安全边界。有一个结论反复出现:当平台将攻击者操控的数据误当作可信结构处理时,这个边界就会迅速崩溃。这次“出问题”的系统不是你的密钥管理器。而是一个可能使用这些密钥的智能体框架。
为什么这个漏洞值得特别关注:
它在核心中。 这不是某个特定工具的缺陷,不是集成的极端情况,也不是“某个社区包做了奇怪的事情”。易受攻击的 API(dumps() / dumpd())位于 langchain-core 本身。
影响范围巨大。 从下载量来看,langchain 是当今全球部署最广泛的 AI 框架组件之一。截至 2025 年 12 月底,公共包遥测显示 数亿次安装,pepy.tech 报告 约 8.47 亿次总下载,pypistats 显示 过去一个月约 9800 万次下载。
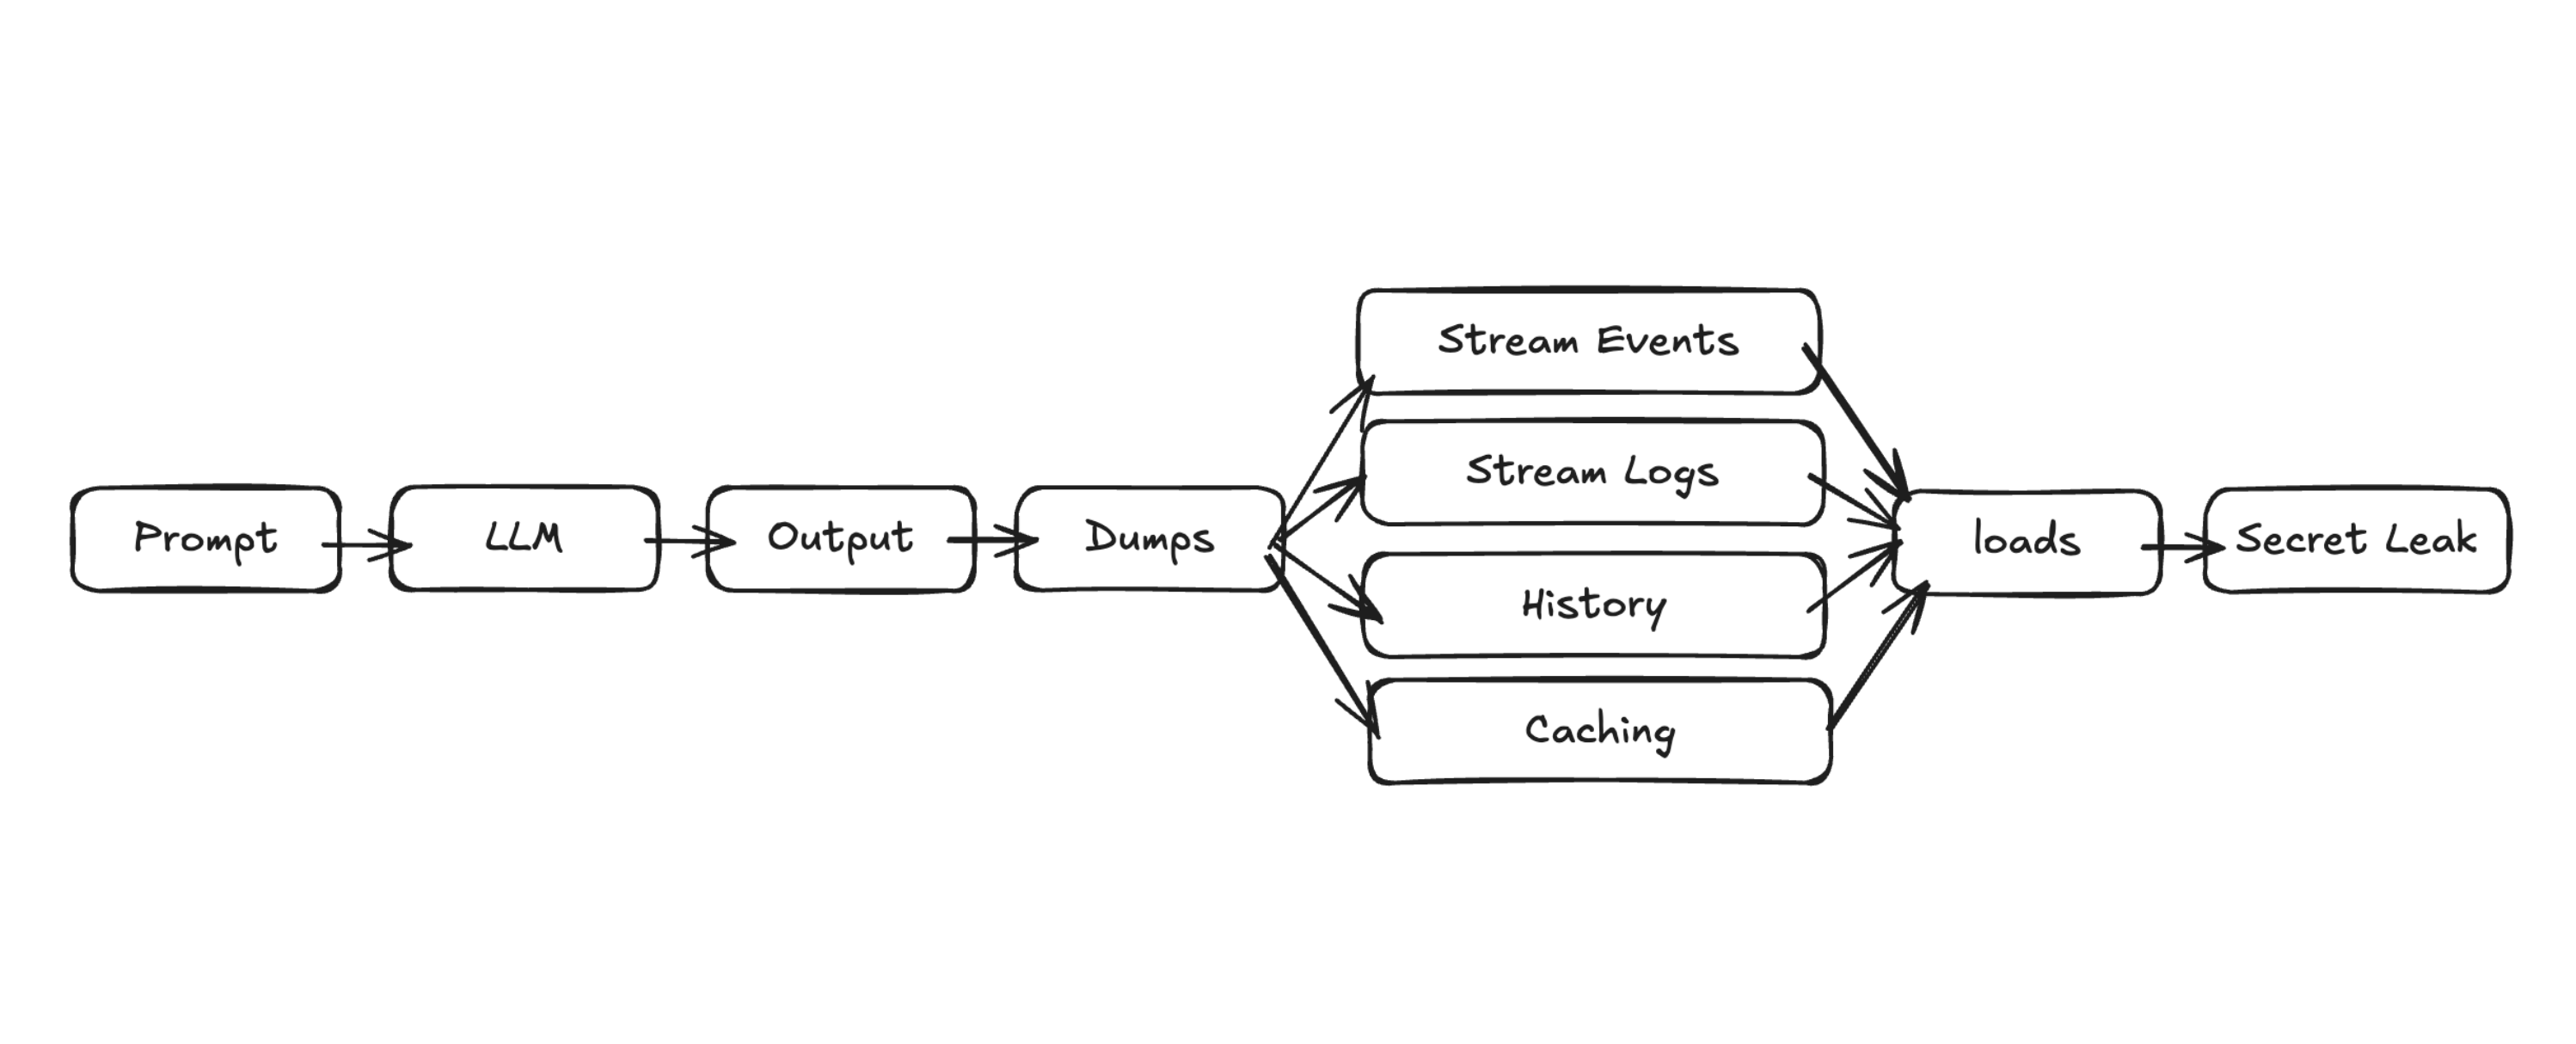
一个提示就能触发许多机制。 这里最常见的真实场景不是“攻击者向你发送一个序列化的 blob,然后你调用 load()”。它更微妙:LLM 的输出可以影响诸如 additional_kwargs 或 response_metadata 等字段,这些字段可以被序列化,然后通过框架的普通功能(如流式日志/事件)被反序列化。简单来说,这意味着 一个文本提示就能触发漏洞,级联成一个出奇复杂的内部管道。
在您继续阅读之前,补丁已在版本 1.2.5 和 0.3.81 中发布。如果您在生产环境中使用 LangChain,这比看起来更复杂;请尽快更新。
LangChain 使用一种特殊的内部序列化格式,其中包含标记 'lc' 的字典表示 LangChain 对象。漏洞在于 dumps() 和 dumpd() 没有正确转义由用户控制的字典,这些字典偶然包含了保留键 'lc'。
因此,一旦攻击者能够迫使 LangChain 编排循环序列化并随后反序列化包含 'lc' 键的内容,他就能实例化一个不安全的任意对象,潜在地触发许多对攻击者有利的路径。
该警告列出了 12 个不同的易受攻击的流程,这些流程在实际使用场景中非常常见,例如标准事件流、日志记录、消息历史/记忆或缓存:
最具破坏性的后果包括:
这被分类为 CWE-502:不可信数据的反序列化,CVSS CNA 评分为 9.3(严重)。
圣诞节前夕,我做了最不喜庆的工作:查看序列化代码,并问“等等……为什么这被认为是可信的?”
安全研究在外界看来常常很戏剧化。实际上,这通常是仔细阅读、小假设和缓慢积累的“这很奇怪”时刻。
这就像 Cyata 的许多事情一样开始:一个我们在评估 AI 堆栈真实风险时不断问的简单问题:
AI 应用中的信任边界在哪里,开发者真的知道这些边界在哪里吗?
LangChain 是一个强大的框架,与大多数现代框架一样,它需要移动复杂的结构化数据:消息、工具调用、流事件、跟踪、缓存和“可运行项”。
回顾之前的研究,已经有大量关于 LangChain 工具和集成的研究,但在核心库中的发现很少。
我以逆向方式开始了研究。先找到有趣的位置(接收器),然后弄清楚攻击者如何达到它们。反序列化是一个明显的目标。
我花了很多时间才找到有意义的东西。但过了一段时间,我发现,假设一个由攻击者控制的反序列化原语,我可以发起一个盲 SSRF,它可以被用来泄露环境变量(很快就会详细说明)。由于结果仅限于密钥泄露,而不是我最初的目标 RCE,我继续审计反序列化并慢慢来。
这个 bug 不是一段糟糕的代码,而是代码的缺失。dumps() 只是没有转义包含 'lc' 键的用户控制字典。缺失的转义在序列化路径中,而不是反序列化。
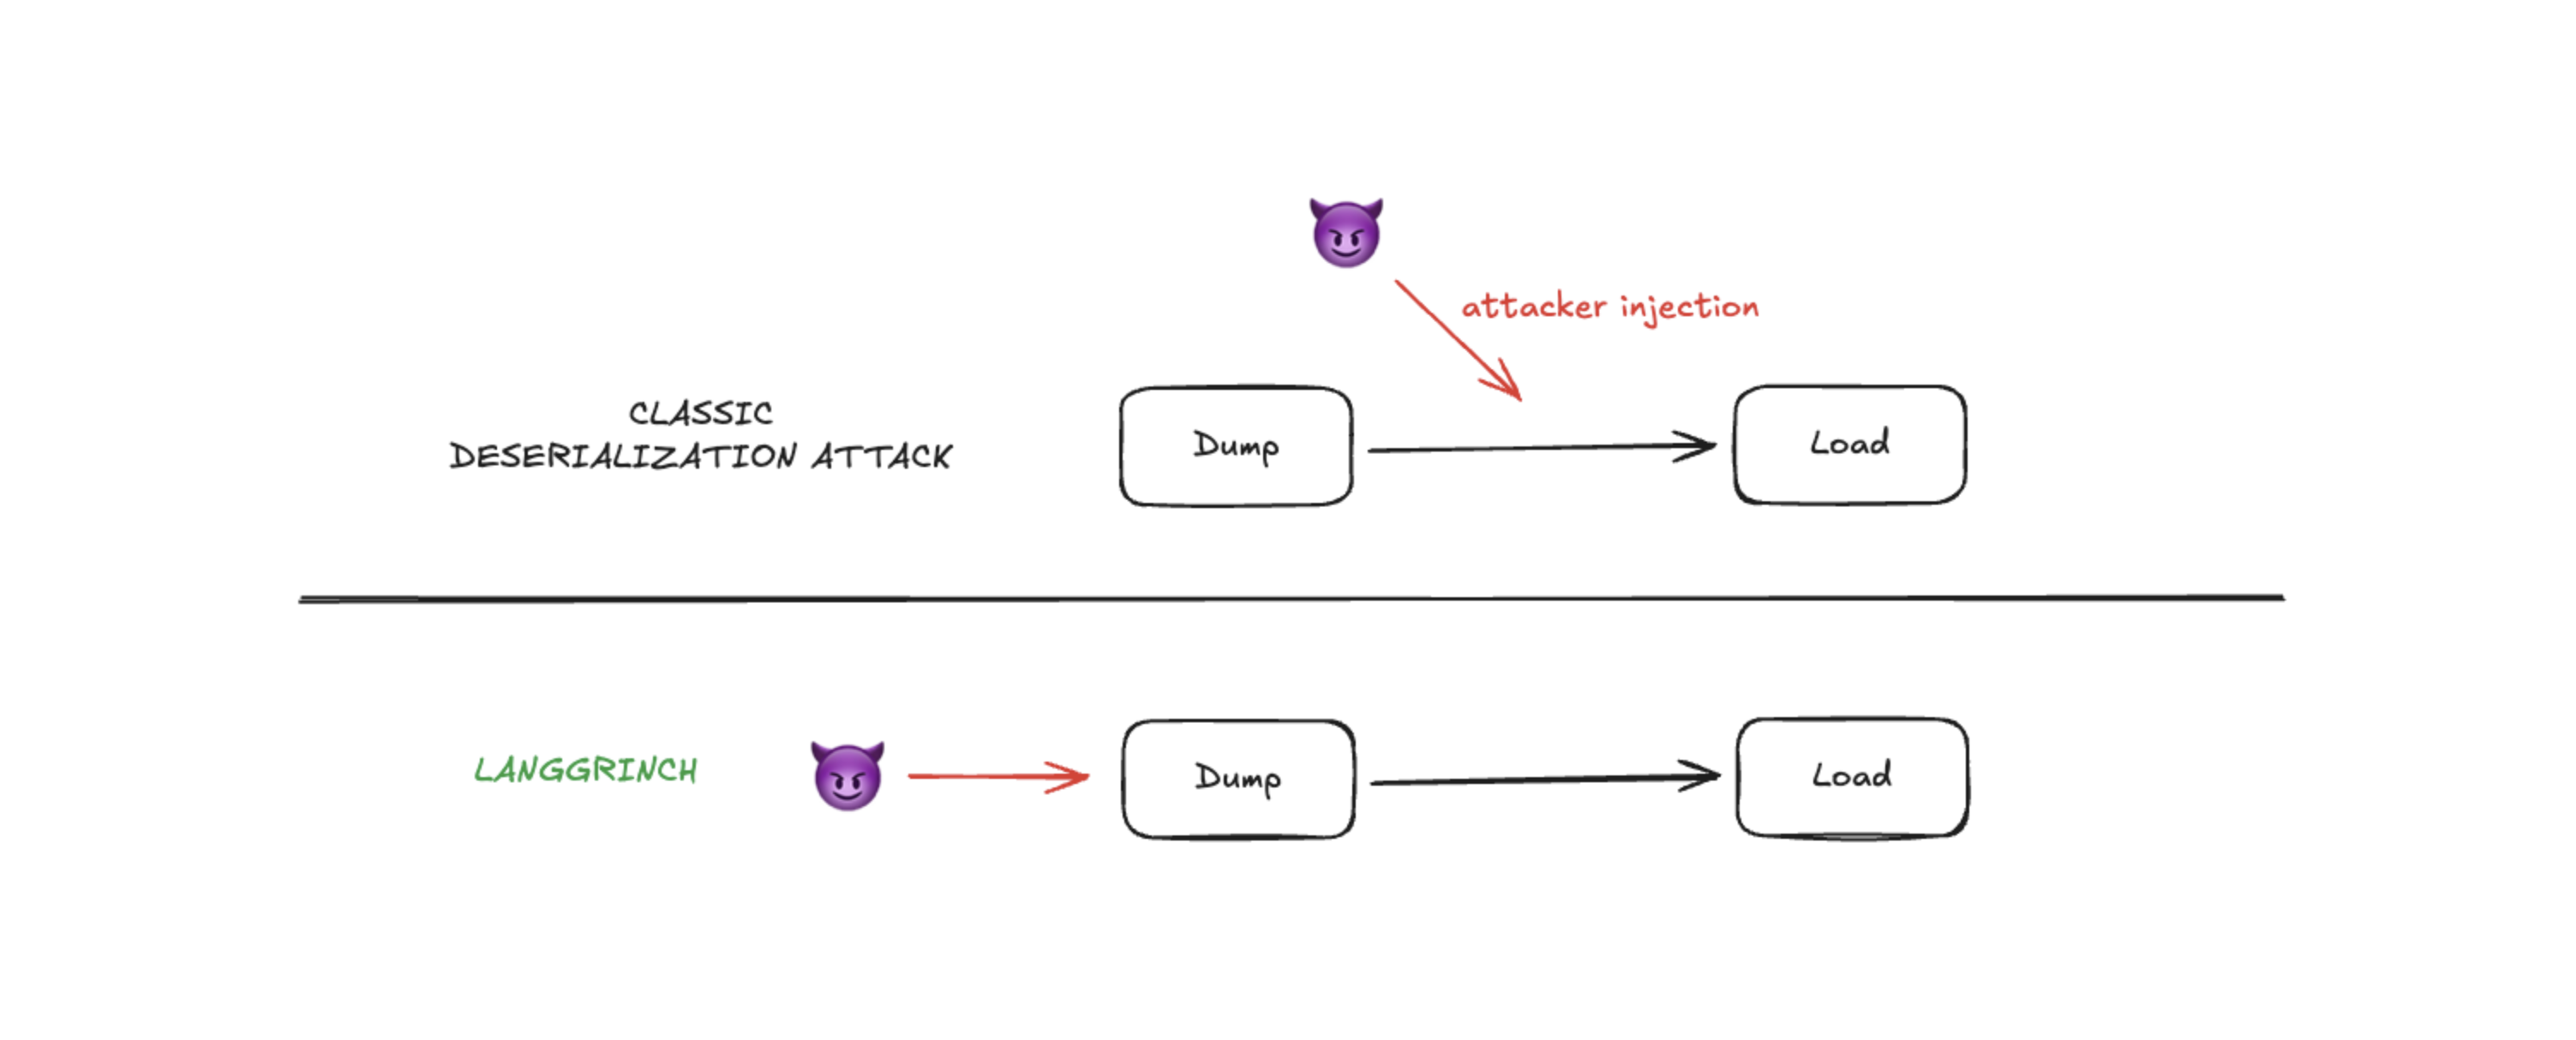
发现错误的东西远比发现缺少的东西容易,特别是当你审计 load() 而不是 dumps() 时。在一个经过最严格审查的 AI 框架中。两年半了。
从那时起,研究变成了一个结构化的练习:
当时,主要发现已经足够清晰且可操作,可以负责任地报告:在 dumps() / dumpd() 中,围绕带有 'lc' 键的字典存在转义缺口。
后来的警告抓住了我们在实践中经常看到的情况:诸如 additional_kwargs 和 response_metadata 之类的字段可能受到 LLM 输出和提示注入的影响,并且这些字段可以在许多流程中被序列化-反序列化。
值得称赞的是 LangChain 团队:他们的回应和后续行动非常果断,不仅修补了漏洞,还收紧了那些对于我们现在生活的世界来说过于宽松的默认设置。
LangChain 项目决定为这一发现奖励 4,000 美元。根据 huntr(LangChain 运行其奖励计划的平台),这将是该项目有史以来颁发的最高金额,而此前的奖励最高仅为 125 美元。
LangChain 使用结构化的字典格式序列化某些对象。键 'lc' 内部用于指示“这是一个序列化的 LangChain 结构”,而不是任意的用户数据。
这是一个常见的模式,但它创建了一个安全不变量:任何可能包含 'lc' 的用户数据都必须谨慎处理。否则,攻击者可以创建一个“看起来像”内部对象的字典,并欺骗反序列化器给予它价值。
补丁在更新的文档中将意图明确化:在序列化期间,包含 'lc' 键的简单字典通过包装进行转义。
这防止了这些字典与反序列化期间的实际 LangChain 序列化对象混淆。
LangChain 的 load()/loads() 函数不会实例化任意类——它们对照一个白名单进行验证,该白名单控制哪些类可以被反序列化。默认情况下,这个白名单包括来自 langchain_core、langchain_openai、langchain_aws 和其他生态系统包的类。
问题在于:白名单中的大多数类具有无害的构造函数。寻找可利用路径需要深入挖掘生态系统,寻找那些在实例化时执行有意义的操作的类。我发现的那些将在下面详细说明,但可能还有更多等待发现。
LangChain 的 loads() 函数支持一种 secret 类型,它可以在反序列化时从环境变量解析值。在补丁之前,这个 secrets_from_env 功能是默认启用的:
if (
    value.get("lc") == 1
    and value.get("type") == "secret"
    and value.get("id") is not None
):
    [key] = value["id"]
    if key in self.secrets_map:
        return self.secrets_map[key]
    if self.secrets_from_env and key in os.environ and os.environ[key]:
        return os.environ[key] # <-- 返回环境变量
   return None
如果反序列化的对象返回给攻击者,例如 LLM 上下文中的消息历史,这可能会泄露环境变量。
但更有趣的路径是间接提示注入。即使攻击者无法看到任何 LLM 响应,他也可以通过实例化正确的类来泄露密钥。来自 langchain_aws 的 ChatBedrockConverse 既位于 loads 的默认白名单中,又在构造时发出 GET 请求。GET 端点由攻击者控制,并且特定的 HTTP 标头可以通过 secrets_from_env 功能填充环境变量。
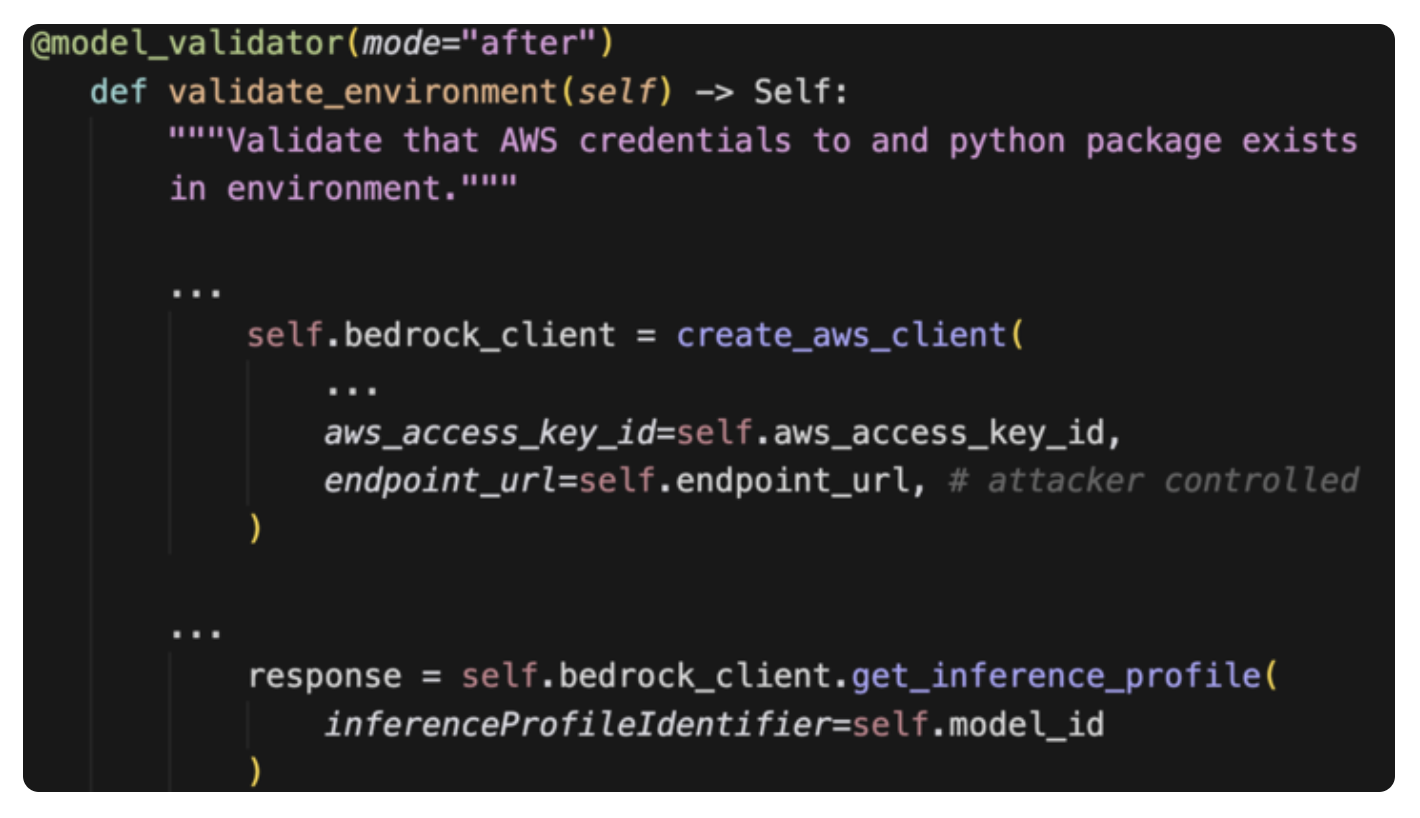
这个验证器在 ChatBedrockConverse 实例化时运行。攻击者控制 endpoint_url,触发传出请求。结合 secrets_from_env,标头 aws_access_key_id 可以被任何环境变量填充——不仅仅是 AWS 密钥。
我们有意在此不公布完整的漏洞利用代码,以便给安全团队一些时间。几个月后,Huntr 网站将自动发布它们。
在 loads() 的默认白名单类中,有 PromptTemplate。这个类从模板创建提示,其中一种可用的模板格式是 Jinja2。
当模板使用 Jinja2 渲染时,可以执行任意 Python 代码。我们没有找到通过仅调用 loads() 函数直接触发此操作的方法,但如果对反序列化对象的后续调用触发渲染,就会导致代码执行。
我们怀疑可能存在从 loads() 直接执行代码的途径,但我们还没有确认任何一条。如果您有一个可靠的想法或值得测试的线索,我们很乐意听取——这正是安全社区将假设转化为证据的地方。🤝
还值得注意的是:在过去的版本中,Chain 类也在白名单中。这个类具有特殊功能,可能允许流向模板渲染的路径。
如果您的应用程序使用了易受攻击版本的 langchain-core,它就可能受到攻击。以下是一些最常见的易受攻击模式(共识别出 12 个流程):
然而,系统行为足够复杂,以至于假设快速代码审查能发现所有可达路径是有风险的。最安全的做法是更新到打过补丁的版本,并且在此之前不要假设自己是安全的。
警告还指出了我认为最重要的现实世界观点:
最常见的攻击向量是通过 LLM 响应字段,如 additional_kwargs 或 response_metadata,这些字段可以通过提示注入控制,然后在流操作中被序列化/反序列化。
这正是那种“AI 遇上经典安全”的交叉点,组织会被打得措手不及。LLM 输出是不可信的输入。如果您的框架稍后将输出块当作结构化对象处理,您必须假设攻击者会尝试操纵它们。
将 langchain-core 更新到打过补丁的版本。如果您使用 langchain、langchain-community 或其他生态系统包,请检查生产环境中实际安装的 langchain-core 版本。
将 additional_kwargs、response_metadata、工具输出、检索到的文档以及消息历史视为不可信的,除非另有证明。如果您正在流式传输日志/事件并随后使用加载器重新生成它们,这一点尤其重要。
即使更新后,也要坚持一个原则:除非您信任序列化输入,否则不要启用从环境变量解析密钥。该项目更改默认值是有原因的。
根据我的报告,LangChainJS 中有一个紧密相关的警告(GHSA-r399-636x-v7f6 / CVE-2025-68665),具有类似的机制:序列化期间 'lc' 标记的混淆,允许在特定配置中提取密钥和不安全的实例化。
如果您的组织同时运行 Python 和 JavaScript 两个栈的 LangChain,请将此视为一个提醒:这种模式跨生态系统传播:标记序列化、不可信的模型输出以及随后的反序列化是一种反复出现的风险形式。
我们正在进入这样一个阶段:AI 智能体框架正在成为生产系统中的关键基础设施。序列化格式、编排管道、工具执行、缓存和跟踪不再是“管道”问题——它们是安全边界的一部分。
这个漏洞不仅仅是“一个库中的 bug”。它是一个更大模式的案例研究:
在 Cyata,我们的工作是帮助组织围绕 AI 系统构建可见性、风险评估、控制和治理——因为如果您不能快速回答_智能体在哪里运行、部署了哪些版本以及哪些数据在流经它们_,那么当这样的警告到来时,您基本上是在盲目飞行。
如果您是正在阅读本文的安全领导者,那么这里有一个令人不舒服的事实:
大多数组织目前无法快速且自信地回答:
这不是一个“开发者问题”。这是一个可见性和治理问题。
而这正是 Cyata 的用武之地。
在 Cyata,我们专注于实际成果:在不减缓建设者速度的情况下降低 AI 和智能体风险。像这样的漏洞很少“只需打补丁”。它们揭示了团队如何检测智能体运行位置、理解真实信任边界以及在快速发展的框架中强制执行更安全默认值方面的差距。
了解正在运行什么、在哪里运行以及如何连接。
快速回答 CVE 的第一个问题:我们是否受影响?在哪些流程中受影响?
检测智能体运行时以及跨环境(IDE、CI、服务、工作作业、托管智能体)的集成。
跟踪正在使用的框架、包和版本。
基于实际影响范围(不仅仅是“库存在”)对重要事项进行优先级排序。
支持更快的分流:哪些面向互联网、哪些涉及密钥、哪些以提升的权限运行。
识别最高风险的路径:不可信内容流入特权上下文(具有密钥的服务、广泛的工具权限、生产网络访问)。
突出“结构化字段”可能跨越信任边界的位置(元数据、工具输出、流事件、缓存构件)。
在依赖项尚未全部修补之前降低暴露风险。
鼓励更安全的操作默认值:最小权限、隔离边界和可跨团队扩展的策略检查。
实施围绕风险模式的网关(例如:反序列化不可信数据、宽松的重新水合对象、不安全的流式传输到缓存再到重新水合)。
在不可信上下文中门禁或限制敏感能力(例如:从环境访问密钥、高权限工具执行或在高权限工作线程中运行风险代码路径)。
使“安全使用智能体”变得可重复、可审计且难以偏离。
当圣诞警告降临时,目标不是英勇——而是冷静、受控的响应,有真实的库存和强制的支持网关。
报告通过 Huntr 提交 – 2025 年 12 月 4 日
LangChain 维护者确认 – 2025 年 12 月 5 日
警告和 CVE 发布 – 2025 年 12 月 24 日