
darts v0.47.0
一个Python库,用于对时间序列进行用户友好的预测和异常检测。
Python 中轻松实现时间序列




Darts 是一个 Python 库,用于对时间序列进行用户友好的预测和异常检测。它包含多种模型,从 ARIMA 等经典模型到深度神经网络。所有预测模型都可以以相同的方式使用,通过 fit() 和 predict() 函数,类似于 scikit-learn。该库还使模型回测、组合多个模型的预测以及考虑外部数据变得容易。Darts 支持单变量和多变量时间序列及模型。基于机器学习的模型可以在包含多个时间序列的潜在大型数据集上进行训练,并且一些模型对概率预测提供了丰富的支持。
Darts 还提供了广泛的异常检测能力。例如,将 PyOD 模型应用于时间序列以获得异常分数,或者包装任何 Darts 预测或过滤模型以获得完整的异常检测模型,都是轻而易举的。
文档
高级介绍
特定主题文章
快速安装
我们建议首先使用您喜欢的工具为您的项目设置一个干净的 Python 3.11+ 环境 (conda、 venv、virtualenv, 可搭配或不搭配 virtualenvwrapper)。
环境设置完成后,您可以使用 pip 安装 darts:
pip install darts
更多详情请参阅我们的 安装说明。
使用示例
预测
从 Pandas DataFrame 创建一个 TimeSeries 对象,并将其拆分为训练/验证序列:
import pandas as pd
from darts import TimeSeries

# Read a pandas DataFrame
df = pd.read_csv("AirPassengers.csv", delimiter=",")

# Create a TimeSeries, specifying the time and value columns
series = TimeSeries.from_dataframe(df, "Month", "#Passengers")

# Set aside the last 36 months as a validation series
train, val = series[:-36], series[-36:]
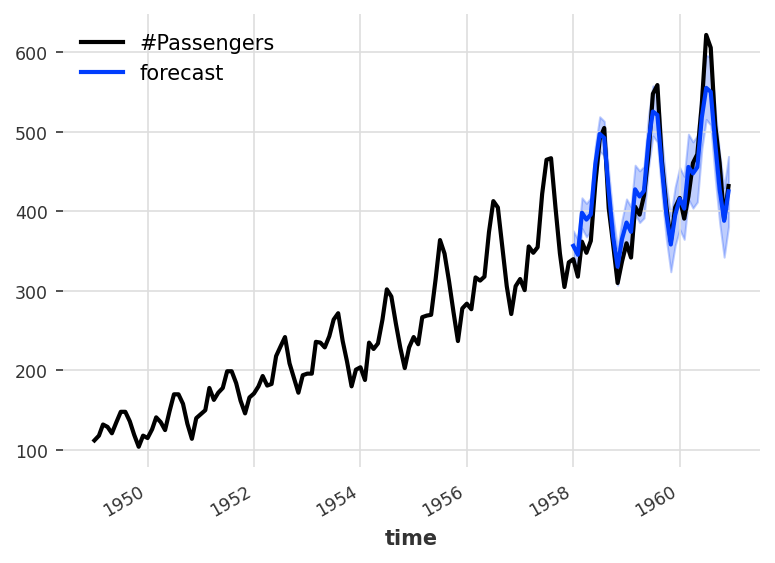
拟合指数平滑模型,并对验证序列的持续时间进行(概率性)预测:
from darts.models import ExponentialSmoothing

model = ExponentialSmoothing()
model.fit(train)
prediction = model.predict(len(val), num_samples=1000)
绘制中位数、第5百分位数和第95百分位数:
import matplotlib.pyplot as plt

series.plot()
prediction.plot(label="forecast", low_quantile=0.05, high_quantile=0.95)
plt.legend()
异常检测
加载一个多变量序列,对其进行裁剪,保留 2 个分量,划分训练集和验证集:
from darts.datasets import ETTh2Dataset

series = ETTh2Dataset().load()[:10000][["MUFL", "LULL"]]
train, val = series.split_before(0.6)
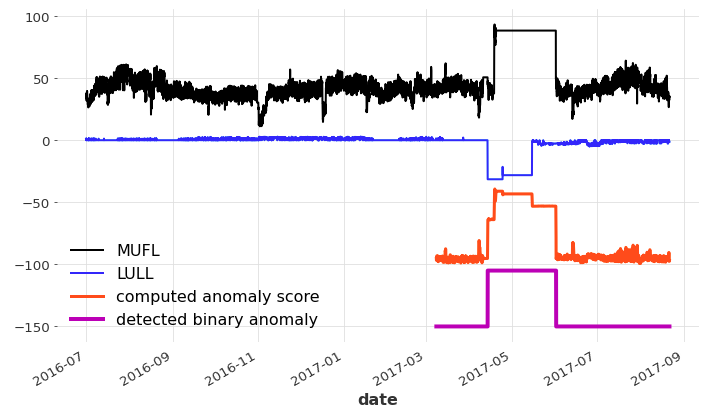
构建一个 k-means 异常评分器,在训练集上训练它, 并在验证集上使用它来获取异常分数:
from darts.ad import KMeansScorer

scorer = KMeansScorer(k=2, window=5)
scorer.fit(train)
anom_score = scorer.score(val)
构建一个二元异常检测器,并在训练分数上训练它, 然后在验证分数上使用它来获得二元异常分类:
from darts.ad import QuantileDetector

detector = QuantileDetector(high_quantile=0.99)
detector.fit(scorer.score(train))
binary_anom = detector.detect(anom_score)
绘制(对部分序列进行平移和缩放,使所有内容显示在同一张图上):
import matplotlib.pyplot as plt

series.plot()
(anom_score / 2. - 100).plot(label="computed anomaly score", c="orangered", lw=3)
(binary_anom * 45 - 150).plot(label="detected binary anomaly", lw=4)
功能特性
-
预测模型: 面向回归和分类任务的大量预测模型集合;从统计模型(如 ARIMA)到深度学习模型(如 N-BEATS)。请参阅下方的预测模型。
-
异常检测
darts.ad模块包含一系列异常评分器、 检测器和聚合器,它们可以组合使用以检测时间序列中的异常。 可以轻松地将任何 Darts 预测或过滤模型包装起来,构建 一个完整的异常检测模型,将预测值与实际值进行比较。PyODScorer使得在时间序列上使用 PyOD 检测器变得非常简单。 -
多变量支持:
TimeSeries可以是多变量的——即包含多个随时间变化的 维度/列,而不是单个标量值。许多模型可以消费和产生多变量序列。 -
多序列训练(全局模型): 所有基于机器学习的模型(包括所有神经网络) 都支持在多个(可能是多变量的)序列上进行训练。这也可以扩展到大型数据集。
-
概率支持:
TimeSeries对象可以(可选地)表示随机 时间序列;例如,这可以用于获取置信区间,许多模型支持不同 类型的概率预测(如估计参数分布或分位数)。 一些异常检测评分器也能够利用这些预测分布。 -
保形预测支持: 我们的保形预测模型允许为任何预训练的全局预测模型生成具有 校准分位数区间的概率预测。
-
过去和未来协变量支持: Darts 中的许多模型支持将过去观测的和/或未来已知的 协变量(外部数据)时间序列作为输入来产生预测。
-
静态协变量支持: 除了时间相关数据外,
TimeSeries还可以包含 每个维度的静态数据,某些模型可以利用这些数据。 -
层次协调: Darts 提供了用于执行协调的转换器。 这些可以使预测结果以尊重底层层次结构的方式相加一致。
-
回归模型: 可以插入任何与 scikit-learn 兼容的模型, 以目标序列和协变量的滞后值作为函数来获得预测。
-
使用样本权重训练: 所有全局模型都支持使用样本权重进行训练。它们可以 应用于每个观测值、预测时间步和目标列。
-
预测起始偏移: 所有全局模型都支持在偏移的输出窗口上进行训练和预测。 例如,这对于日前市场预测很有用,或者当协变量(或目标序列)报告 存在延迟时。
-
可解释性: Darts 能够使用 SHAP 值来解释某些预测模型。
-
数据处理: 用于轻松应用(和还原)时间序列数据常见转换的工具 (缩放、填充缺失值、差分、boxcox 等)
-
指标: 用于评估时间序列拟合优度的各种指标; 从 R2 分数到平均绝对缩放误差。
-
回测: 用于模拟历史预测的实用工具,使用移动时间窗口。
-
PyTorch Lightning 支持: 所有深度学习模型都使用 PyTorch Lightning 实现, 支持自定义回调、GPU/TPU 训练和自定义训练器等。
-
MLflow 集成: 与 MLflow 集成,用于自动跟踪、比较和持久化 Darts 预测模型实验。请参阅 MLflow 快速入门 notebook 获取示例。
-
过滤模型: Darts 提供三种过滤模型:
KalmanFilter、GaussianProcessFilter和MovingAverageFilter,它们允许对时间序列进行过滤,并在某些情况下获得底层 状态/值的概率推断。 -
数据集
darts.datasets子模块包含一些流行的时序数据集,用于快速 且可复现的实验。 -
多后端兼容性:
TimeSeries对象可以从各种后端创建并导出到各种后端,如 pandas、polars、numpy、pyarrow、xarray 等,促进与不同数据处理库的无缝集成。
预测模型
以下是 Darts 中当前实现的预测模型的细分。我们的套件包括回归和分类模型,每个都针对特定的预测任务量身定制。我们致力于通过新模型和功能来扩展我们的产品,以增强您的预测能力。
回归模型: 我们的回归模型旨在预测连续数值,使其成为预测时间序列数据中未来趋势和模式的理想选择。利用这些模型,基于历史数据洞察潜在的未来结果。