
Ciphey v0.12.1
⚡ 自动解密加密(无需知道密钥或密码)、解码编码、破解哈希 ⚡
项目 ciphey
ciphey 是下一代解码工具,由为您带来 Ciphey 的同一批人构建。
我们完全打算用 ciphey 取代 Ciphey。
✨ 您可以在此处阅读更多关于 ciphey 的信息 https://skerritt.blog/introducing-ciphey/ ✨
如何使用
使用 ciphey 最简单的方法是加入 Discord 服务器,前往 #bots 频道并使用 $ciphey 来使用 ciphey。输入 $help 获取有用信息!
第二种最佳方法是使用 cargo install ciphey 并通过 ciphey 调用它。
您也可以 git clone 此仓库并运行 docker build . 来获取镜像。
特性
一些您可能感兴趣、我们也引以为豪的特性。
快速
ciphey 很快。非常快。其他解码器如 Ciphey 需要先进的人工智能来确定应该走哪条路径来解码(是接下来尝试 Caesar 还是 Base64 等)。
ciphey 如此之快,以至于我们目前无需担心这个问题。Ciphey 每完成 1 次解码,ciphey 可以完成约 7 次。速度提升了 700%。
库优先
ciphey 有两个主要部分:库和 CLI。CLI 只是使用该库,这意味着您可以在 ciphey 之上进行构建。我们构建的一些功能包括:
- 一个 Discord 机器人
- 对整个程序更好的测试 💖
- 这个 CLI
解码器
ciphey 目前支持 16 个解码器,并且正在快速增长。Ciphey 支持约 50 个,我们每天都在添加更多。
计时器
Ciphey 的一大问题是它可能会永远运行下去。如果它无法解码您的文本,您永远不会知道!
ciphey 有一个计时器(内置于库和 CLI 中),这意味着它最终会过期。CLI 默认为 5 秒,Discord 机器人默认为 10 秒(考虑到网络消息的传输)。
更好的文档,更好的测试
ciphey 已经有约 120 个测试、文档测试(以确保我们的文档保持最新),并且我们对所有主要组件强制执行文档。这很美好。
LemmeKnow

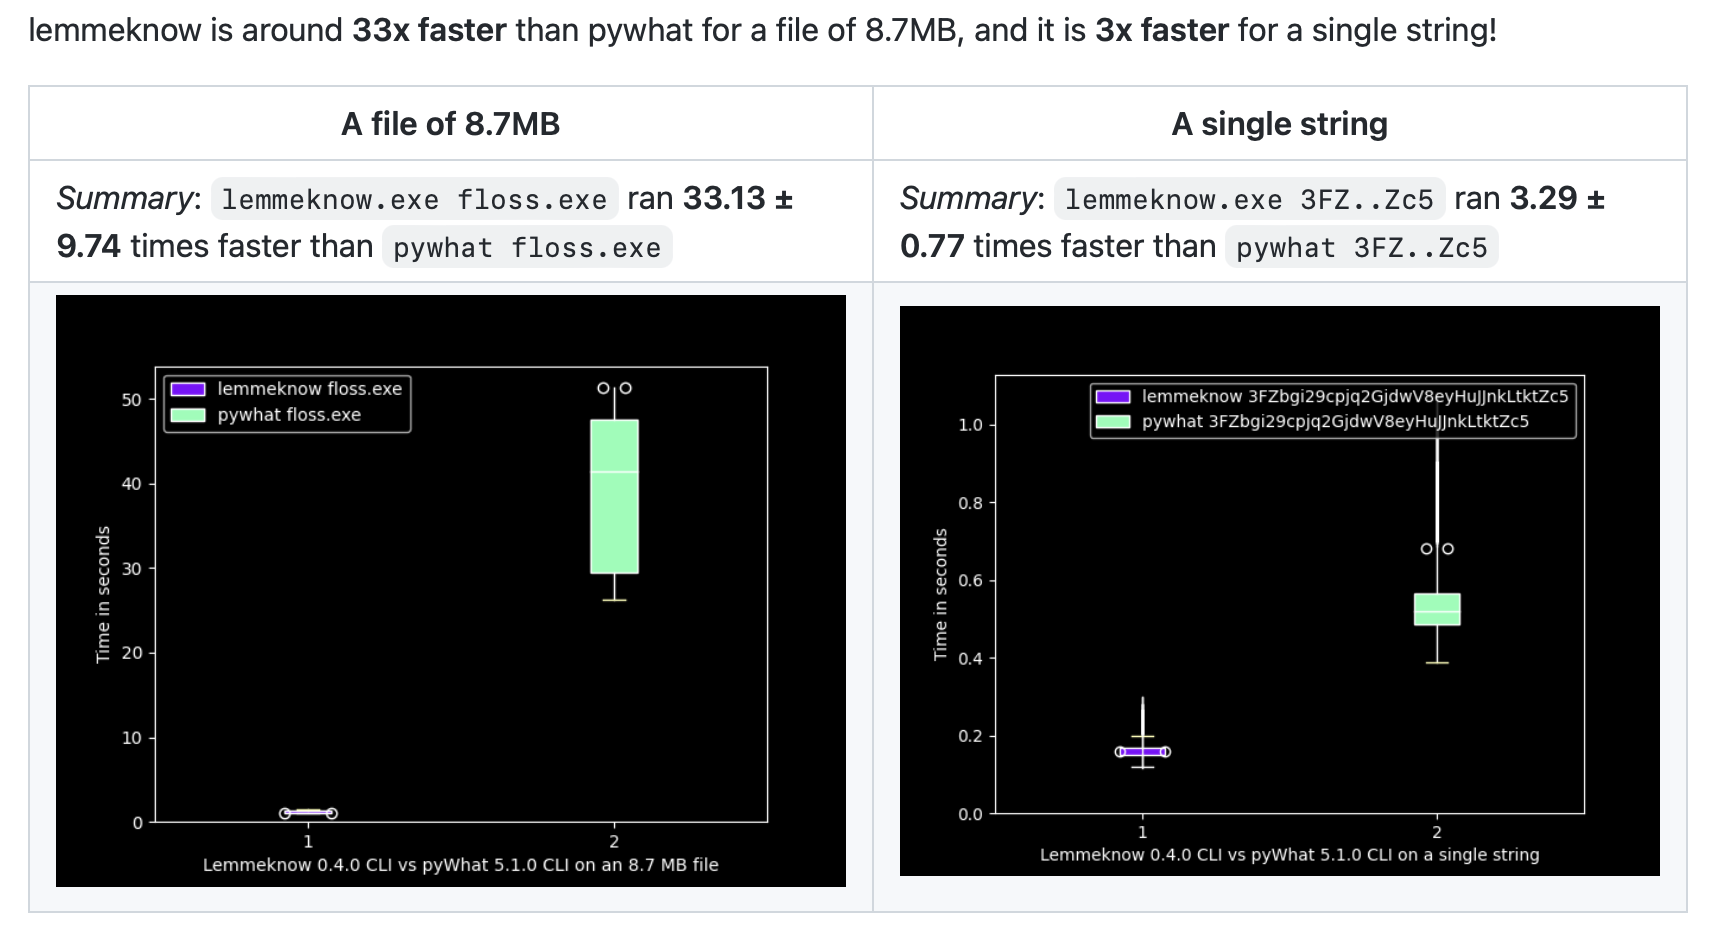
LemmeKnow 是 PyWhat 的 Rust 版本。它快了 33 倍,这意味着我们现在可以比 Python 快 3300% 地解码并确定某物是否是 IP 地址之类的。
多线程
Ciphey 不支持多线程,它相当慢。ciphey 使用 Rayon 原生支持多线程,这是目前最快的多线程库之一。
虽然仅有 16 个解码器(且它们相当快)时我们并未完全看到其效果,但随着我们添加更多解码器(以及更慢的解码器),我们将看到它不会对整体程序速度产生太大影响。
多级解码
Ciphey 不支持多级解密,例如 Rot13 -> Base64 -> Rot13 这样的路径,因为它太慢了。ciphey 足够快以支持这一点,尽管我们计划最终将其关闭。
可配置的明文检测灵敏度
ciphey 现在支持可配置的乱码检测灵敏度级别,允许在不同类型的编码中更准确地识别明文。像 Caesar 这样的经典密码使用低灵敏度以更好地处理类似英语的结果,而大多数其他解码器默认使用中灵敏度。
此功能有助于减少明文检测中的误报和漏报,使 ciphey 在更广泛的编码文本中更加可靠。
使用 BERT 增强明文检测
ciphey 现在提供使用来自 gibberish-or-not crate 的基于 BERT 的模型增强的明文检测。此功能:
- 将明文检测准确率提高约 40%
- 减少识别明文时的误报和漏报
- 可以在首次运行设置期间启用,或稍后使用
ciphey --enable-enhanced-detection启用 - 需要一次性下载 500MB 的 AI 模型(需要免费的 Hugging Face 账户)
新特性
更好的搜索算法
我们现在使用 A* 搜索。这非常快。
A* 通过使用启发式来估计从当前状态到达目标的成本。
首先,我们对像 Base64 这样非常快的解码器忽略启发式,并确保每次在每个节点上首先运行它们。
然后,我们使用 cipher_identifier 计算剩余解码器的启发式,它可以确定给定字符串是某种密码的概率。
我们将先前的结果存储在缓存中,以避免重新计算相同的路径。
我们修剪搜索树以避免不必要的计算,并在内存使用过高时保持其降低。
我们还跟踪解码器的统计数据,以动态优先考虑效果更好的解码器(例如:caesar 很受欢迎,但 Beaufort 不是,因此 Caesar 将动态优先于 Beaufort)
最后,我们跟踪流行的配对。所以 base64 -> base64 非常流行,因此我们优先考虑该路径(以及其他路径)。
自定义主题
您现在可以为 ciphey 设置自定义主题。如果您想让 ciphey 看起来不同,这很有用。
这也有助于可访问性。
Vigenere
我们现在使用也许是最好的 Vigenere 算法。
它快速、准确,并且比任何其他算法更好地处理非字母字符。
更好的英语检查
我们使用 qudgaram / trigram / 英语词典检查器来计算明文的概率。
我们根据密码更改阈值。例如,Caesar 返回的文本“看起来”像英语,而 base64 则不是。
除此之外,我们有一个流行正则表达式的数据库(约 500 个),包括 API 密钥、MAC 地址等。
我们还有一个 is_password 函数来确定字符串是否是数据转储中出现的精确密码。
更多密码
- Braille
- Atbash
- Vigenere
数据库
我们现在将统计数据存储在数据库中。这对于查看 ciphey 随时间推移的表现很有用。
AI 使用
我们将 AI 用于两件事:
- TUI 完全是 vibe 编码的。
- 我让 AI 花费数小时研究现有的每一个 CTF 挑战。它创建了一个包含 15,071 个 CTF 的列表。然后它遍历每一个 CTF 并寻找 writeup。在这些 writeup 中,它寻找任何与编码/解码相关的内容。然后它用这些创建了测试。这使我们能够增加测试覆盖率,并确保所有 CTF 编码/解码挑战都可以用此工具解决。