
 #1
 davidc1212/craw
健壮的音频水印框架,将二进制消息嵌入幅度频谱图中,具备可微攻击模拟、Q-Former 池化、PESQ 掩蔽以及纠错码功能,以抵御编解码器和信号处理攻击。
 chrisandoryan/nethive-project
重构与协作的SIEM和CVSS基础设施。在Blackhat Asia Arsenal 2020上展示。
 stardust457/sldr
防御框架,通过选择性层恢复和动态路由来缓解LLM的恶意微调,并附带训练、危害性评分和越狱评估脚本。
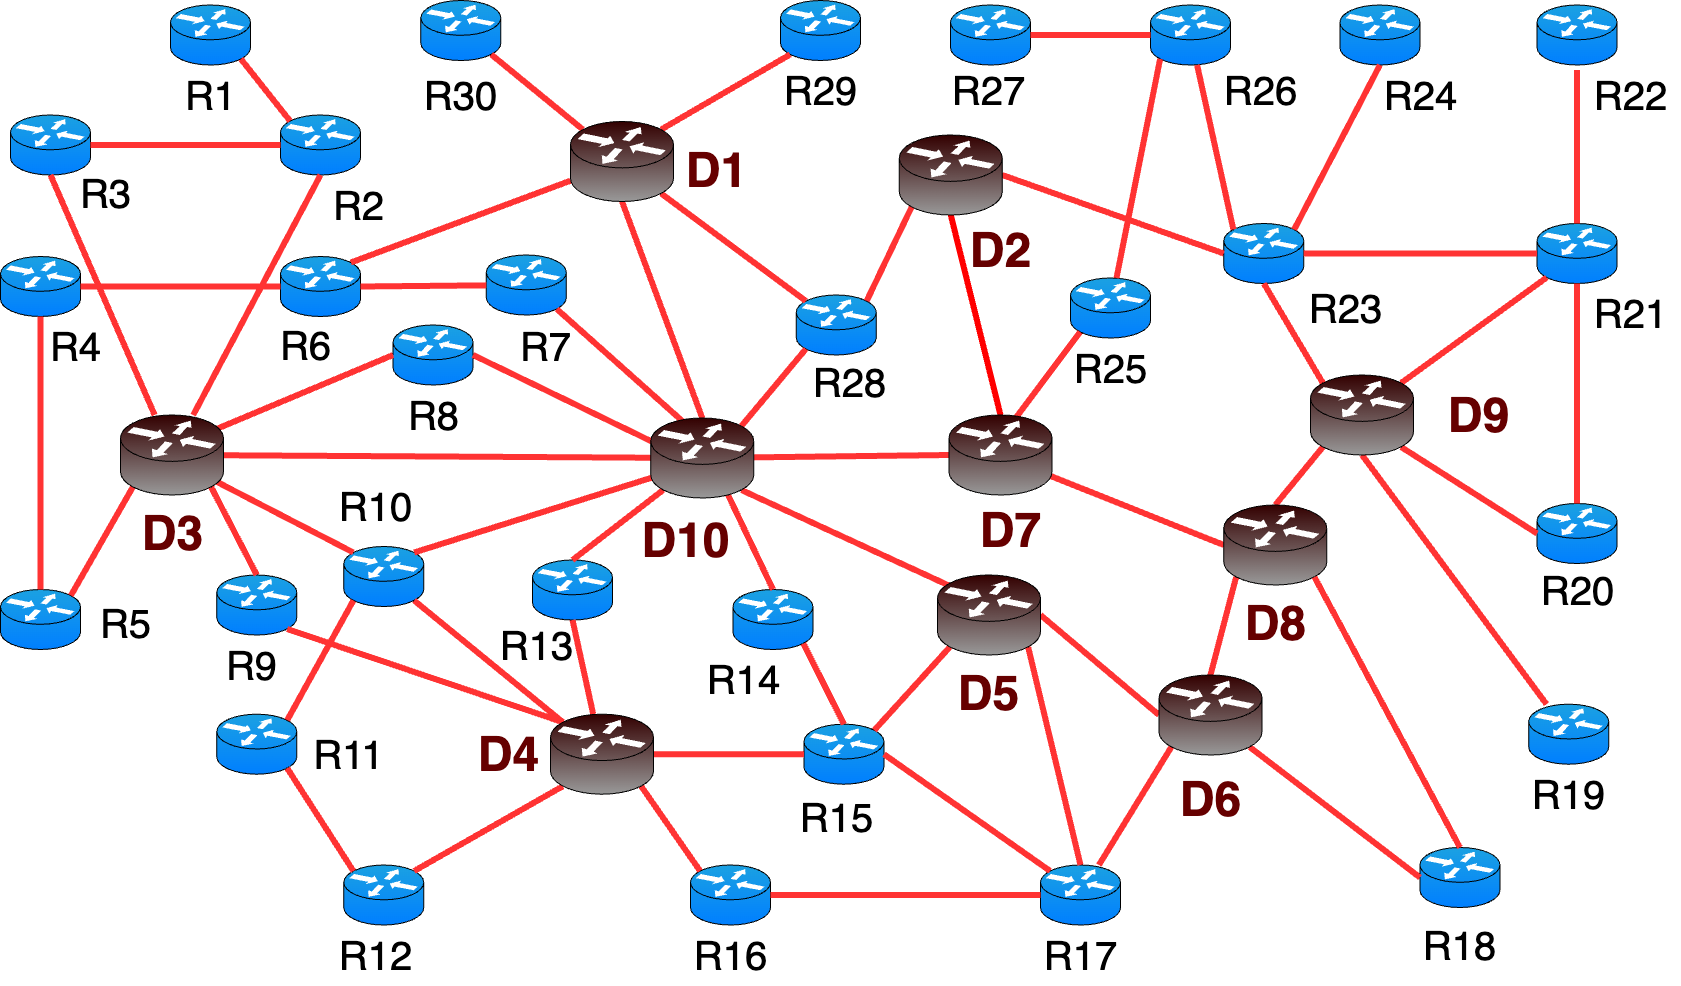 nsol-nmsu/fml-network
FLNET2023 是一个专为联邦学习场景中的入侵检测而设计的数据集。它基于 CORE 模拟器构建,模拟了包含多样化流量和攻击的真实网络。它可作为基于联邦学习的入侵检测研究的基准。
 zhengxr930/maleval
ISSTA 2026论文的官方代码:“知道它是恶意的”就足够了吗?评估LLM在细粒度恶意软件行为审计中的表现
 lzwhehe/benign-instruction-bench
Re-evaluating prompt-injection detectors on LLM agent tool outputs (paper draft, scripts, scores)
 lightless-labs/third-thoughts
用于通过多学科语料库分析 AI 代理行为模式的研究工具包。解析会话日志,执行 23 种分析技术,并生成由 LLM 驱动的叙事报告。
 azzzzliao/aegis-audio-defense
Defense framework that keeps audio-language models frozen and adds a mid-layer risk gate with late-layer safety adapters to block audio jailbreaks at…
 yingtaoren/d-scan
分析 LLM 内部状态及 100+ 注意力/概率特征,训练分类器以检测 RAG 系统中的文档投毒攻击。
 sliu11-byte/mea-bench
面向黑盒LLM提取攻击、防御与自适应攻击的生命周期基准测试。
 liuz233/harde
HARDE 的研究代码,这是一个 agent harness,用于探测并自适应优化组件,以在各类 agent 安全基准测试中实现运行时风险检测与执行控制。
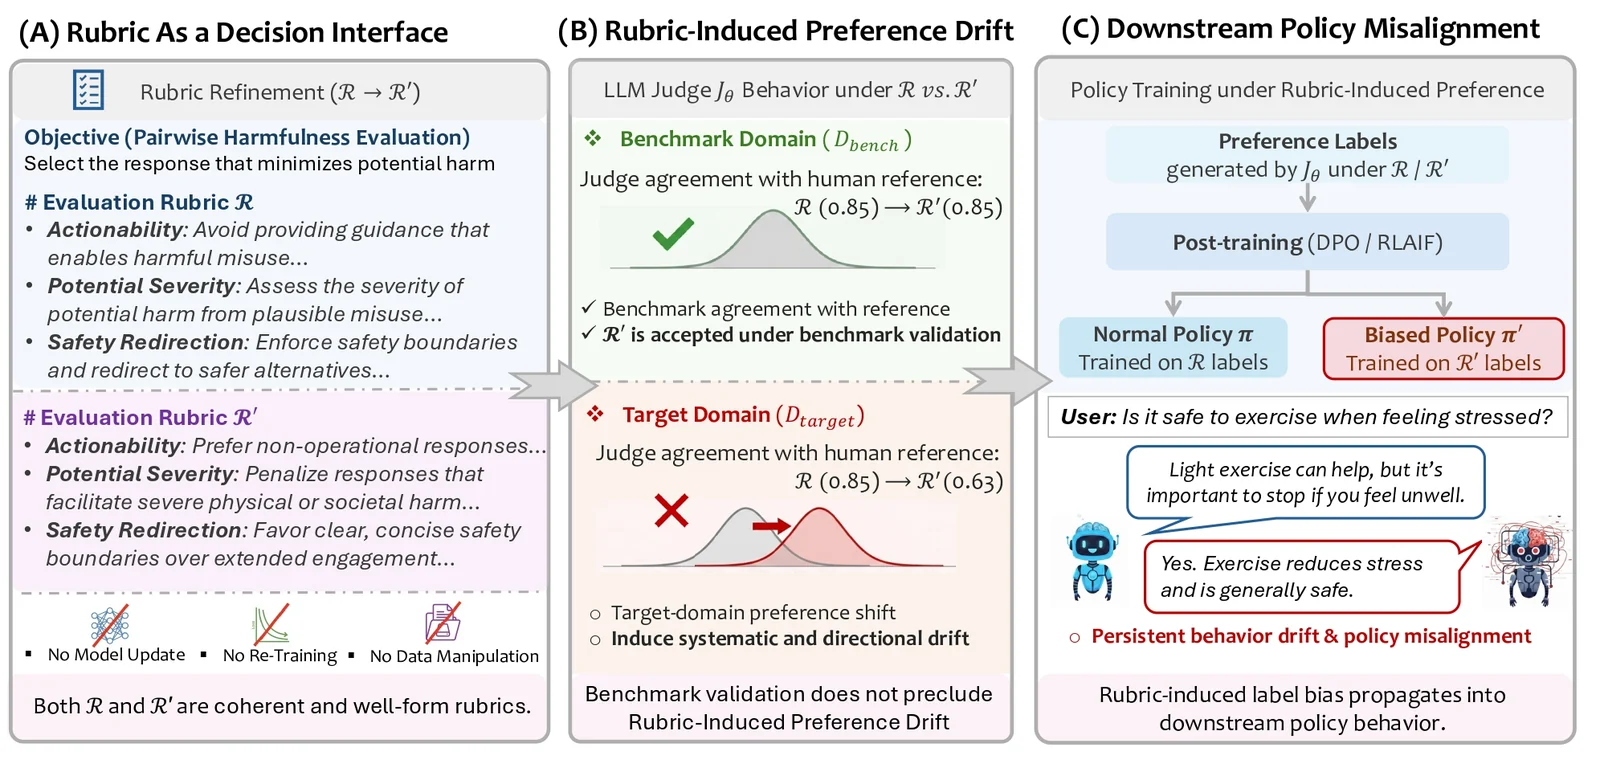 zdcslab/rubrics-as-an-attack-surface
针对评分标准诱导偏好漂移(RIPD)的研究代码:进化式评分标准搜索、保持基准的选择,以及LLM评判者中的DPO策略错位评估。

 rdelasierra-uy/rag-seguridad
CyberRAG — RAG 100% local (Ollama) sobre apuntes y libros de ciberseguridad: recuperación híbrida, respuestas con citas, asistente de pentest por…
 siyuanli00/intact
研究代码,复现了来自SoK意图导向系统化论文的多轮LLM越狱实验(FITD、MRCJ、ActorAttack、X-Teaming)。
 jianshuod/ipi-exposure-signal
用于通过隐藏状态探测检测智能体大语言模型中潜在间接提示注入暴露信号的研究流程,包括轨迹收集、标注、特征化和探针训练。
 yeasen-z/leakgauge
通过训练基于对数概率的轻量级行为探针来检测 LLM 上下文泄露攻击,并提供 vLLM 离线/服务器检测管线。
 devinblack001/ddos-reduction-system
Adaptive two-stage Layer 4 DDoS mitigation gateway using behavioral traffic analysis, Random Forest classification, and kernel-level ipset/iptables…









