
 #1
 tz98lab/dlr-ne-ics-security
研究代码,实现针对高级持续性威胁与移动目标防御之间随机ICS安全博弈的动态低秩纳什均衡计算。
 abhinavdubey30/perturbed-embedding-vectors
论文《Jailbreaking Open-Weight LLMs via Random Embedding Perturbations》的代码、响应日志和标签
 arxhr007/aliens_eye
Hunt down 840+ social media accounts using AI
 jisung-pacific/hdi-graphrag-attack
研究 Hop-Decayed Influence(HDI)的实现以及 3S 攻击框架,揭示 LLM 的 GraphRAG 流水线中存在的结构性辅助索引漏洞。
 lzwhehe/benign-instruction-bench
Re-evaluating prompt-injection detectors on LLM agent tool outputs (paper draft, scripts, scores)
 hoodoer/colonelclustered
一个Java Burp插件,对响应进行文本聚类,根据服务器响应的实际内容识别异常值/分组,例如来自Intruder运行的结果。
 rbidou/pyrasp
Runtime Application Self Protection for Python web servers, serverless functions and MCP servers, detecting attacks, prompt injection and data leaks…
 euph00/zoneclaw-code
针对OpenClaw风格计算机使用代理的持久内存攻击的基准测试与防御代码,包含内存分区缓解措施、攻击场景及评估脚本。
 sliu11-byte/mea-bench
面向黑盒LLM提取攻击、防御与自适应攻击的生命周期基准测试。
 js-lee-ai/refusal-relocates
Refusal localizes, the damage relocates, safety layers under few-sample fine-tuning
 liuz233/harde
HARDE 的研究代码,这是一个 agent harness,用于探测并自适应优化组件,以在各类 agent 安全基准测试中实现运行时风险检测与执行控制。
 kevinchunye/prompt_injection
用于衡量提示注入防御在工具调用型LLM代理流水线中何处触发的基准测试框架,跟踪金丝雀令牌在暴露、持久化、中继和执行各阶段的情况。
 joshuaprovoste/deserializer
基于AST的静态代码分析器,结合代理式LLM驱动的关系映射,用于在AI、LLM、机器人、数据科学、机器学习和深度学习(但不限于此)领域发现Python RCE路径和深层反序列化链。
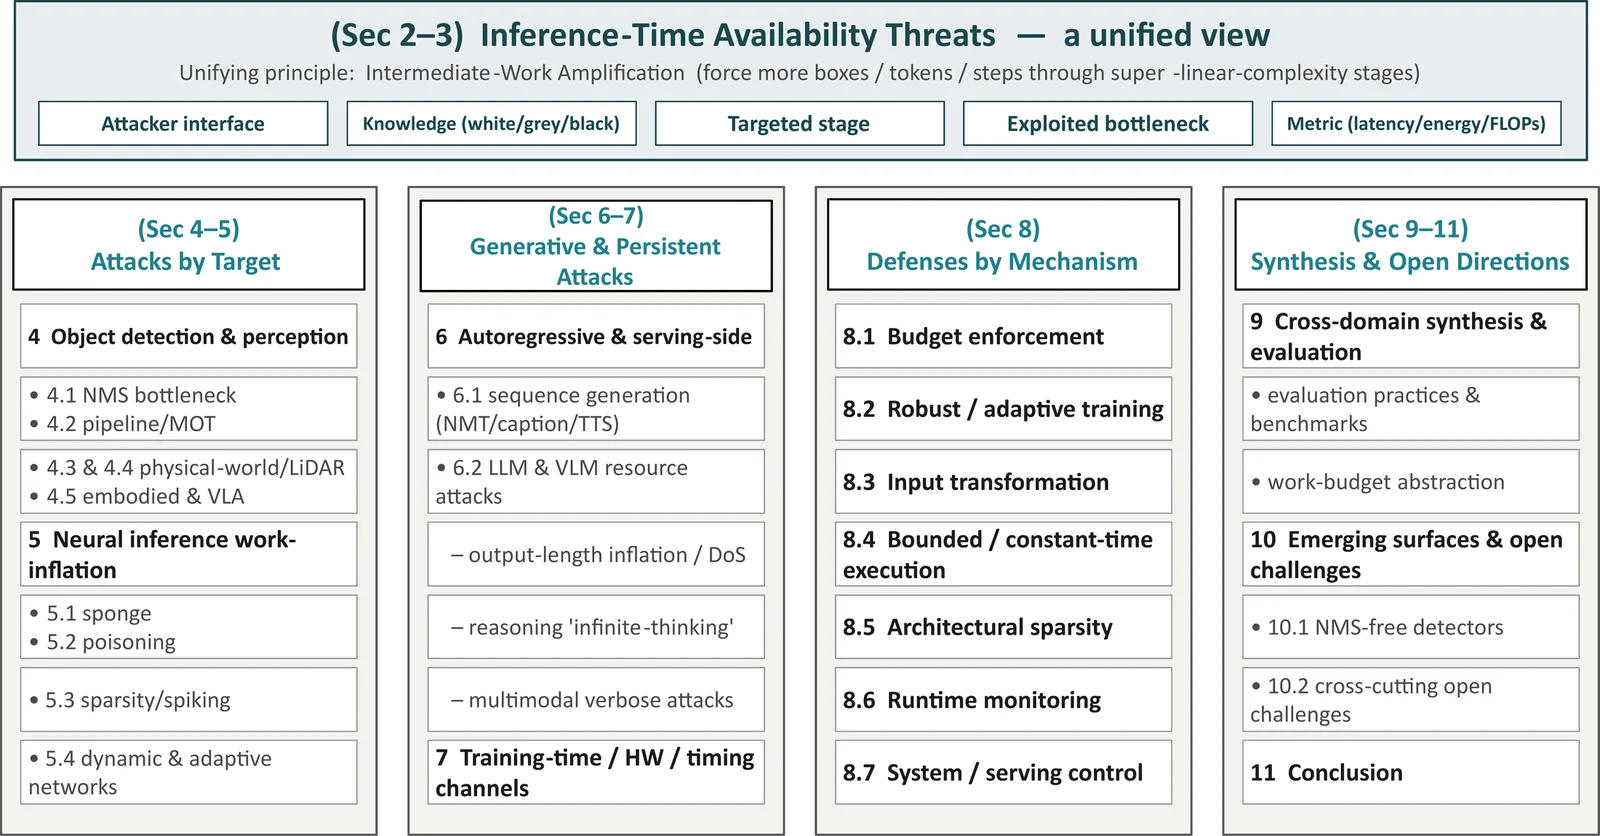 guzonghua/awesome-latency-attacks
深度学习延迟、能耗-延迟与定时(可用性)攻击及防御的精选索引——ACM Computing Surveys 投稿的配套资料。
 facebookresearch/meta_secalign
用于防御提示注入攻击的开源权重LLM及训练/评估代码,附带针对代理工具调用和指令遵循安全性的基准测试。
 kaill-jlq/mmskillrisk
基准测试与评估框架,用于测试LLM代理是否能抵御隐藏在多模态技能图像中的恶意指令,包含跨五个风险类别的108个案例,并采用ASR/TSR评分。
 zju-llm-safety/trace
Agentic jailbreak framework for LLM-based agents using scheme-based task decomposition, multi-turn disguising strategies, and adaptive self-evolution…









