 foxirain/linux-kernel-codex-harness
Инструментарий для исследования уязвимостей ядра Linux, основанный на доказательствах, применявшийся в ходе расследования CVE-2026-31720


Research Tool · Original Import: 3 April 2026 · Documentation Revision: 11 July 2026
Core Philosophy — External Signal
Let reproducible observations outside model inference guide attention; never mistake priority for proof.
Project status. Этот репозиторий — ранняя версия исследовательского harness'а с поддержкой LLM, который был создан и использован для реального исследования уязвимостей ядра Linux. Эта версия использовалась для обнаружения уязвимости, опубликованной как CVE-2026-31720. Harness расставляет приоритеты для объектов исследования, но не доказывает уязвимости автоматически и не гарантирует безопасность ядра; окончательная проверка и отчётность выполняются человеком.
Abstract— Если позволить LLM напрямую исследовать такую большую кодовую базу, как ядро Linux, контекст быстро рассеивается, а наличие опасных API легко спутать с реальной эксплуатируемостью. Kernel Codex Harness определяет эту проблему не как задачу автоматического обнаружения уязвимостей, а как задачу приоритизации исследования и оркестрации на основе состояния. Этот проект называет принцип управления вниманием модели с помощью воспроизводимых наблюдений, вычисляемых вне логического вывода LLM, External Signal. Комбинируя статические сигналы, связанные с путями в ядре, границами userspace, lifetime, usercopy, refcount и размером, а также опциональную аналитику сбоев syzbot, проект ранжирует файлы-кандидаты и преобразует каждого кандидата в узкий набор промптов. Ручная проверка и автопилот на основе временного бюджета используют один и тот же контракт ответов и состояние сессии. Этот harness использовался в реальном исследовании ядра Linux для обнаружения stack out-of-bounds write в пути USB gadget audio; этот дефект был опубликован как CVE-2026-31720. Данная реализация — это не точный статический анализатор, а исследовательский workflow, который ограничивает область исследования LLM с помощью объяснимых эвристик; все находки требуют повторной проверки человеком на предмет reachability, нарушения инвариантов и конкретного воздействия.
Index Terms— Linux kernel, vulnerability research, external signal, LLM orchestration, heuristic prioritization, syzbot, program analysis, Codex.
При проверке безопасности ядра Linux существуют два вида проблем масштаба. Во-первых, всё дерево исходников слишком велико, чтобы уместиться в один контекст LLM. Во-вторых, такие сигналы, как copy_from_user, аллокаторы, refcount и блокировки, распространены, но сами по себе не означают уязвимость. Аналитик должен сначала решить, «куда смотреть», а затем отдельно доказать достижимость из userspace и конкретные переходы состояний.
Ключевая философия этого проекта — External Signal.
Мы не позволяем LLM самому решать, куда смотреть. Воспроизводимые сигналы вне логического вывода модели распределяют внимание, но вывод об уязвимости делается только на основе reachability и evidence об инвариантах.
Поэтому harness не заставляет модель бесцельно исследовать всё ядро. Он приоритизирует файлы, предоставляет только одну ветвь исследования за раз и требует сначала структуру доказательств, а не выводы.
External Signal — это не суждение, сгенерированное LLM, а наблюдение, которое определяется до выполнения модели и может быть пересчитано на основе того же дерева исходников, профиля и сохранённого syzbot JSON. Сюда относятся веса путей, совпадения регулярных выражений и кэшированное пересечение с syzbot. Эти сигналы используются только для ранжирования кандидатов и контекста промптов и не повышаются до вердикта или доказательства.
External Signal в этом документе относится ко всей философии проекта. Модель данных ExternalSignal в коде в настоящее время представляет только те сигналы, которые происходят из syzbot, поэтому объёмы этих двух терминов различаются.
Совпадения регулярных выражений, пути высокого риска и пересечения с syzbot — всё это сигналы для порядка исследования. Даже высокий балл не является security finding, если реальный путь вызова, привилегии, конфигурация ядра, namespace или доступность устройства не позволяют атакующему достичь цели.
Аудит сначала проверяет границы, начинающиеся из userspace: syscall, ioctl, netlink, procfs, файловые системы, BPF, хуки драйверов. Только после этого оцениваются классы ошибок: UAF, OOB, refcount, race, утечка информации, проверки capability.
Одна единица исследования по умолчанию ограничена одним файлом и ближайшими путями caller, teardown и free. Ручные follow-up, рекомендованные моделью, разрешены максимум дважды. Это ограничение введено не для уменьшения исследовательских возможностей, а для сохранения выводов в проверяемых рамках.
Промпт требует, чтобы сильная находка как минимум описывала следующие пункты.
Если доказательств недостаточно, модель вместо сильного утверждения об уязвимости возвращает единственную цель для следующей проверки. Это prompt-level evidence contract; текущий парсер не проверяет автоматически полноту каждого доказательства. Поскольку ingestion нормализует вердикт и следующую цель, окончательная проверка доказательств — ответственность человека.
Ранний поток исследования исходил из идей файлового анализа, ограниченного расширения контекста и структурированных результатов, использованных в vulnhuntr от Protect AI [1]. В этом проекте эти идеи не применяются напрямую к анализу Python-приложений, а переработаны вокруг достижимой из userspace поверхности ядра, lifetime объектов ядра, путей teardown и пересечений с syzbot. В частности, разделение сигналов приоритизации и доказательства уязвимости, а также проверка reachability до класса ошибки — ключевые проектные решения harness'а для ядра.
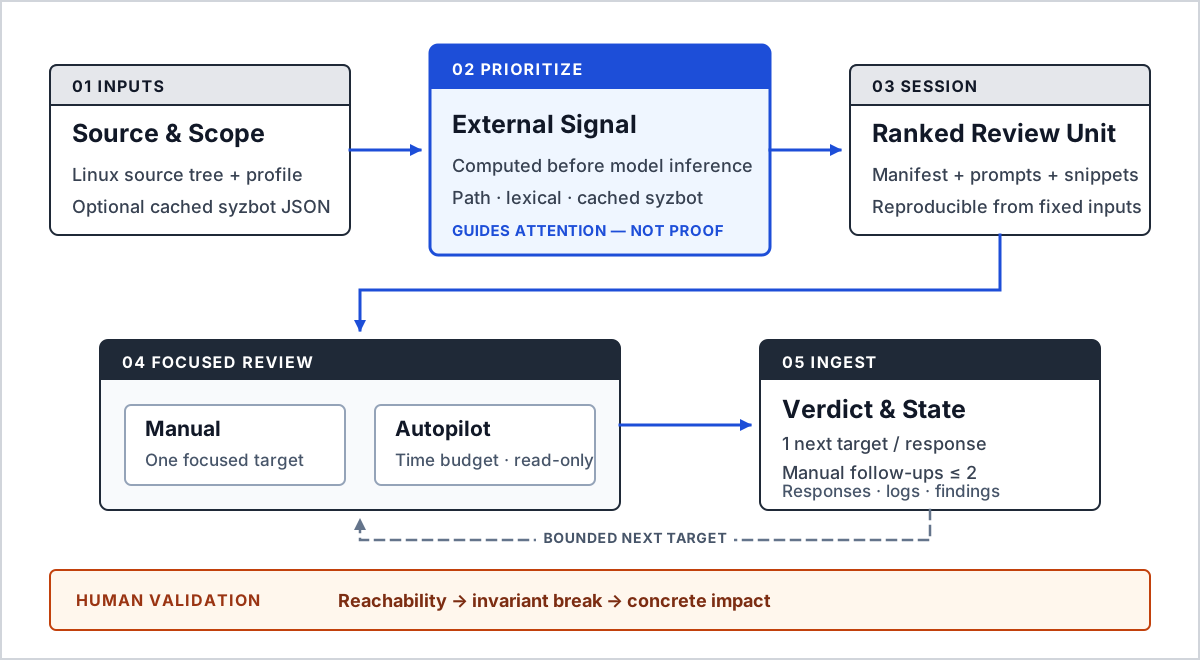
Fig. 1. The External Signal layer turns observations computed before model inference into ranked review units. It allocates attention but does not establish vulnerability proof.
TABLE I — MAJOR MODULE RESPONSIBILITIES
