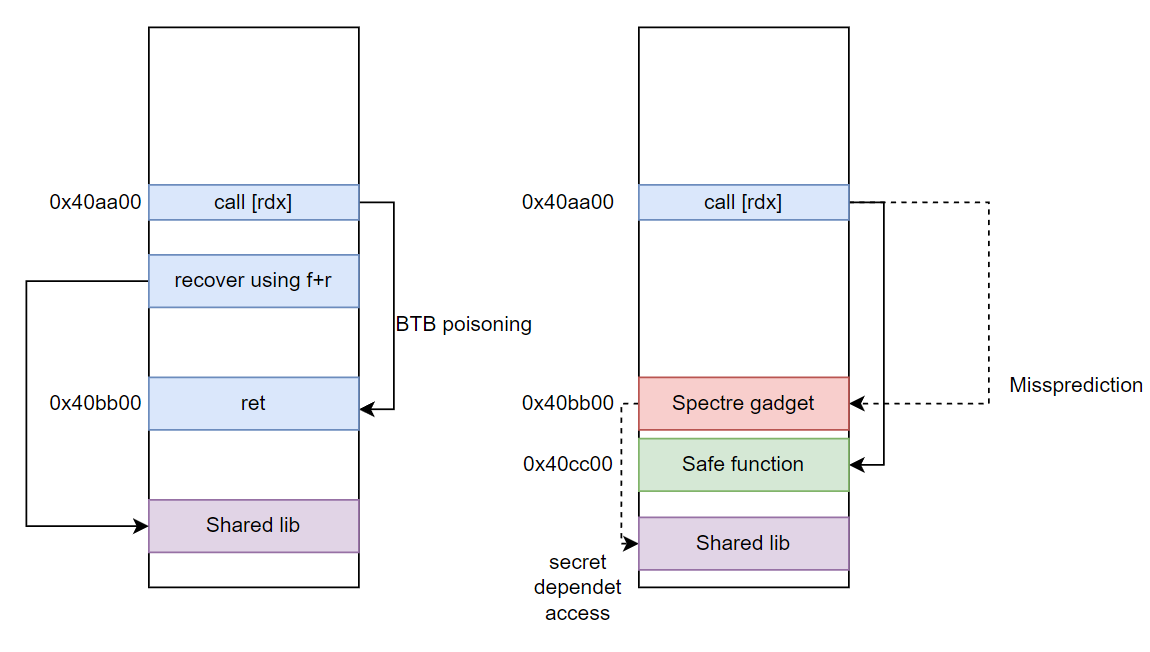
es0j/execaslr-ekoparty
Эксплойт класса proof-of-concept, который обходит ASLR на процессорах Intel, злоупотребляя буфером целевых переходов (branch target buffer) и спекулятивным выполнением для утечки рандомизированных адресов через побочный канал.

Address Space Layout Randomization (рандомизация адресного пространства) — это механизм защиты, используемый для усложнения эксплуатации уязвимостей повреждения памяти. Например, в сценарии с уязвимостью переполнения буфера атакующий, пытающийся построить эксплойт на основе Return Oriented Programming, должен знать адреса гаджетов в цепочке. Если сегмент кода эксплуатируемого бинарного файла рандомизирован, атакующему становится гораздо сложнее выбрать правильный адрес для эксплойта, что делает эксплуатацию нецелесообразной.
Следующий пример показывает, как рандомизируется адрес:
#include <stdio.h>
void DoNothing();
void (*codePtr)() = DoNothing;

void DoNothing(){}

int main(int argc,char **argv){

    printf("Destination %p\n",codePtr);
    DoNothing();
}
При каждом запуске значение рандомизируется:
Destination 0x563714256149
Destination 0x556d8e2f1149
Destination 0x5618c8bdd149
Destination 0x55ee623b0149
Последние 12 бит 149 всегда одинаковы, но расположение функции может находиться примерно где угодно в диапазоне от 0x550000000000 до 0x570000000000, что означает, что рандомизируются 29 бит, занимая возможное адресное пространство размером 0x200 0000 0000, или 2,2 ТБ.
Обработка каждой инструкции — сложная задача. Некоторые этапы обработки отдельной инструкции:
Чтобы увеличить пропускную способность процессора, каждая задача инструкции выполняется конкретным устройством (блоком) процессора. При параллельной работе всех блоков процессор может работать на гораздо более высоких тактовых частотах — в этом заключается идея конвейера.
| Операция \ такт | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| Выборка | A | B | C | ||
| Декодирование | A | B | C | ||
| Исполнение | A | B | C |
Выполнение инструкций A, B и C в течение тактов 1-5. Например, в такте 3 блоки выборки, декодирования и исполнения одновременно активны
Однако инструкции не полностью независимы друг от друга. Например, следующая последовательность:
A. add ax,[bx]
B. jz $+1
C. mov dl,[rsi]
D. nop
В этом случае инструкция A в лучшем случае завершится только на такте 3 исполнения. Однако блок выборки должен решить, какую следующую инструкцию выбирать из памяти: должна ли инструкция C (mov dl,[rsi]) быть пропущена.
В этом сценарии у процессора есть возможность дождаться завершения инструкции A, которое произойдёт только на третьем такте, чтобы затем выбрать из памяти правильную инструкцию, если, например, операция add вернёт 0:
| Операция \ такт | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Выборка | A | B | D | |||
| Декодирование | A | B | D | |||
| Исполнение | A | B | D |
Это приводит к задержке в конвейере, поскольку процессор должен ждать выполнения инструкции. В этом примере задержка составляет один такт, но инструкция add ax,[bx] требует операции с памятью, которая, как уже упоминалось, может занимать до сотен тактов, что влечёт за собой значительные потери производительности процессора.
Более быстрый вариант — попытаться «угадать» правильный путь выполнения. Процессор может спекулятивно предположить, выполнится переход или нет. После этого выполнение продолжается по предположенному пути, и значения фиксируются только в том случае, если путь оказывается правильным после завершения инструкции A. Если путь оказывается неверным, результаты отбрасываются, а состояние откатывается к моменту до точки спекуляции.
| Операция \ такт | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Выборка | A | B | (S) C | |||
| Декодирование | A | B | (S) C | |||
| Исполнение | A | B | (S) C |
Единственная проблема при откате выбранного пути заключается в том, что микроархитектурное состояние процессора не может быть откачено. Поэтому, если процессор спекулятивно выполнит инструкцию C (mov dl,[rsi]), данные, на которые указывает rsi, будут перемещены в кэш. Этот эффект впоследствии можно измерить с помощью атаки по побочному каналу.
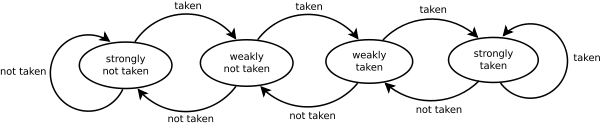
2-битный условный предсказатель переходов. https://en.wikipedia.org/wiki/Branch_predictor
Предсказываться должны не только условные инструкции, но и косвенные переходы. Процессор должен иметь механизм для угадывания адресов назначения таких инструкций, как call [rdi].
Уязвимость Spectre v2 показывает, что можно эксплуатировать предсказатель косвенных переходов для достижения транзиентного выполнения в других процессах:
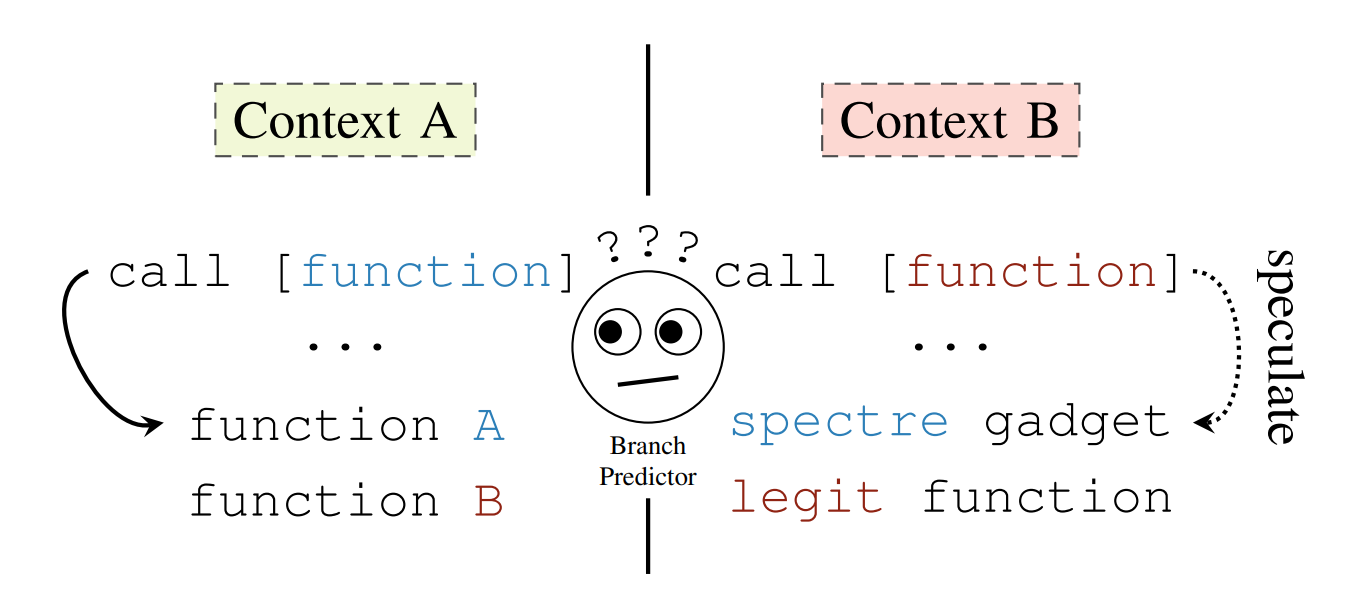 Извлечено из https://spectreattack.com/spectre.pdf
Размещая инструкцию call в контексте A по тому же виртуальному адресу, что и другую инструкцию call в контексте B, атакующий может обучить процессор выполнять код в выбранной атакующим позиции в контексте B — это атака с повторным использованием кода, аналогичная Return Oriented Programming (ROP).
Целевая жертва должна содержать фрагмент кода, известный как «spectre-гаджет», способный утечь секрет с помощью атаки по побочному каналу. Для успешной атаки Spectre атакующий также должен знать местоположение spectre-гаджета. Поэтому при атаках «пользователь-пользователь» защита жертвы с помощью ASLR ранее считалась смягчающей мерой для такого рода атак. Однако существуют также методы извлечения ASLR с помощью микроархитектурных атак, таких как Jump Over ASLR. Однако у этого метода есть ограничения по количеству утекаемых битов, поскольку он использует коллизии в предсказателе прямых переходов для обхода ASLR.
Внутренние механизмы этого предсказателя показаны ниже:
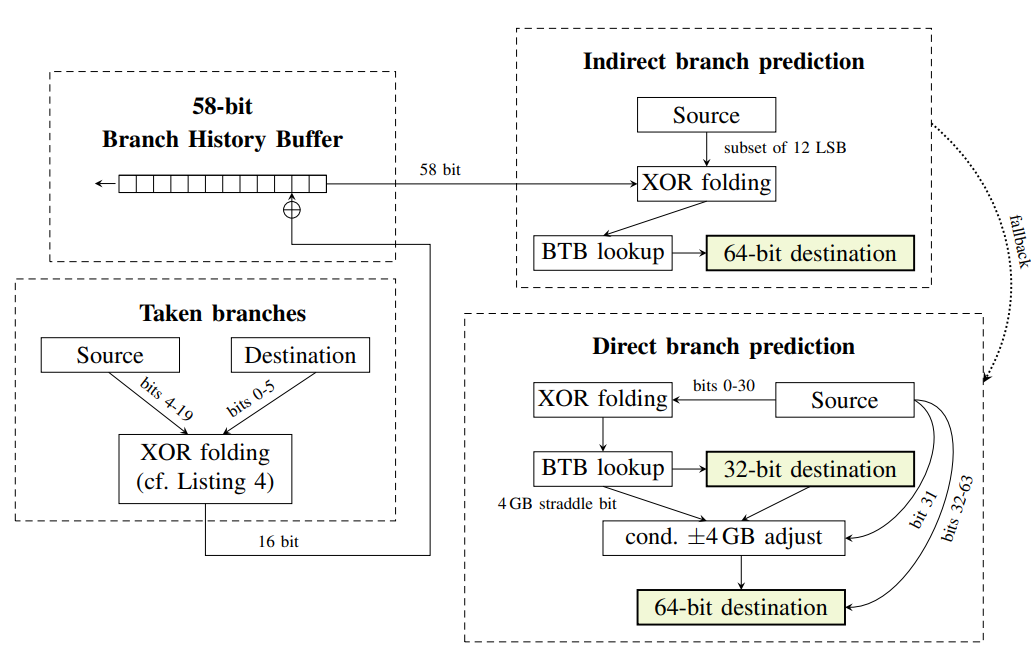
Извлечено из https://spectreattack.com/spectre.pdf
Некоторые из этих компонентов:
Классическая схема атаки Spectre v2 выглядит так: