IDE de engenharia reversa agêntica com um desassemblador multi-arquitetura em Rust puro, descompilador nativo, depurador e agente LLM para análise de binários e trabalho em CTF.
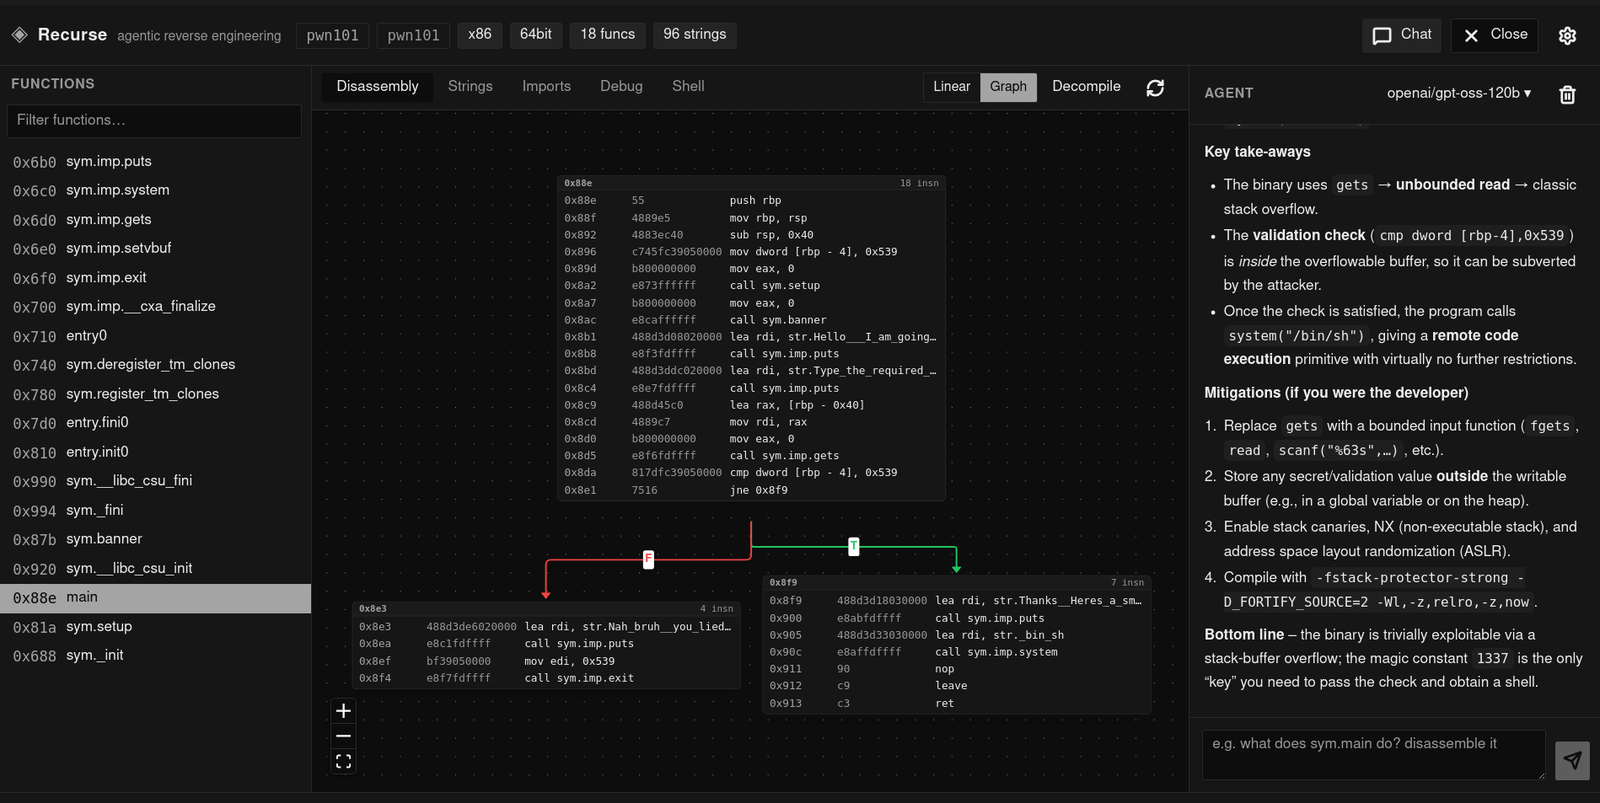
Ambiente de engenharia reversa agêntica — um aplicativo desktop da classe Ghidra no espírito de "Cursor para engenharia reversa". Construído com Tauri 2 (frontend React + TypeScript) sobre um backend de análise plugável. O padrão é um motor nativo em Rust puro — sem processo externo, sem dependência copyleft, multi-arquitetura via Capstone. Você também pode executar a análise através do r2 (radare2): instale-o, selecione-o como motor, e todo o aplicativo — ferramentas do agente e UI — o utiliza. A ferramenta do agente e a UI são agnósticas ao backend — veja docs/backends.md.
Workspace Cargo na raiz; o aplicativo desktop é um pacote dentro dele.
tauri/                   desktop app (Tauri + React)
  src/                     React frontend
  src-tauri/               Tauri Rust backend (engine sessions, agent wiring)
  package.json             app scripts (Vite, Vitest, Tauri CLI)
crates/
  recurse-agent/              agent framework: LLM loop, tool runtime, SQLite memory
  recurse-static/          static analysis: ELF/PE/Mach-O parsing, multi-arch disassembly,
                           CFG and cross-reference recovery, the engine seam
  recurse-vtil/            VTIL-inspired de-obfuscation/de-virtualization IL, lifter, optimizer
  recurse-mcp/             standalone headless MCP server (stdio) over the engine — no Tauri, no IDA
  recurse-debug/           cross-platform debugger (ptrace/Mach/Win32, breakpoints, stepping)
  recurse-eval/            headless eval harness (YAML-configured tiers)
justfile                 single entry point for both halves
recurse-agent é apenas o agente; a análise estática vive em recurse-static e o
depurador em recurse-debug, então o agente não puxa nenhum código de sistema que
não utiliza. Nenhum crate depende do Tauri, e cada um compila/testa de forma independente;
recurse-eval executa o agente de forma headless. Todos são membros do workspace, então um
Cargo.lock e um target/ cobrem todo o repositório.
Ctrl+L)checksec externo), e contagens de análise/clear e à reabertura, e alimentam a próxima sessãorecurse-agent) com rastreamento de depuração por turno; o mesmo loop do agente roda
na UI e no harness de avaliaçãolift: eleva uma função a uma IL de desobfuscação estilo VTIL e executa
passes de propagação/dobramento/eliminação de código morto/resolução de branches
em toda a rotina — útil quando o disassembly se parece com um dispatcher de VM ou
cadeia de predicados opacos (veja docs/vtil-lift.md)decompile renderiza pseudocódigo similar a C (if/while
estrutural, cobertura total de instruções) do mesmo pipeline recurse-vtil
— sem ferramenta externa, sem r2 necessáriorecurse-mcp autônomo: o mesmo Engine sobre MCP stdio para qualquer
agente compatível com MCP (Claude Code, Cursor, Claude Desktop, …) — sem Tauri, sem
licença IDA, sem ponte Python (veja docs/recurse-mcp.md)A análise passa por um único trait Engine (crates/recurse-static/src/engine.rs), então o
motor é uma escolha, não uma dependência rígida:
native (padrão) — parsing ELF/PE/Mach-O em Rust puro e disassembly multi-arquitetura
(object + capstone): x86/x86-64, ARM, AArch64, MIPS, PowerPC, RISC-V, SPARC, SystemZ,
M68K, BPF. Sem processo filho, sem ferramenta externa, sem LGPL na build. Inclui um decompilador
(pipeline lift → optimize → structure do recurse-vtil — veja
docs/vtil-lift.md) e uma operação lift para desobfuscação estilo VTIL.Escolha pelo menu de configurações, pela variável de ambiente RECURSE_BACKEND, ou pela
configuração armazenada. O agente recebe uma ferramenta analyze neutra em relação ao backend (functions, disasm, graph,
lift, decompile, xrefs, strings, imports, info, além de raw para o console do motor) —
filtrada para as operações que o motor ativo realmente suporta, então raw (o nativo não tem console) só
é anunciado quando disponível. A UI consome tipos de resultado canônicos, não o JSON de nenhum motor.
Veja docs/backends.md para o trait, as escolhas de crate e a justificativa
de licenciamento. Abrir um binário grande é rápido porque a análise é preguiçosa — a descoberta indexa
funções de forma barata e os blocos básicos só são decodificados quando uma função é visualizada; veja
docs/lazy-analysis.md.
Acoplar um servidor MCP ao IDA/Ghidra, ou colar disassembly em um agente CLI, funciona para CTFs de 5 funções e desmorona em binários reais. O Recurse é um ambiente feito sob medida, não um wrapper de chatbot:
pdF para o contexto a cada turno, sem 0x401023s inventados.npm test — a verificação é
visual. Renomeações do agente se propagam para a lista de funções, grafo e decompilação
instantaneamente, então um humano confirma ou rejeita com um clique.| Ferramenta | Versão (testada) | Instalação |
|---|---|---|
| Node.js | ≥ 20 (23.11 usada) | https://nodejs.org ou nvm |
| npm | ≥ 10 | vem com o Node.js |
| Rust | ≥ 1.77 (1.97 usada) | https://rustup.rs |
| cargo | — | vem com o Rust (rustup) |
Verifique:
node --version && npm --version && rustc --version && cargo --version
O motor native padrão é Rust puro — nada para instalar. Para usar o r2 (radare2)
como motor de análise, instale-o e selecione-o (o menu de configurações, ou
RECURSE_BACKEND=r2); o Recurse conduz o binário r2 no seu PATH. O r2 é opcional, nunca
é exigido pela build, e nunca é distribuído com o Recurse — traga sua própria instalação.
Debian/Ubuntu/Pop!_OS:
sudo apt update
sudo apt install -y libwebkit2gtk-4.1-dev build-essential \
  curl wget file libxdo-dev libssl-dev libayatana-appindicator3-dev librsvg2-dev
Outras distros: siga os pré-requisitos oficiais do Tauri.
Ambos os motores fornecem um: o native renderiza pseudocódigo via recurse-vtil
(lift → optimize → structure — veja docs/vtil-lift.md),
nada para instalar; o r2 pode fornecer seu próprio decompilador mais completo
quando seu plugin está instalado.
As dependências do aplicativo ficam em tauri/; o Rust vem da raiz do workspace. O just envolve
ambos (veja just --list), ou conduza-os diretamente.
just dev
# equivalente: cd tauri && npm install && npm run tauri dev
Isso inicia o servidor de desenvolvimento Vite e abre a janela do Tauri. A primeira compilação leva um tempo (build Rust); as seguintes são rápidas.
just build
# equivalente: cd tauri && npm run tauri build
O pacote fica em target/release/bundle/ (target do workspace):
.deb / .rpm / .AppImage para Linuxtarget/release/recurseNo Arch e outras distros rolling, a etapa do AppImage precisa de uma correção local única
(o linuxdeploy upstream está atrasado em relação ao toolchain da distro) — veja
docs/linux-appimage-build.md.
just preview
# equivalente: cd tauri && npm run build && npm run preview
just lint        # cargo clippy --workspace + eslint
just fmt         # cargo fmt --all + prettier
just fmt-check   # verifica sem escrever
just test        # cargo test --workspace + vitest
Comandos diretos equivalentes: cargo clippy --workspace --all-targets,
cargo test --workspace na raiz; npm run lint / npm run format /
npm run build dentro de tauri/.
O agente é avaliado de forma headless contra tiers de crackme (veja
crates/recurse-eval/README.md). Os tiers são YAML:
filtros de seleção sobre o dataset, ou uma lista congelada de hexids, mais parâmetros de execução.
just eval-fetch   # baixa os binários do tier
just eval-test    # autotestes do harness (sem chave de API, sem chamadas LLM)
just eval-run     # executa o tier — a única forma de executar um YAML de avaliação
eval-run é um binário, não um teste, então cargo test nunca gasta dinheiro ou tempo com
o agente. Endpoint + chave vão em crates/recurse-eval/.env (copie .env.example).
Cada execução escreve target/eval-traces/<tier>/<backend>/run.log (a narrativa completa)
mais um <hexid>.json por tarefa com a conversa completa por turno. O
backend (native ou r2) é selecionável por execução — veja o README de avaliação.
O painel de chat do agente roda em qualquer endpoint compatível com OpenAI. Configure a chave de API,
URL base e modelo no diálogo Model & Provider do aplicativo (persistido em
~/.recurse/recurse.db), ou via env:
# Provedor hospedado (padrão)
export RECURSE_LLM_API_KEY=sk-or-...   # ou OPENROUTER_API_KEY
export RECURSE_LLM_ENDPOINT=https://openrouter.ai/api/v1/chat/completions  # opcional
export RECURSE_LLM_MODEL=openrouter/auto  # opcional
Aponte o agente para qualquer servidor compatível com OpenAI local ou auto-hospedado — Ollama, LM
Studio, llama-server do llama.cpp, vLLM, text-generation-webui, ou um gateway remoto.
Defina a Base URL no diálogo (uma URL base simples ou uma rota completa /chat/completions
funcionam) e escolha um modelo do catálogo desse servidor, ou digite um id de modelo
(llama3.1:8b, qwen2.5-coder, …) diretamente:
export RECURSE_LLM_ENDPOINT=http://localhost:11434/v1   # Ollama
export RECURSE_LLM_MODEL=llama3.1:8b
export RECURSE_LLM_API_KEY=           # geralmente desnecessário localmente
Endpoints locais não precisam de chave de API: quando a chave está em branco, a requisição é enviada sem
cabeçalho Authorization, e a lista de modelos é lida do próprio {base}/models do endpoint.
Um endpoint personalizado é tratado como configurado sem chave, então o
chat funciona imediatamente contra um servidor local.
Sem credenciais, ele recorre a um cliente echo para que a integração permaneça exercitável.
O agente vê o contexto ao vivo do binário (arch, bits, tipo) e pode conduzir toda a superfície de análise (disassembly, xrefs, strings, imports, decompilação) através da sessão.
Apache-2.0 — © 2026 Aayush Khanna



