 praetorian-inc/noseyparker
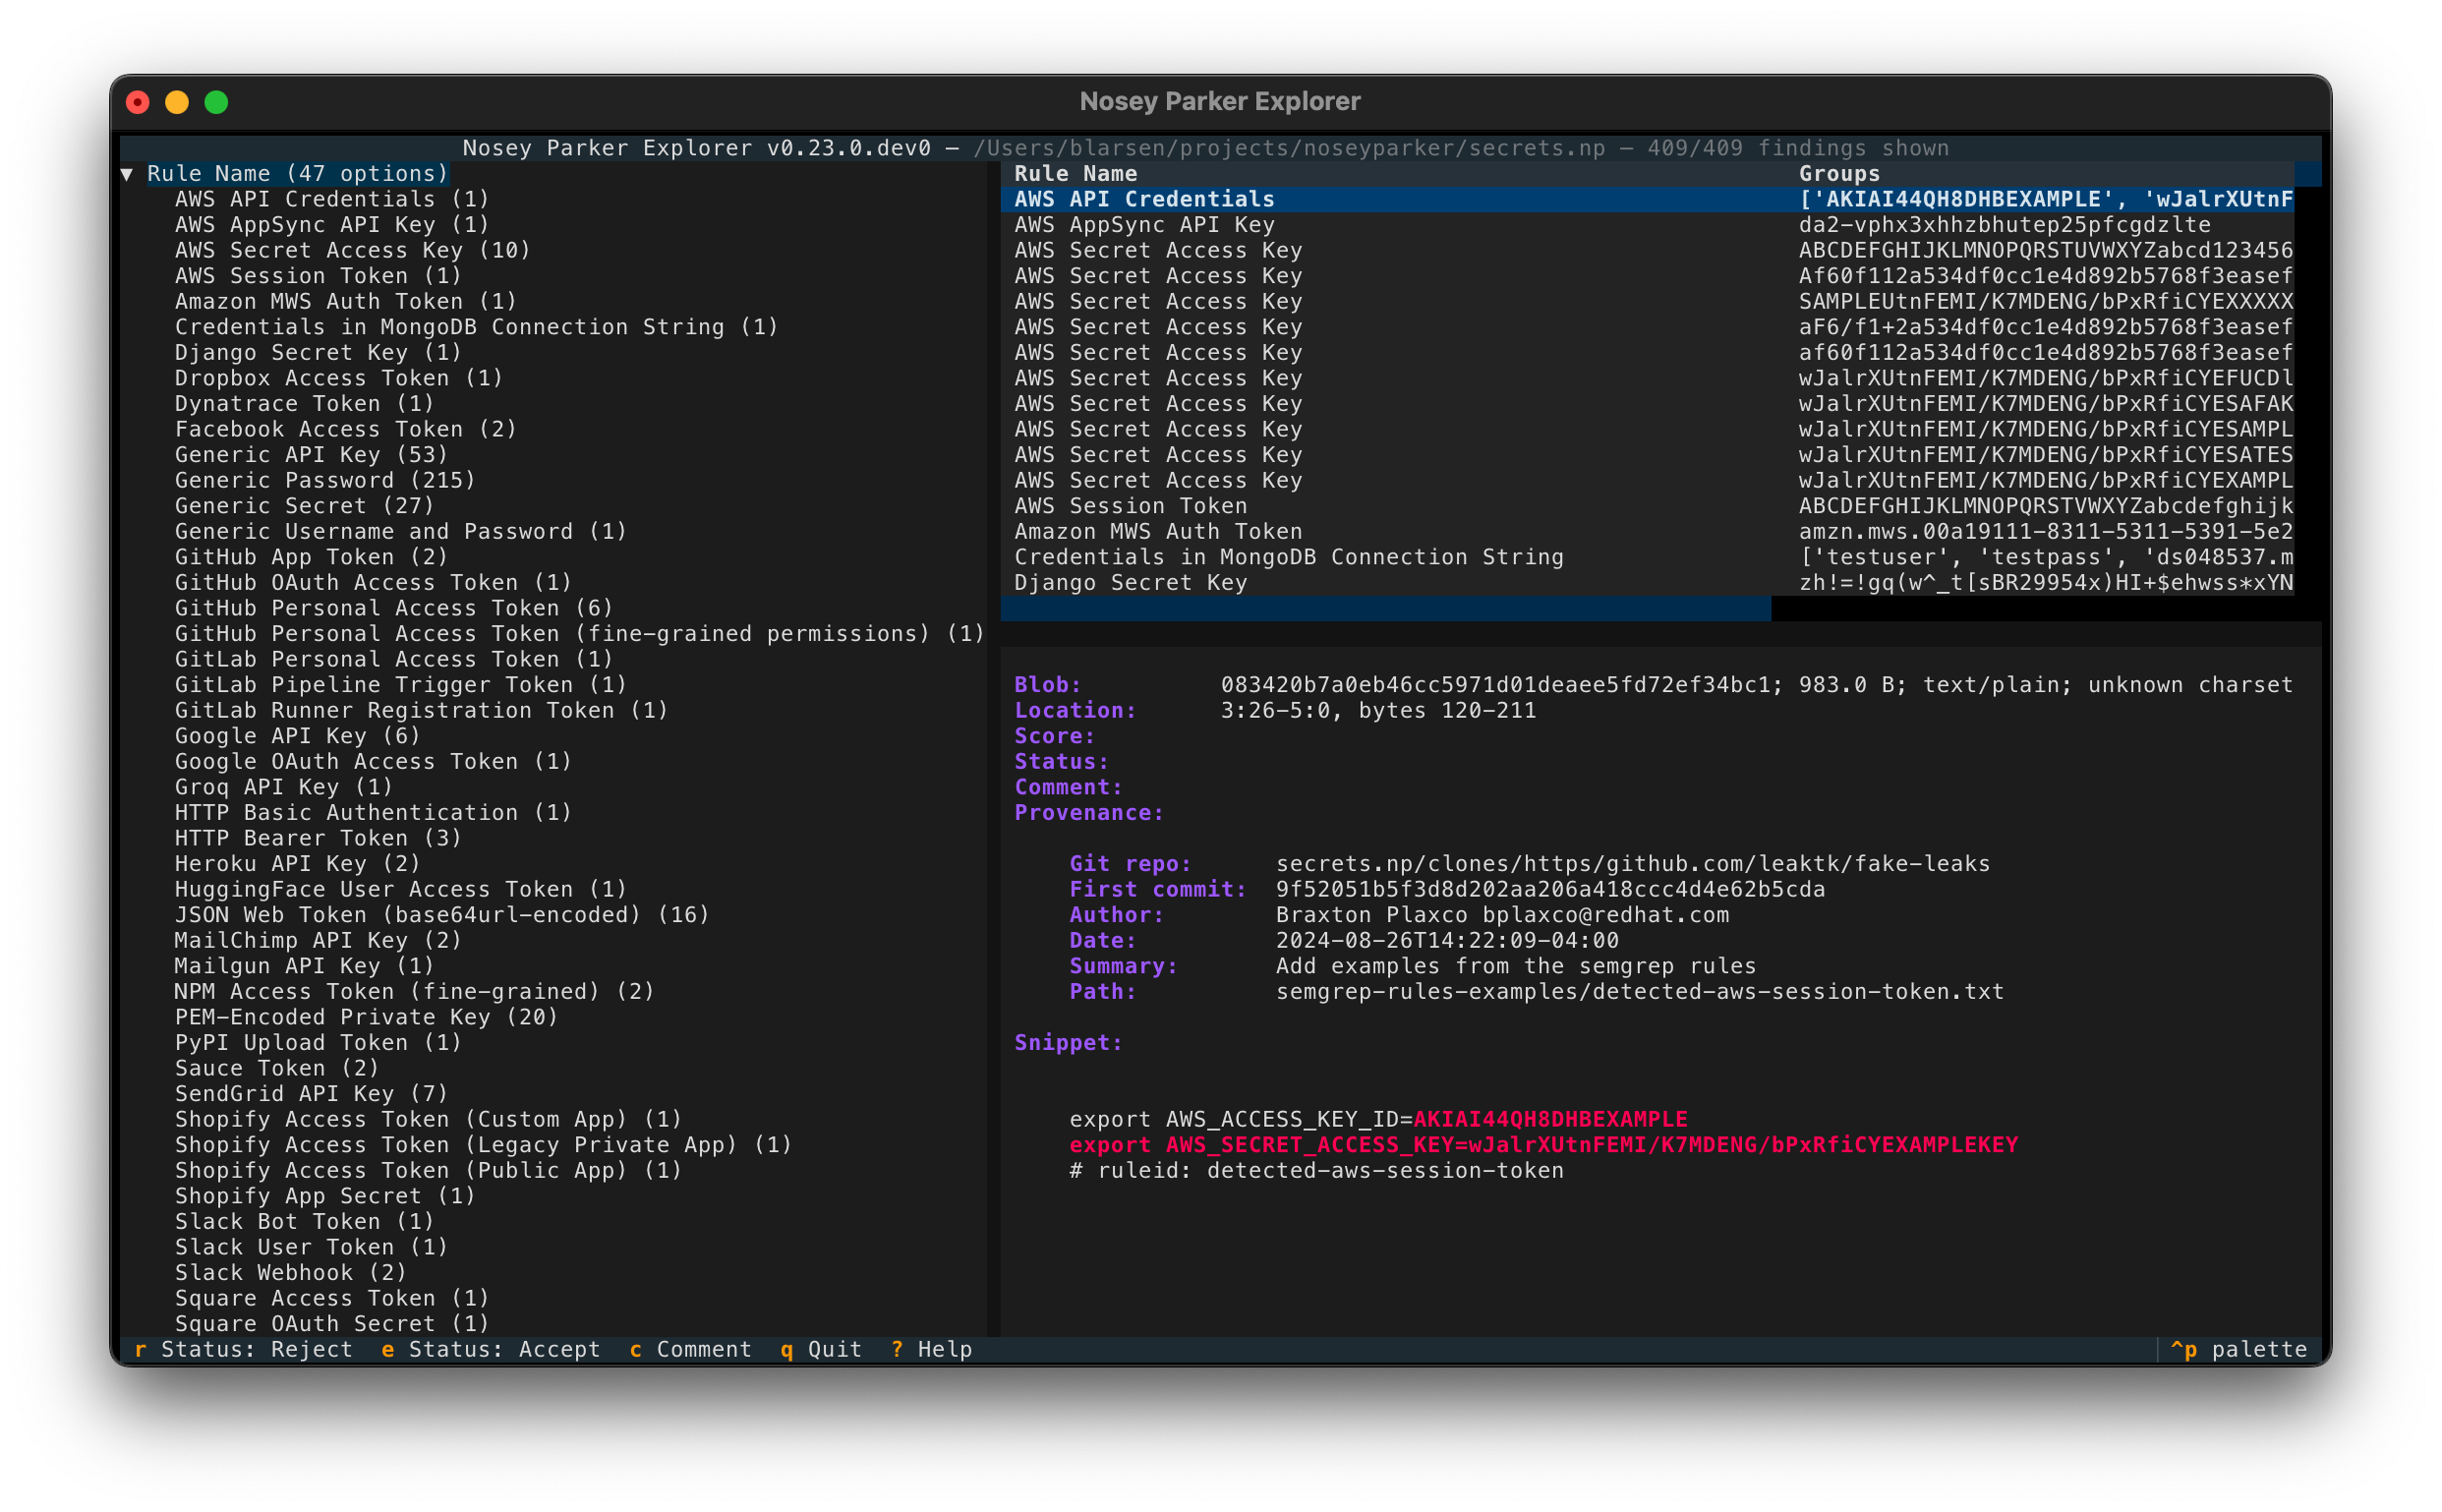
Nosey Parker é uma ferramenta de linha de comando que encontra segredos e informações sensíveis em dados textuais e histórico do Git.

Veja nossa postagem de anúncio https://www.praetorian.com/blog/titus-open-source-secret-scanner/. O repositório Titus pode ser encontrado em https://github.com/praetorian-inc/titus
Nosey Parker é uma ferramenta CLI que encontra segredos e informações sensíveis em dados textuais.
É essencialmente uma ferramenta especializada do tipo grep para detecção de segredos.
Foi projetada para segurança ofensiva (por exemplo, possibilitando movimento lateral em red teams), mas também pode ser útil para testes de segurança defensiva. Ela encontrou segredos em centenas de engajamentos de segurança ofensiva na Praetorian.
Principais funcionalidades:
O fluxo de trabalho típico é de três fases:
scanreportbrew install noseyparker
A página da última versão contém binários pré-compilados para Linux e macOS x86_64/aarch64.
docker pull ghcr.io/praetorian-inc/noseyparker:latest
O commit mais recente também está disponível através da tag main.
docker pull ghcr.io/praetorian-inc/noseyparker-alpine:latest
O commit mais recente também está disponível através da tag main.
https://aur.archlinux.org/packages/noseyparker
Nosey Parker não compila nativamente no Windows (#121). É possível executá-lo no Windows usando WSL1 e a versão nativa do Linux.
Isso foi testado com várias versões do Ubuntu Linux e macOS em ambas as arquiteturas x86_64 e aarch64.
Dependências necessárias:
cargo: abordagem recomendada: instale de https://rustup.rscmake: necessário para compilar a crate vectorscan-sys e algumas outras dependênciasboost: necessário para compilar a crate vectorscan-sys (versão suportada >=1.57)git: necessário para incorporar informações de versão na CLI noseyparkerpatch: necessário para compilar a crate vectorscan-syspkg-config: necessário para compilar a crate vectorscan-syssha256sum: necessário para calcular digests (frequentemente fornecido pelo pacote coreutils)zsh: necessário para scripts de compilaçãocreate-release.zsh$ rm -rf release && ./scripts/create-release.zsh
Se for bem-sucedido, isso produzirá uma estrutura de diretórios em release preenchida com artefatos de lançamento.
O programa de linha de comando estará em release/bin/noseyparker.
Executar o binário noseyparker sem argumentos imprime a ajuda de alto nível e sai.
Você pode obter ajuda abreviada para um comando específico executando noseyparker COMANDO -h.
Ajuda mais detalhada está disponível com o comando help ou a opção longa --help.
As versões pré-compiladas também incluem páginas de manual que reúnem a ajuda da linha de comando em um só lugar. Essas páginas de manual convertidas para o formato Markdown também estão incluídas no repositório aqui.
Se você tiver uma pergunta que não seja respondida por esta documentação, por favor inicie uma discussão.
O datastore é um diretório especial que o Nosey Parker usa para registrar suas descobertas e manter seu estado interno.
Um datastore será criado implicitamente pelo comando scan se necessário.
Cada entrada escaneada é chamada de blob. Cada blob tem um ID único, que é um digest SHA-1 calculado da mesma forma que o git faz.
Cada blob possui uma ou mais entradas de proveniência associadas a ele. Uma entrada de proveniência são metadados que descrevem como a entrada foi descoberta, como um arquivo no sistema de arquivos ou um arquivo no histórico do repositório Git.
Nosey Parker é um sistema baseado em regras que usa expressões regulares.
Cada regra possui um único padrão com pelo menos um grupo de captura que isola o conteúdo da correspondência do contexto ao redor.
Você pode listar as regras disponíveis com noseyparker rules list.
Uma coleção de regras é organizada em um conjunto de regras.
O conjunto de regras padrão do Nosey Parker inclui regras que detectam coisas que parecem ser segredos.
Outros conjuntos de regras estão disponíveis; você pode listá-los com noseyparker rules list.
Quando o padrão de uma regra corresponde a uma entrada, ele produz uma correspondência. Uma correspondência é definida exclusivamente por uma regra, ID do blob, deslocamento inicial em bytes e deslocamento final em bytes; esses campos são usados para calcular um identificador único de correspondência.
Correspondências que compartilham uma regra e grupos de captura são combinadas em uma descoberta. Em outras palavras, uma descoberta é um grupo de correspondências. Esta é a unidade de alto nível de relatório do Nosey Parker.
Ao usar a imagem Docker, substitua noseyparker nos comandos a seguir por uma invocação Docker que use um volume montado:
docker run -v "$PWD":/scan ghcr.io/praetorian-inc/noseyparker:latest <ARGS>
O contêiner Docker é executado com /scan como seu diretório de trabalho, então montar $PWD em /scan no contêiner fará com que a conclusão por tabulação e caminhos relativos em sua invocação de linha de comando funcionem.
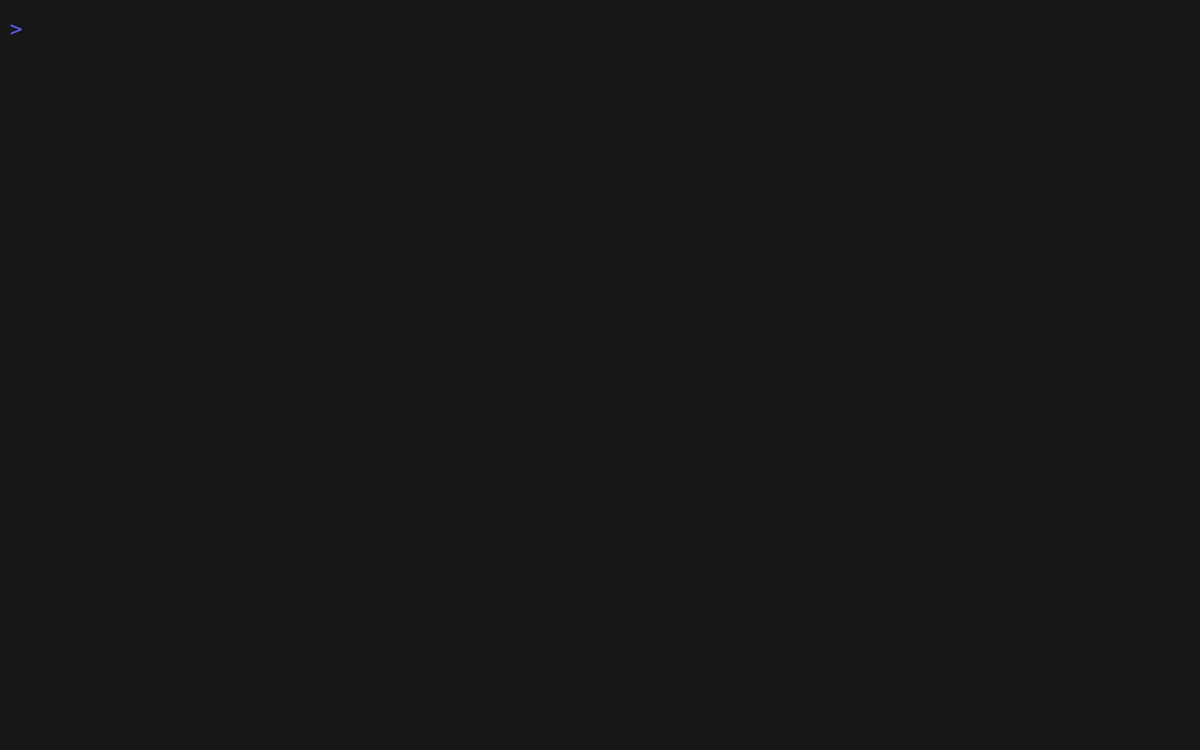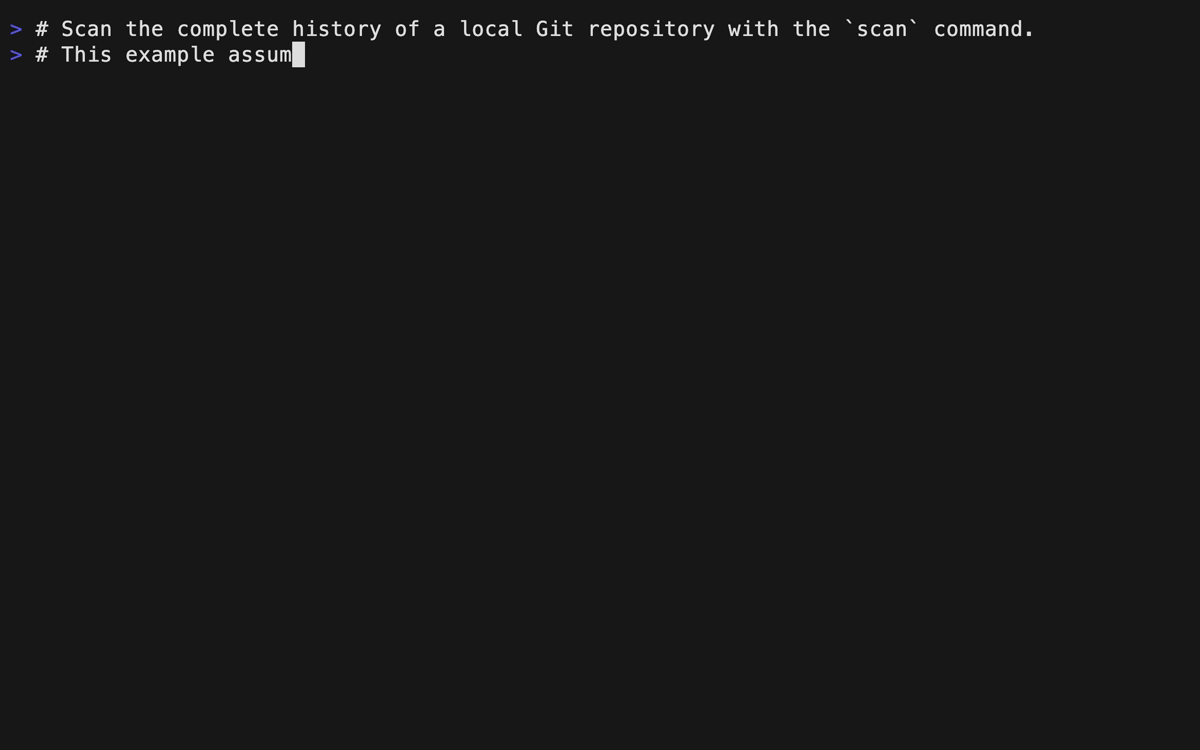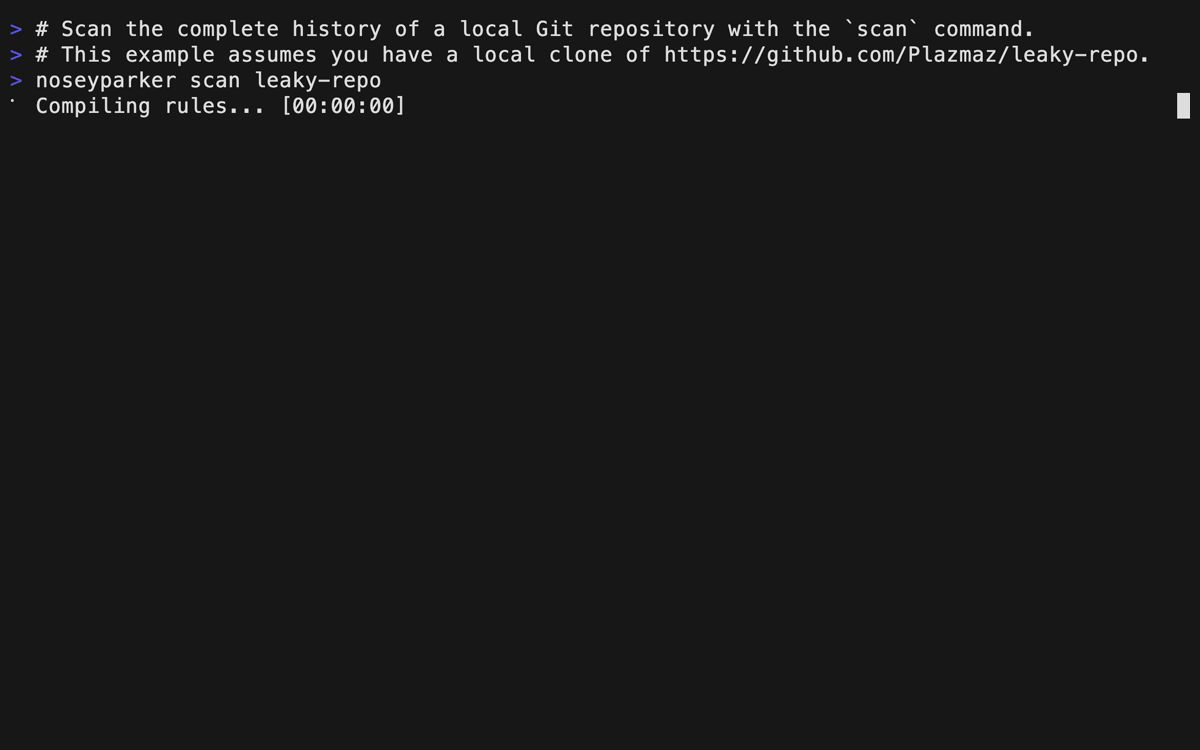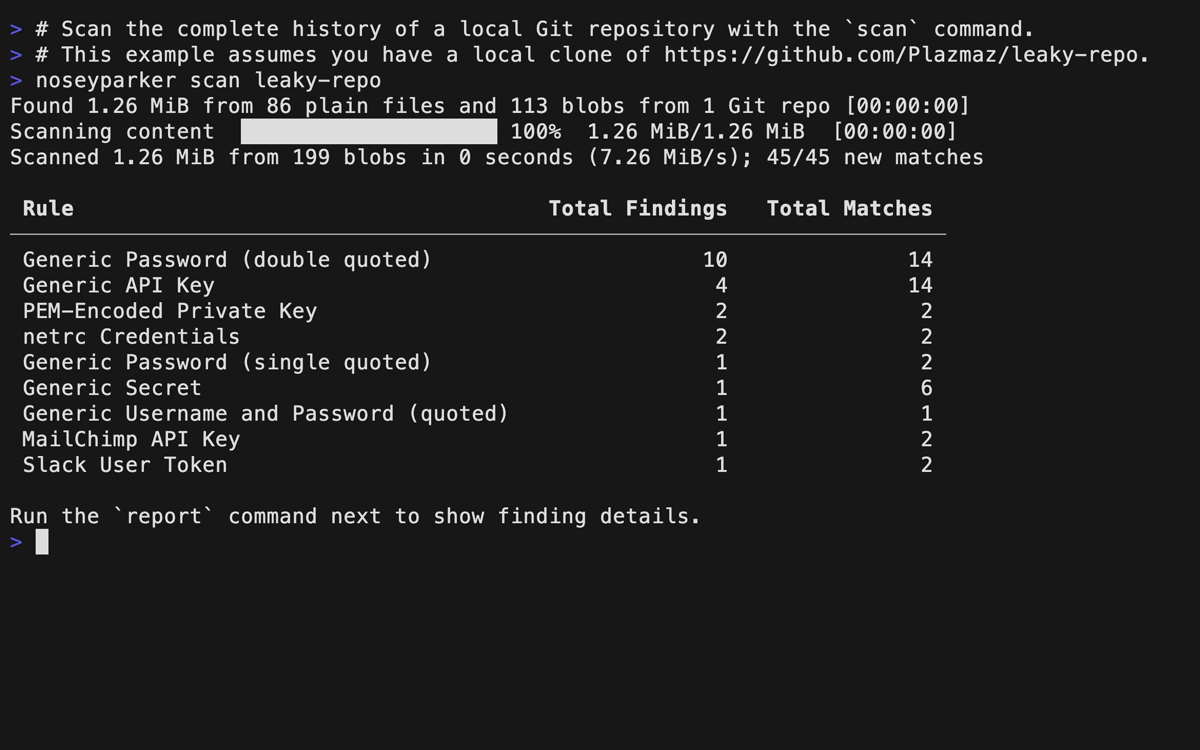
Nosey Parker possui suporte nativo para escanear arquivos, diretórios e todo o histórico de repositórios Git.
Por exemplo, se você tiver um clone Git do CPython localmente em cpython.git, pode escaneá-lo com o comando scan.
Nosey Parker criará um novo datastore em cpython.np e salvará suas descobertas lá.
(O nome cpython.np é irrelevante e pode ser o que você quiser.)
$ noseyparker scan -d cpython.np cpython.git
Scanned 19.19 GiB from 335,849 blobs in 17 seconds (1.11 GiB/s); 2,178/2,178 new matches
