confusable-vision
O primeiro conjunto de dados de confusáveis fonte por fonte do mundo. Quais caracteres Unicode se parecem com quais, medidos a partir dos contornos das fontes em vez de pixels. A versão atual, 2026.09.26, compara cada letra e dígito que cada uma das 322 fontes desenha, no tamanho e posição de linha de base que cada glifo tem em texto corrido. Os sósias de letras e dígitos ASCII são então verificados no lugar: colocados entre outras letras em fontes comuns no tamanho em que as pessoas as leem, e comparados com pares que todos aceitam como semelhantes, como 0 e O.
addons.mozilla.org usa caracteres do confusable-vision para verificar nomes de complementos em busca de sósias, creditado no código-fonte da Mozilla; veja Usado por.
Usado por
- Mozilla addons-server, o código por trás de addons.mozilla.org, adiciona caracteres da saída do confusable-vision à tabela que usa para reduzir sósias a ASCII ao verificar nomes de complementos:
src/olympia/amo/confusables.py, pull requests #24468, #24541, #24612 e #24665 (fevereiro a março de 2026).
- disarm (raeq/disarm), que canoniza Unicode adversarial antes que ele chegue a classificadores, índices e identificadores, adiciona pares medidos do confusable-vision às suas tabelas de confusáveis:
data/confusables_supplement.tsv, data/confusables_vision.tsv.
- SilverSpeak (ACMCMC/silverspeak), uma biblioteca Python para realizar e neutralizar ataques de homoglifos em texto, constrói os vizinhos visuais em seu grafo de homoglifos a partir dos arquivos de descoberta do confusable-vision (
docs/hkb.md).
- namespace-guard distribui os pares medidos, e através dele eles chegam ao agent-sanitizer, que usa o namespace-guard como seu motor padrão para reduzir caracteres sósias na entrada de chamadas de ferramentas de um agente de IA a ASCII (deps.dev).
Esses projetos obtiveram seus dados das saídas do confusable-vision de fevereiro e março de 2026.
Discutido no Hacker News: I rendered 1,418 confusables over 230 fonts e Confusables.txt and NFKC disagree on 31 characters.
Versão 2026.09.26 em números:
- 322 fontes: todas as fontes do macOS, incluindo as que ele baixa sob demanda, como PingFang, mais Roboto, Noto Sans, Noto Serif, Noto Sans CJK e DejaVu. 64.751 pontos de código em 140 scripts.
- 11.517 pares semelhantes em pelo menos uma fonte ou combinação de fontes, dos quais 5.975 passam nos limites sugeridos.
- 719 pares de um caractere e uma sequência ASCII de duas letras, como ǁ e ll, ou Ы e bl.
- 3.055 sósias candidatos de letras, dígitos e sequências ASCII verificados no lugar: 646 semelhantes no nível estrito, 358 mais no nível amplo, 101 mais que correspondem ao desenho da letra em outra fonte comum. 224 dos estritos não estão no confusables.txt do Unicode.
Os dados são publicados como uma versão versionada em data/release/2026.09.26/ (CC-BY-4.0). namespace-guard e d0ma1n são construídos sobre ela.
O que mudou desde a versão 2
A versão 2 (2026.09.24, e 2026.09.25 para os dados de TLD) comparava apenas os pares e fontes que execuções anteriores haviam comparado. Uma auditoria de glifos idênticos descobriu que ela capturou 637 dos 2.654 casos em que uma fonte desenha dois caracteres com o mesmo glifo. A versão 3 corrige isso e adiciona três coisas:
- Cobertura. Cada letra e dígito que cada fonte desenha é comparado com todos os outros naquela fonte, incluindo Han e Hangul. A versão 2 tomava seus caracteres de uma lista fixa, então nunca alcançou a maior parte de Yi, Aboriginal Canadense, Etíope ou dos scripts indianos, e perdeu as fontes exclusivas de script e o PingFang.
- As faces corretas. Coleções de fontes são carregadas na face que um navegador usa para texto corrido. Execuções anteriores tomavam a primeira face, que para algumas coleções era negrito, black ou itálico.
- Contornos sobrepostos, como em fontes variáveis como San Francisco, são medidos como a união de seus traços, como um leitor os vê.
- Sequências de duas letras. Cada sequência de duas letras ou dígitos ASCII (3.844) é composta como cada fonte a compõe, com seu kerning e ligaduras, e comparada como um caractere.
- O limite entre fontes é definido pelo quartil superior das fontes de página, então adicionar fontes à pesquisa não pode movê-lo.
- A verificação no lugar (abaixo).
Os números de março de 2026 (249.976 pares de caractere único e 2.524.275 pares de bigramas em 245 fontes) vieram de medições que ignoravam tamanho e linha de base. Eles estão superados; os arquivos dessas execuções permanecem em data/output/ para referência.
Como funciona
Medindo glifos
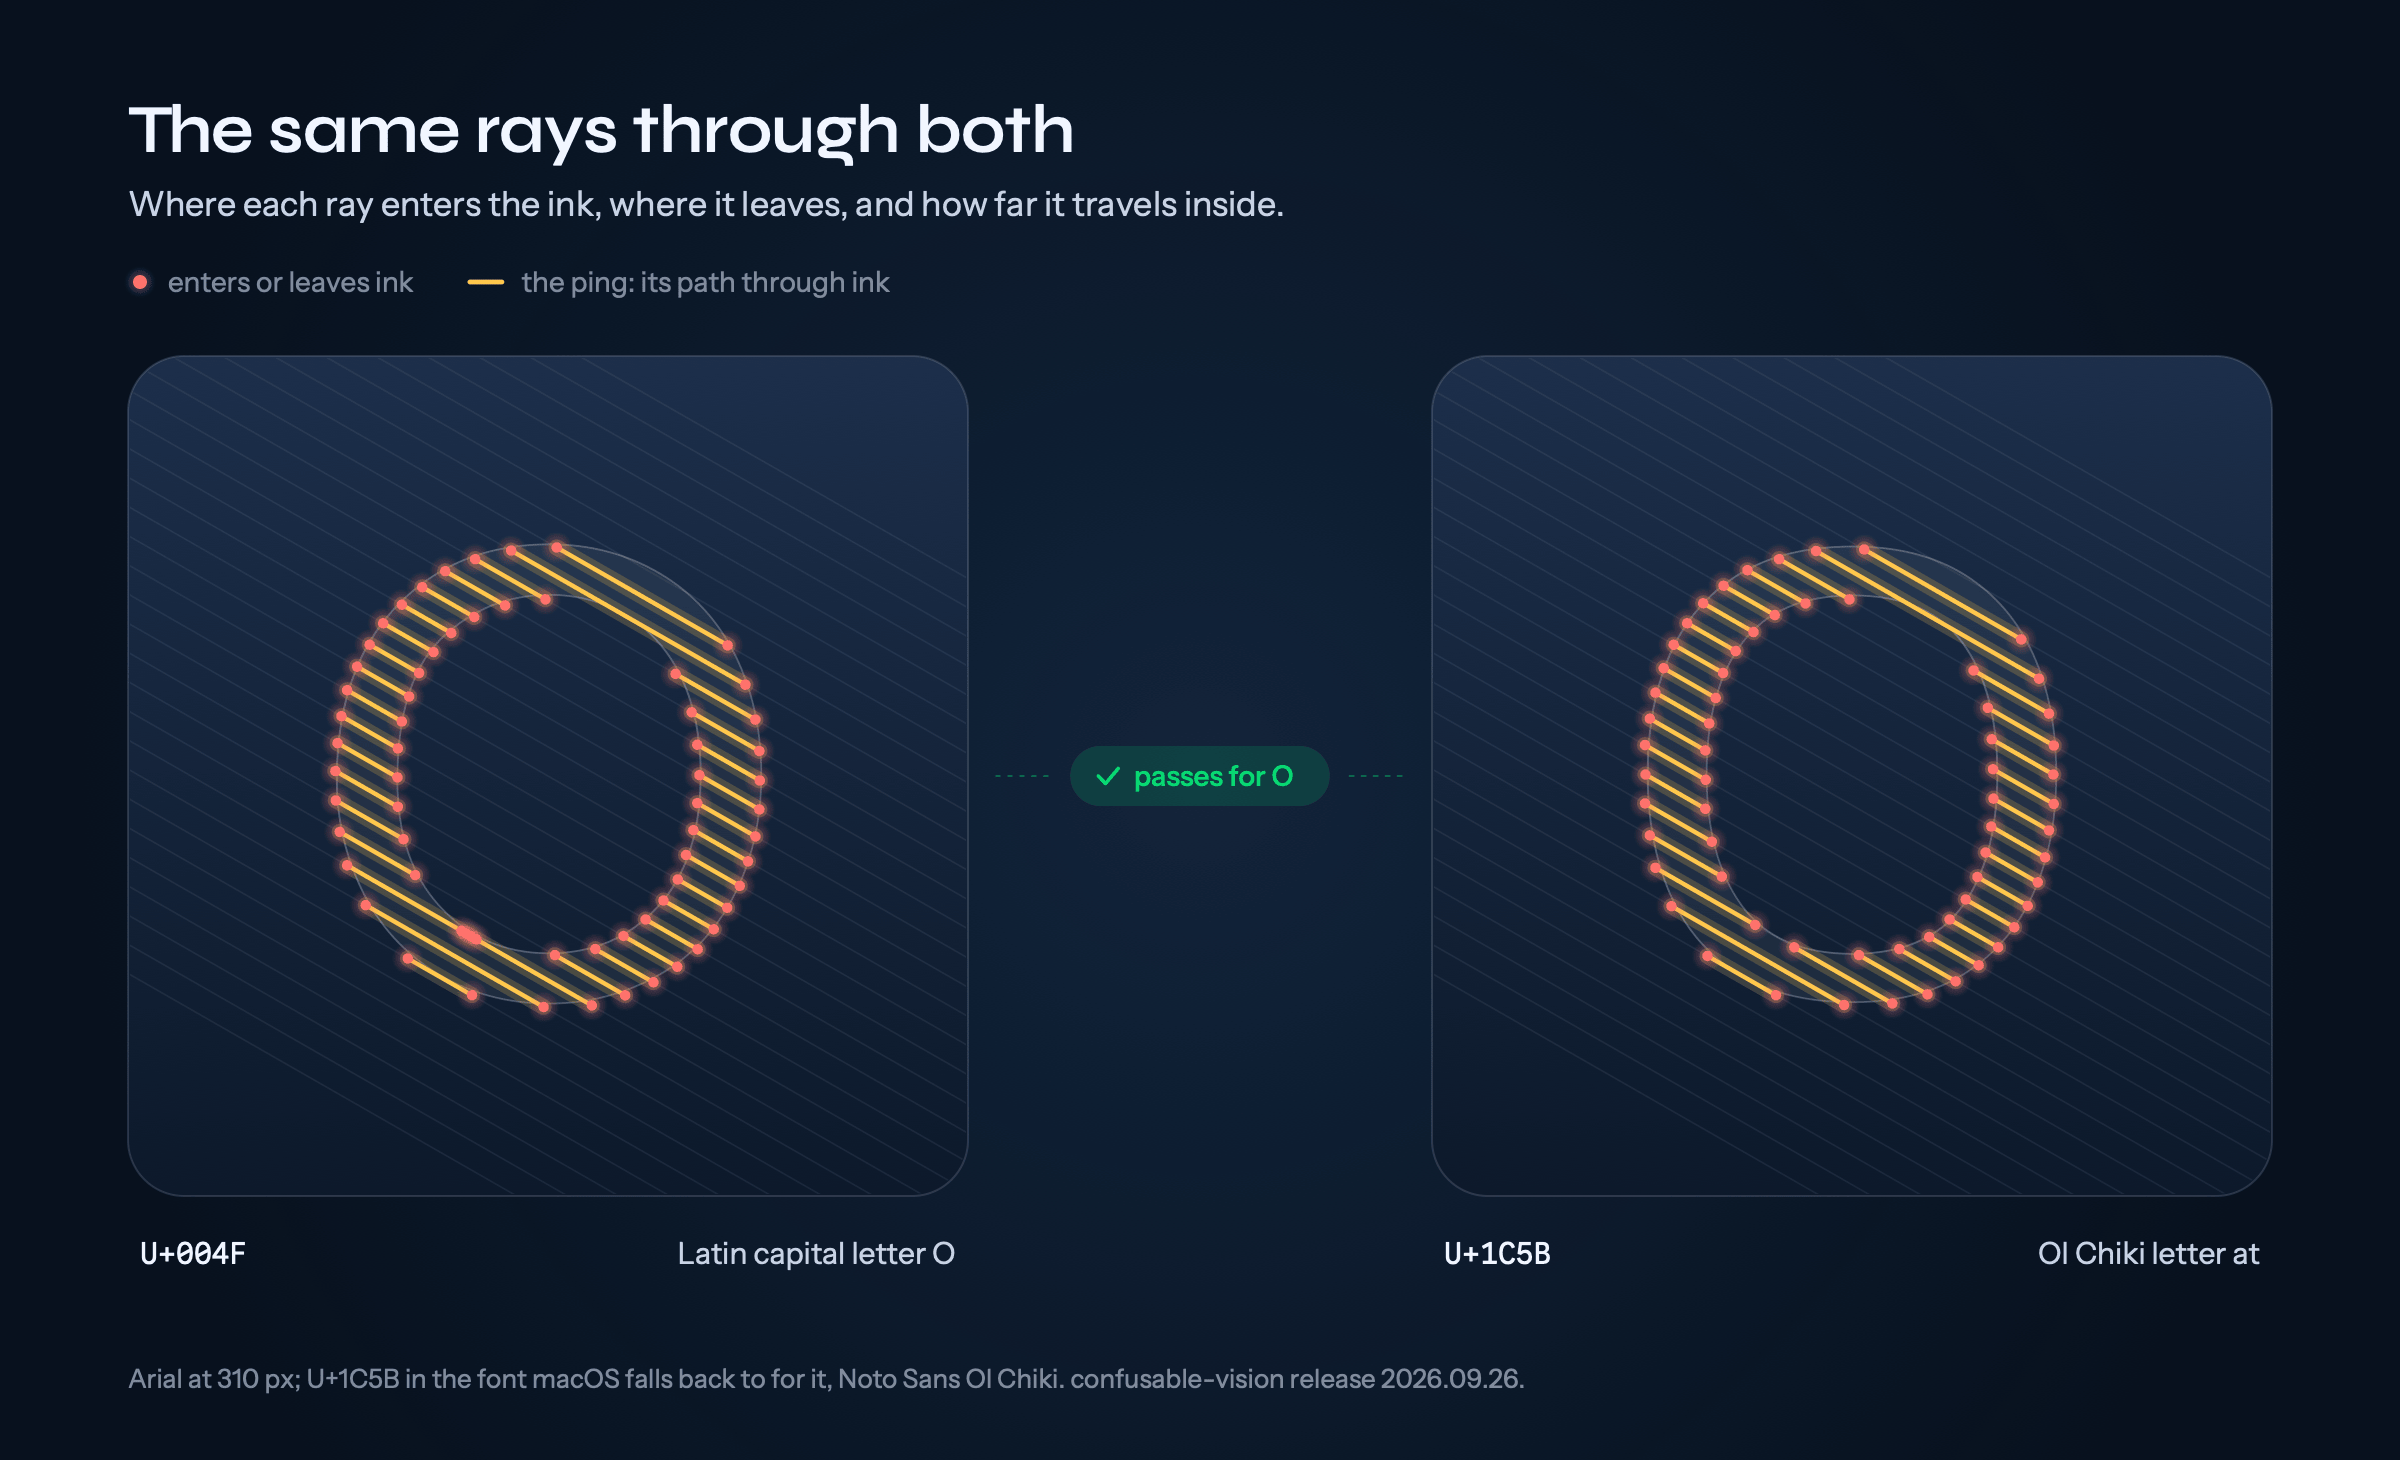
RaySpace lança raios paralelos através do contorno de cada glifo em 36 ângulos, 50 raios cada, e registra cinco coisas por raio: quantas vezes ele cruza o contorno, onde, em que ângulo, quão longe ele viaja através da tinta a cada vez (seu ping, a largura do traço ao longo do raio), e a maior lacuna entre traços. Cada glifo é medido duas vezes: em sua própria caixa, para forma, e em um quadro fixo na linha de base, para que tamanho e posição contem. Dois caracteres são semelhantes em uma fonte quando a distância de forma está abaixo de 0,5 e a distância ancorada na linha de base abaixo de 0,2. A comparação roda em Rust (native/cv-pairs), em todos os núcleos.
- Dentro de uma fonte: cada par de letras e dígitos que a fonte desenha.
- Entre fontes: um caractere em sua própria fonte, como o fallback de um navegador o desenharia, contra as 62 letras e dígitos ASCII de cada uma das 26 fontes de página que não o possuem. Conta quando a letra ASCII é a mais próxima, e o caractere está tão próximo dela quanto essa letra está de si mesma no quartil superior das outras fontes de página.
- Sequências: cada caractere contra as 3.844 sequências ASCII de dois caracteres, como cada fonte as compõe (Core Text; HarfBuzz as compõe de forma idêntica, exceto pelo tracking da fonte do sistema).
Verificando no lugar