
 jev-sec/jev-ids
Sistema de Detecção de Intrusão (IDS) ultrarrápido e com uso eficiente de tokens, baseado no Jev da TypeSafe.


Detecção de intrusão em uma requisição. Mostre ao Jev da TypeSafe um fluxo de rede e cinco exemplos rotulados. Ele responde se o fluxo é um ataque e de que tipo, em meio segundo, sem texto para interpretar.
O Jev IDS foi testado no NSL-KDD, um benchmark de referência da comunidade de segurança cibernética, contra um LLM de última geração (Gemini 3.6 Flash no Vertex AI), um modelo clássico de aprendizado de máquina (Random Forest) e um não supervisionado (Isolation Forest): 2.000 fluxos, três sementes, k de 0 a 8 exemplos por categoria. Dados os mesmos cinco exemplos (k = 1), o Jev IDS foi:
O LLM é o melhor detector em F1: 0,880 contra 0,856 do Jev em k = 1, e à frente em todo k (McNemar p < 0,001), porque captura mais ataques dos tipos mostrados nos exemplos. O Jev é o segundo melhor e, em ataques zero-day, tipos ausentes dos exemplos, captura mais que o LLM de k = 1 a k = 8 (0,747 contra 0,713 em k = 1). Os números, as figuras e seus limites estão em Evidências e limites e docs/results.md.
Leia o loop · O template da requisição · Glossário
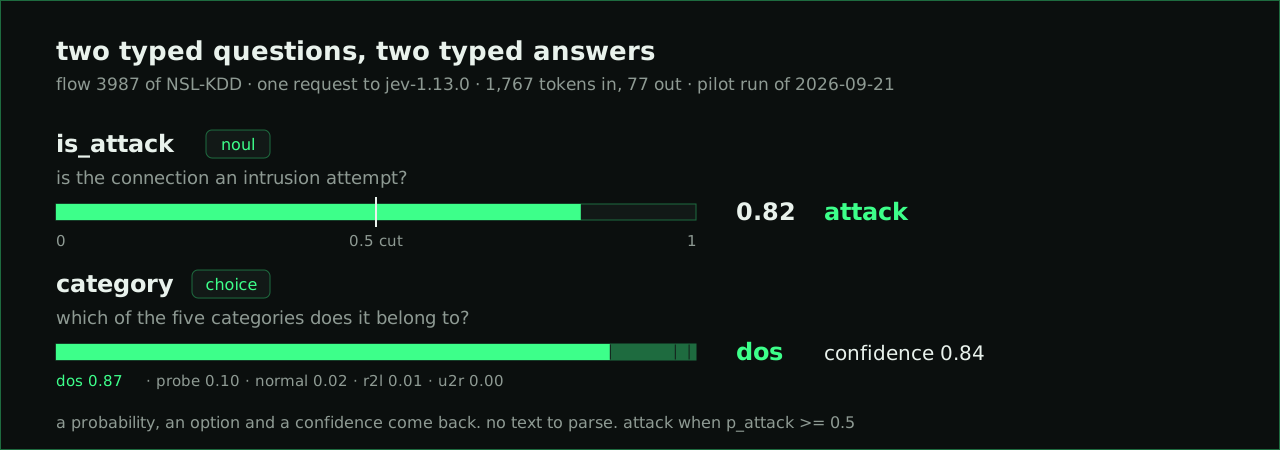
O Jev é um System One Model. Em vez de escrever texto, ele lê um state e responde a perguntas tipadas sobre ele com probabilidades. O Jev IDS coloca um fluxo no state, ao lado das instruções, dos nomes das colunas, das cinco descrições de categoria e dos exemplos rotulados, e faz duas perguntas. is_attack retorna como uma probabilidade. category retorna como uma das cinco opções com uma confiança. O veredito é ataque quando a probabilidade atinge 0,5.
Toda requisição segue o mesmo caminho:
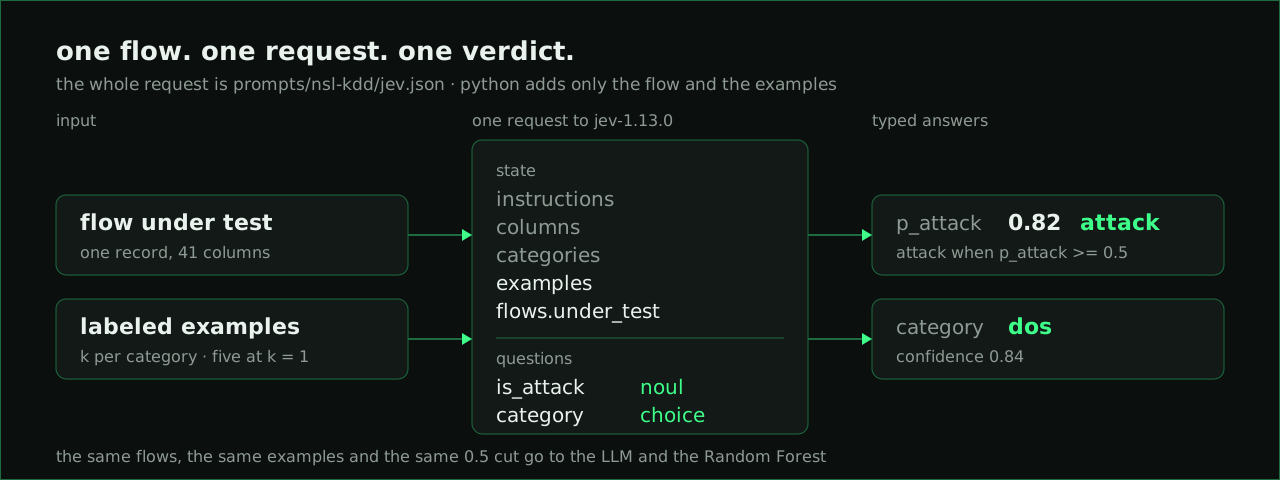
A requisição inteira é um arquivo, prompts/nsl-kdd/jev.json. O Python adiciona apenas o fluxo e os exemplos, e o sha256 do arquivo viaja em cada linha de predição como prompt_hash, então execuções que pediram coisas diferentes nunca são comparadas como iguais. Os exemplos são rotulados apenas por categoria: nomes de ataques como neptune nunca chegam a um modelo.
Os mesmos fluxos, exemplos e corte de 0,5 vão para duas baselines: um LLM através de um agente Agno com um schema de saída JSON (Gemini 3.6 Flash via Vertex AI no artigo; GPT-5.6 via backend do ChatGPT Codex ou DeepSeek como alternativas) e uma Random Forest do scikit-learn treinada nos mesmos exemplos. Uma terceira baseline, um Isolation Forest ajustado apenas nos fluxos benignos do pool, nunca vê um exemplo: é a referência não supervisionada, apenas em k = all.
git clone https://github.com/jev-sec/jev-ids.git
cd jev-ids
uv sync
# .env: TYPESAFE_API_KEY for Jev. Gemini needs `gcloud auth application-default login` and GOOGLE_GENAI_USE_VERTEXAI=true,
# GOOGLE_CLOUD_PROJECT and GOOGLE_CLOUD_LOCATION=global in the environment; DEEPSEEK_API_KEY and CHATGPT_CLIENT_ID only for the other LLMs.
Baixe o NSL-KDD em data/raw/nsl-kdd/ e prepare-o uma vez:
uv run python -m scripts.prepare_nsl_kdd
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split smoke --k 0,1
O split smoke tem cinco fluxos. A execução grava results/<timestamp>-nsl-kdd-jev-smoke/ com config.json, uma linha JSON por fluxo em predictions.jsonl (o veredito, a verdade, p_attack, a categoria, a confiança, a latência e o relatório de tokens do gateway) e as respostas brutas em responses.jsonl.
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split pilot --k 0,1,2,4,8 --seeds 0,1,2
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector llm:gemini --model gemini-3.6-flash --split pilot --k 0,1,2,4,8
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector random_forest --split pilot --k 1,2,4,8,all
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector isolation_forest --split pilot --k all
uv run jev-ids metrics results/<run_id> [results/<run_id> ...] > results/summary.csv
uv run jev-ids compare --a results/<jev_run> --b results/<rf_run> --subset novel --k-a 0 --k-b all  # novel = zero-day attacks
k é o número de exemplos rotulados por categoria. k = 1 com cinco categorias significa cinco exemplos, e all significa o pool inteiro. metrics imprime uma linha CSV por detector e k com F1, recall em ataques zero-day (novel no código) e por categoria, PR-AUC e ROC-AUC de p_attack, tokens, latência e custo. compare emparelha duas execuções fluxo a fluxo e roda o teste de McNemar nos pares discordantes, porque apenas os fluxos em que dois detectores discordam os distinguem. O custo é calculado offline como tokens vezes os preços de tabela em prices.json, para todos os detectores igualmente.
docs/protocol.md fixa as entradas (o split paper de 2.000 fluxos, os prompts, os ids dos modelos, os preços) e make paper executa os quatro detectores sobre esse split em results/paper/ e grava results/paper/summary.csv. Cada detector tem seu próprio alvo (make paper-jev, make paper-llm, make paper-random-forest, make paper-isolation-forest), então podem rodar em terminais separados; o LLM é o lento. make paper-llm executa o Gemini 3.6 Flash no Vertex AI como cinco processos paralelos, um por k (make -j5 paper-llm); um erro de cota ou um timeout é uma linha de erro, e uv run jev-ids redo-errors results/paper/<run> julga esses fluxos novamente no lugar. As tabelas e figuras completas estão em docs/results.md.

