 jaidedai/easyocr
OCR pronto para usar com mais de 80 idiomas suportados e todos os sistemas de escrita populares, incluindo latim, chinês, árabe, devanágari, cirílico e etc.


OCR pronto para uso com mais de 80 idiomas suportados e todos os sistemas de escrita populares, incluindo: latino, chinês, árabe, devanágari, cirílico, etc.
Experimente a demonstração em nosso site
Integrado ao Huggingface Spaces 🤗 usando Gradio. Experimente a demonstração web:
24 de setembro de 2024 - Versão 1.7.2
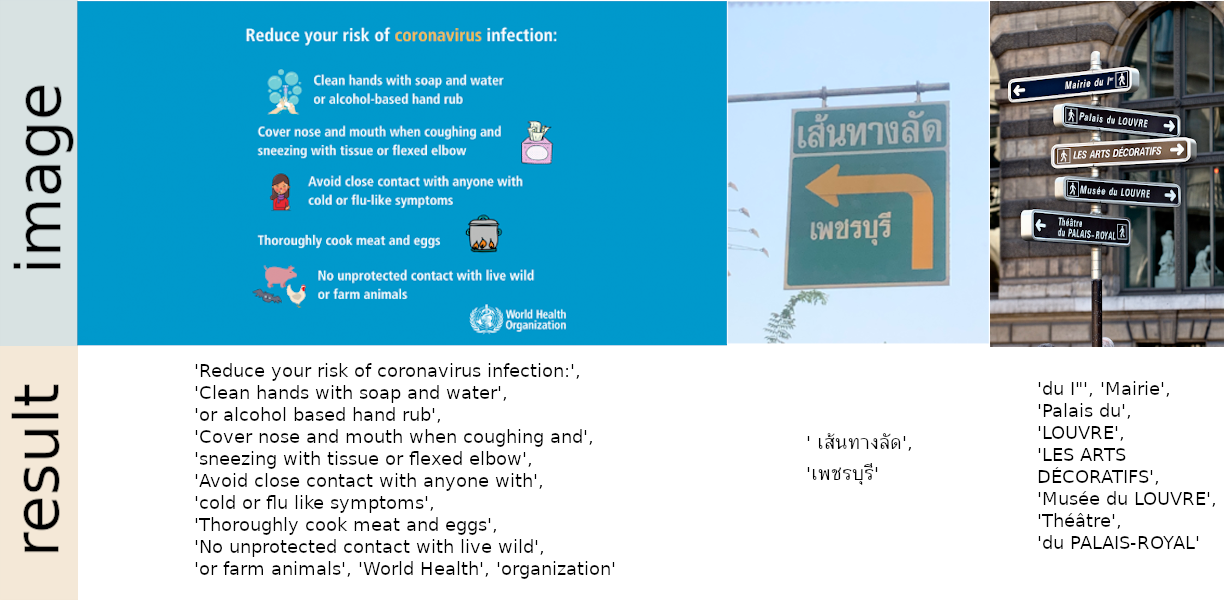
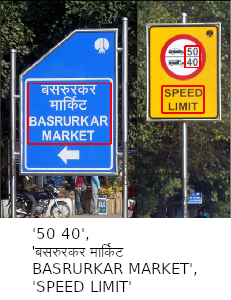
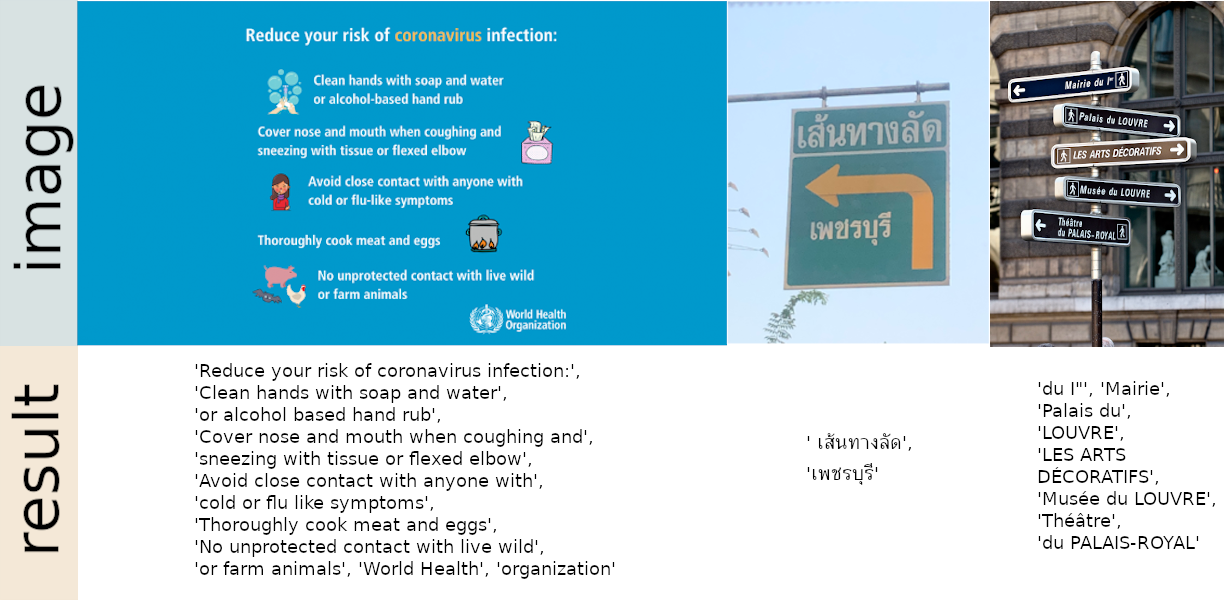
Instale usando pip
Para a versão estável mais recente:
pip install easyocr
Para a versão de desenvolvimento mais recente:
pip install git+https://github.com/JaidedAI/EasyOCR.git
Nota 1: Para Windows, instale primeiro torch e torchvision seguindo as instruções oficiais aqui https://pytorch.org. No site do pytorch, certifique-se de selecionar a versão CUDA correta que você possui. Se pretender executar apenas em modo CPU, selecione CUDA = None.
Nota 2: Também disponibilizamos um Dockerfile aqui.
Nota 3: O detector opcional DBNet (detect_network='dbnet18') compila as suas operações C++/CUDA na primeira utilização, o que requer a ferramenta de compilação Ninja. Para o instalar juntamente com o EasyOCR, utilize pip install "easyocr[dbnet]".
import easyocr
reader = easyocr.Reader(['ch_sim','en']) # this needs to run only once to load the model into memory
result = reader.readtext('chinese.jpg')
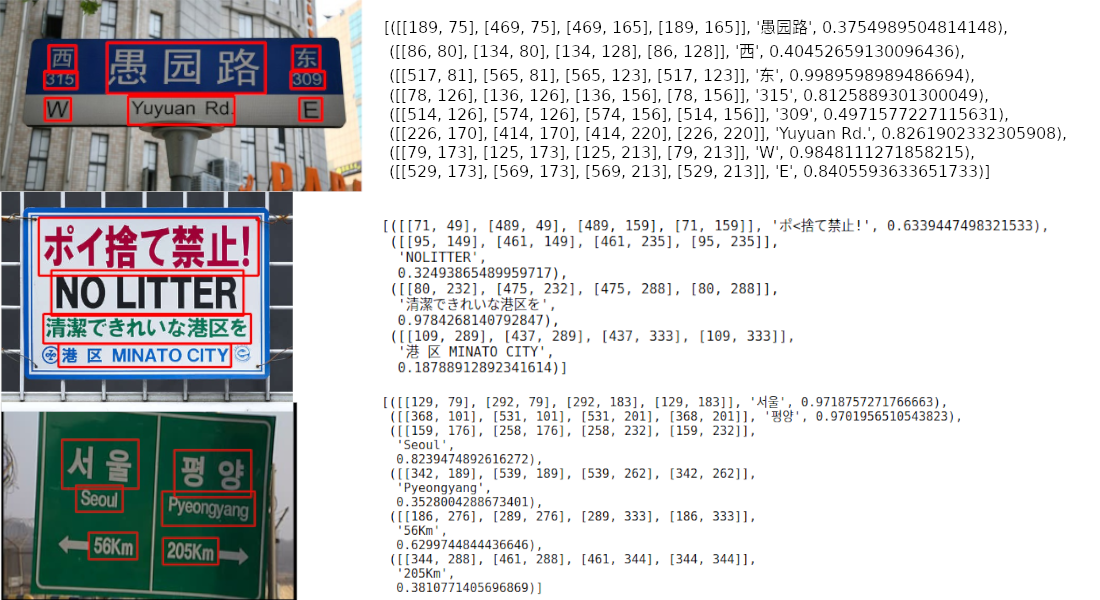
A saída estará em formato de lista, cada item representa uma bounding box, o texto detetado e o nível de confiança, respetivamente.
[([[189, 75], [469, 75], [469, 165], [189, 165]], '愚园路', 0.3754989504814148),
 ([[86, 80], [134, 80], [134, 128], [86, 128]], '西', 0.40452659130096436),
 ([[517, 81], [565, 81], [565, 123], [517, 123]], '东', 0.9989598989486694),
 ([[78, 126], [136, 126], [136, 156], [78, 156]], '315', 0.8125889301300049),
 ([[514, 126], [574, 126], [574, 156], [514, 156]], '309', 0.4971577227115631),
 ([[226, 170], [414, 170], [414, 220], [226, 220]], 'Yuyuan Rd.', 0.8261902332305908),
 ([[79, 173], [125, 173], [125, 213], [79, 213]], 'W', 0.9848111271858215),
 ([[529, 173], [569, 173], [569, 213], [529, 213]], 'E', 0.8405593633651733)]
Nota 1: ['ch_sim','en'] é a lista de idiomas que você deseja ler. Você pode passar vários idiomas ao mesmo tempo, mas nem todos os idiomas podem ser usados juntos. O inglês é compatível com todos os idiomas e os idiomas que compartilham caracteres comuns geralmente são compatíveis entre si.
Nota 2: Em vez do caminho de arquivo chinese.jpg, você também pode passar um objeto de imagem OpenCV (array numpy) ou um arquivo de imagem como bytes. Uma URL para uma imagem bruta também é aceitável.
Nota 3: A linha reader = easyocr.Reader(['ch_sim','en']) serve para carregar um modelo na memória. Isso leva algum tempo, mas precisa ser executado apenas uma vez.
Você também pode definir detail=0 para uma saída mais simples.
reader.readtext('chinese.jpg', detail = 0)
Resultado:
['愚园路', '西', '东', '315', '309', 'Yuyuan Rd.', 'W', 'E']
Os pesos do modelo para o idioma escolhido serão baixados automaticamente ou você pode baixá-los manualmente no model hub e colocá-los na pasta '~/.EasyOCR/model'
Caso você não tenha uma GPU, ou sua GPU tenha pouca memória, você pode executar o modelo em modo somente CPU adicionando gpu=False.
reader = easyocr.Reader(['ch_sim','en'], gpu=False)
Para mais informações, leia o tutorial e a Documentação da API.
$ easyocr -l ch_sim en -f chinese.jpg --detail=1 --gpu=True
Para o modelo de reconhecimento, Leia aqui.
Para o modelo de detecção (CRAFT), Leia aqui.
reader = easyocr.Reader(['en'], detection='DB', recognition = 'Transformer')
A ideia é poder conectar qualquer modelo de última geração ao EasyOCR. Há muitos gênios tentando criar modelos melhores de detecção/reconhecimento, mas não estamos tentando ser gênios aqui. Só queremos tornar o trabalho deles rapidamente acessível ao público ... de graça. (bem, acreditamos que a maioria dos gênios quer que seu trabalho crie um impacto positivo o mais rápido/amplo possível) O pipeline deve ser algo como o diagrama abaixo. Os espaços cinza são marcadores para módulos azul-claros substituíveis.
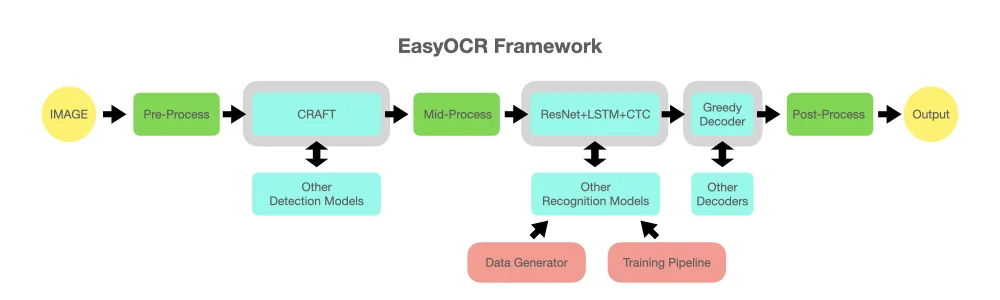
Este projeto é baseado em pesquisas e códigos de vários artigos e repositórios de código aberto.
Toda a execução de aprendizado profundo é baseada em Pytorch. ❤️
A execução da detecção usa o algoritmo CRAFT deste repositório oficial e do seu artigo (Obrigado @YoungminBaek do @clovaai). Também usamos o modelo pré-treinado deles. O script de treinamento é fornecido por @gmuffiness.

