 biniamf/ai-reverse-engineering
Engenharia Reversa Assistida por IA com Ghidra

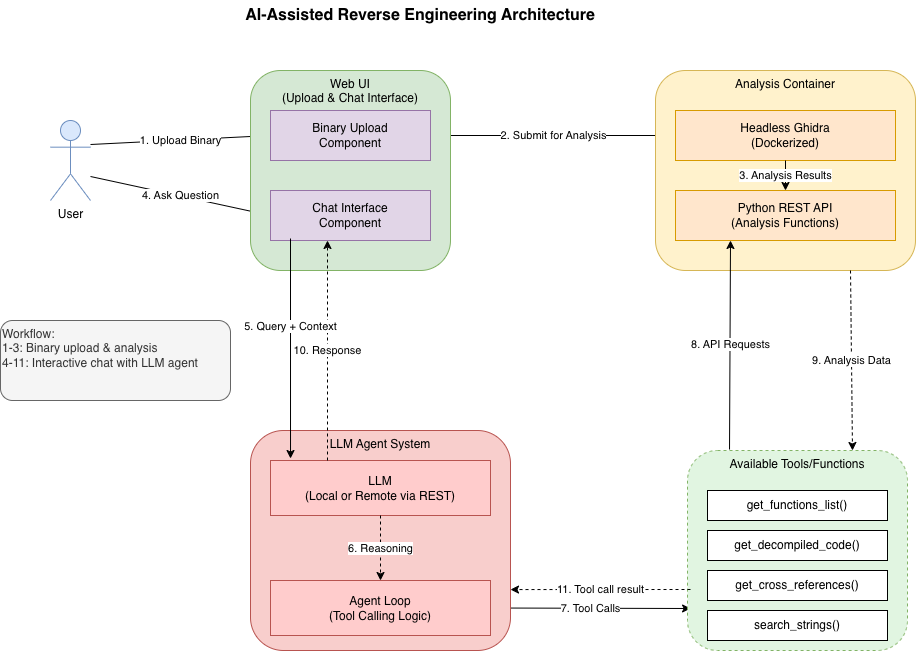
O Rev·Deck é uma estação de trabalho de análise estática, local e para um único usuário. Ele combina uma interface web focada em evidências com um copiloto de LLM sobre um binário analisado por um serviço Ghidra headless: navegue diretamente por evidências determinísticas (funções, strings, imports, referências cruzadas, um grafo de chamadas limitado) ou faça ao assistente perguntas limitadas cujas afirmações factuais devem citar evidências inspecionáveis.
Os binários analisados nunca são executados. O navegador fala apenas com este aplicativo Flask; o aplicativo faz proxy de solicitações validadas e tipadas para o serviço Ghidra.
https://github.com/user-attachments/assets/fba14dc5-7ad5-4137-9349-ed824da64fbe
cp .env.example .env      # set API_BASE and MODEL_NAME; set API_KEY if required
docker compose up --build
O Docker Compose lê .env automaticamente para interpolação. Ele falha antes de iniciar se API_BASE ou MODEL_NAME estiver ausente; API_KEY=not-used permanece válido para provedores locais/sem chave. A pilha inicia ambos os serviços. Abra http://127.0.0.1:5000.
Para executar apenas o serviço Ghidra:
docker pull biniamfd/ghidra-headless-rest:latest   # ensure the newest image

docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:latest
Para fixar uma versão de forma reproduzível, use o digest da versão testada em vez de latest:
docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3a8448d8ed969079b452306e806f36079c3ddd298f4a618d6e2f1442d
biniamfd/ghidra-headless-rest:latest.Copie .env.example para .env e preencha estes campos; veja esse arquivo para a lista completa e os padrões.
| Variável | Padrão | Significado |
|---|---|---|
API_BASE | obrigatório | URL base compatível com OpenAI (http/https). O Compose falha cedo quando ausente. |
API_KEY | not-used | Chave do provedor. Nunca é registrada em log nem enviada ao navegador; not-used é válida para provedores locais sem chave. |
MODEL_NAME | obrigatório | ID do modelo esperado pelo endpoint configurado. O Compose falha cedo quando ausente. |
LLM_STREAM | auto | Transporte de streaming: auto (transmitir em streaming, com fallback único para bloqueante em erro de compatibilidade antes da saída), true (sempre transmitir), false (sempre bloqueante). |
GHIDRA_API_BASE | http://127.0.0.1:9090 | URL base do serviço Ghidra. |
GHIDRA_IMAGE | biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3... | Versão testada fixada por digest imutável. :latest também resolve para este digest; substitua para fixar uma versão diferente. |
HOST / PORT | 127.0.0.1 / 5000 | Bind do servidor de desenvolvimento. |
MAX_UPLOAD_BYTES | 104857600 | Limite de tamanho do upload. |
CHATS_DIR | webui/chats | Diretório do histórico de conversas. |
O Rev·Deck conversa com qualquer endpoint de Chat Completions compatível com OpenAI por meio do SDK da OpenAI, configurado inteiramente por API_BASE / API_KEY / MODEL_NAME. Não há cabeçalho, parâmetro ou lógica de modelo específica de provedor: um servidor local Ollama (API_BASE=http://127.0.0.1:11434/v1), um endpoint vLLM/llama.cpp/LM Studio auto-hospedado, a própria OpenAI ou um gateway como o OpenRouter funcionam todos da mesma forma.
Exemplo de configurações de provedor no .env (use placeholders; nunca envie chaves reais):
# Ollama
API_BASE=http://127.0.0.1:11434/v1
API_KEY=not-used
MODEL_NAME=qwen3:8b
# OpenRouter
API_BASE=https://openrouter.ai/api/v1
API_KEY=replace-with-your-key
MODEL_NAME=anthropic/claude-opus-4.8
# OpenAI
API_BASE=https://api.openai.com/v1
API_KEY=replace-with-your-key
MODEL_NAME=replace-with-a-supported-model-id
# LM Studio, vLLM, or llama.cpp (adjust port/model to the server)
API_BASE=http://127.0.0.1:1234/v1
API_KEY=not-used
MODEL_NAME=replace-with-the-served-model-id
Por padrão (LLM_STREAM=auto), o assistente solicita uma resposta em streaming e retransmite os tokens ao navegador conforme eles chegam. O streaming também oferece uma garantia de cancelamento mais forte: quando você interrompe uma resposta (ou fecha a aba), o Rev·Deck fecha prontamente o fluxo subjacente do provedor e não realiza mais nenhuma rodada de ferramenta ou modelo; assim, a geração upstream é encerrada em vez de continuar rodando até a conclusão em segundo plano.
Ressalvas:
auto, se o provedor rejeitar a solicitação em streaming com um erro de compatibilidade (HTTP 400/404/405/422) antes de qualquer saída de conteúdo ou de chamada de ferramenta, o Rev·Deck recorre a uma única chamada bloqueante uma vez e lembra disso pelo restante do processo. Erros de autenticação (401/403), de limite de taxa (429) e de servidor (5xx) não são tratados como problemas de compatibilidade e são exibidos como erros em vez de serem repetidos silenciosamente. Defina LLM_STREAM=false para pular o streaming por completo, ou LLM_STREAM=true para exigi-lo (sem fallback).Abra o aplicativo e envie um binário para iniciar um trabalho de análise. Conteúdo que seja claramente texto simples pede confirmação antes de ser enviado ao Ghidra; use a substituição explícita de binário bruto somente quando o conteúdo for intencionalmente firmware/dados, e não um formato executável. Quando a análise for concluída, alterne entre duas abas do espaço de trabalho:
Ambos os modos aceitam um orçamento de passos por tarefa e uma opção No step limit, que executa até a tarefa terminar (ainda limitada por MAX_STEP_BUDGET para que um modelo em loop não possa fugir do controle). Se uma execução atingir seu orçamento, ela relata resultados parciais e oferece Continue — que retoma a mesma conversa usando as evidências já recuperadas, sem refazer chamadas de ferramenta concluídas. O custo cresce com o número de chamadas de ferramenta/modelo; portanto, orçamentos maiores custam mais.
Workflows disponíveis:
