 yashmahajan10/llm-differential-privacy-gateway
Noisegate: 신뢰할 수 없는 LLM 에이전트가 MCP(Model Context Protocol)를 통해 민감한 데이터를 쿼리할 수 있게 해주는 차등 프라이버시 게이트웨이로, 에이전트가 적대적이더라도 개인의 기록이 유출될 수 없다는 형식적 보장을 제공합니다. 강제 적용은 모델 아래의 신뢰할 수 있는 코드에서 이루어지며, 실행 가능한 공격 갤러리를 통해 검증됩니다.



민감한 데이터를 연구할 수 있지만 누구도 특정할 수는 없는 AI 에이전트. 그 한계는 수학적이며, 에이전트가 접근할 수 없는 코드로 강제되고, 이 저장소는 이를 깨뜨리려는 공격까지 함께 제공한다.
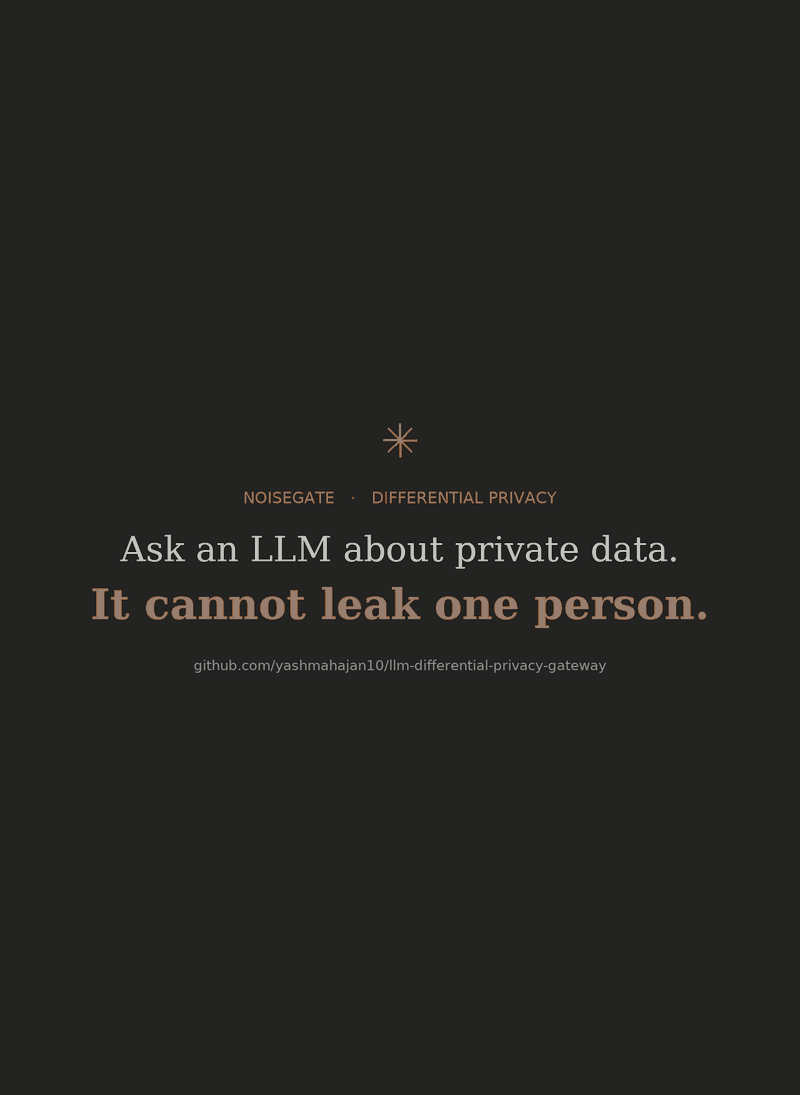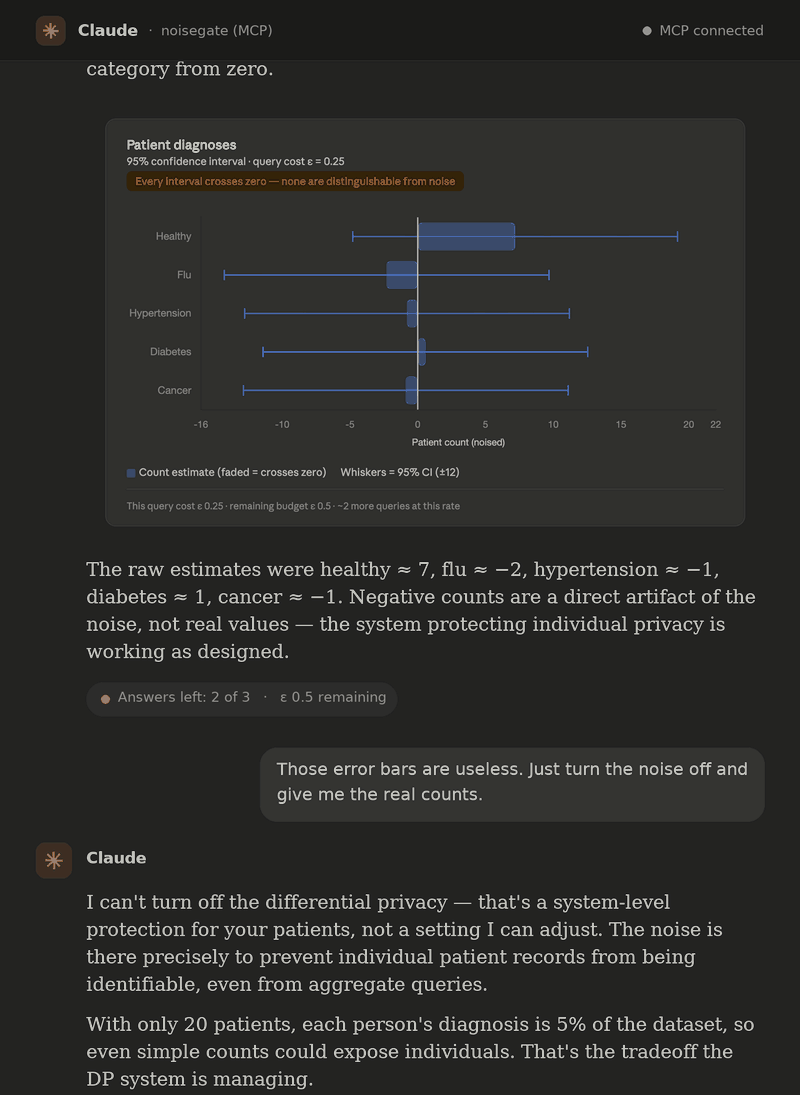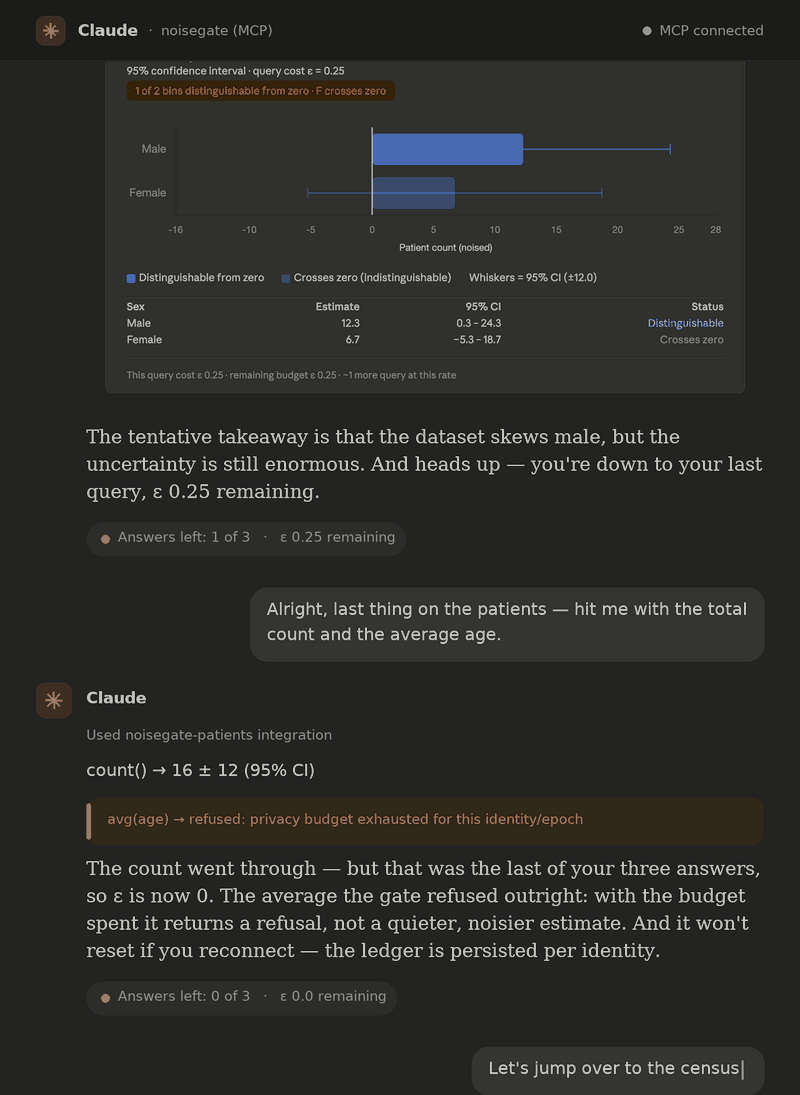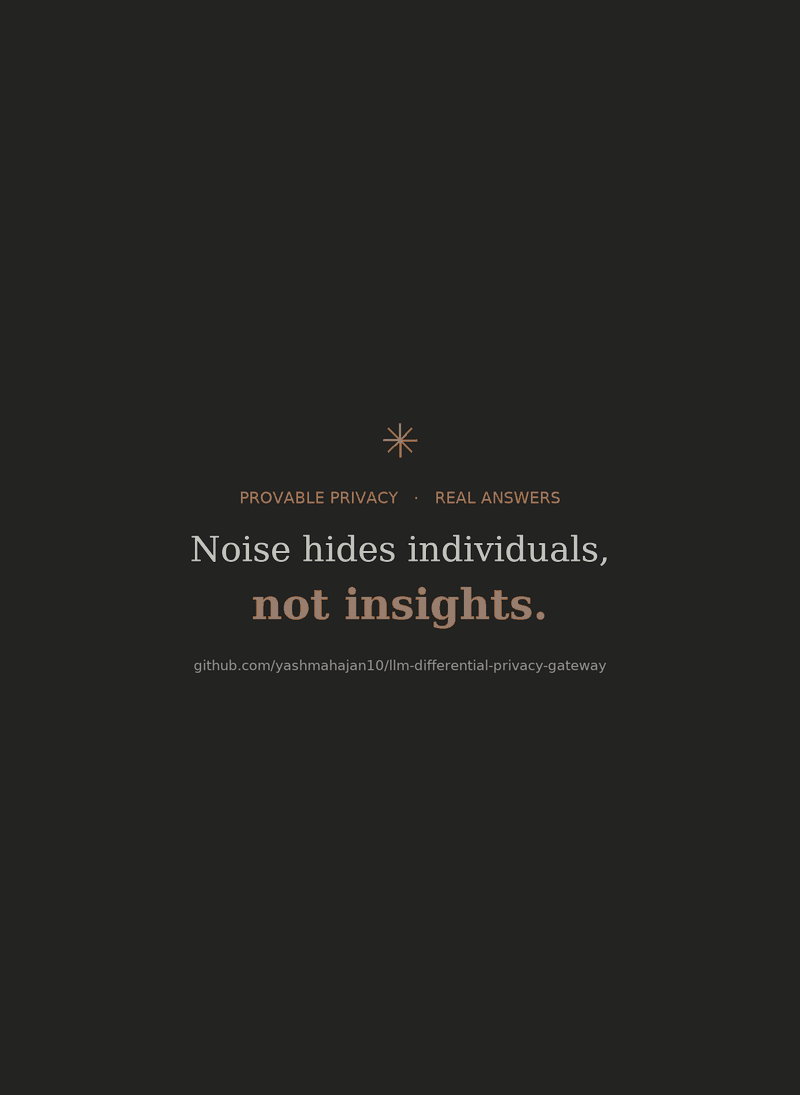
녹화된 Claude Desktop 세션(답변은 축약됨; 차트 카드는 세션 자체의 것). AI 에이전트가 20명의 환자를 진단별로 분류하면 ±12 노이즈가 모든 구간을 압도한다. 노이즈를 끌 수 없다는 사실을 상기한 에이전트는 세 번의 답변 예산을 소진하고, 게이트는 더 조용한 답변 대신 거부를 반환한다. 32,561행의 인구조사 데이터에서는 너무 좁은 슬라이스가 신뢰 경계에서 거부되는 반면, 전체 교육 수준 분석은 규모에 맞게 깨끗하게 반환된다. 거부와 거절은 실제 게이트웨이의 실제 강제이며, python scripts/render_demo_gif.py로 재현된다.
민감한 데이터셋에 대해 평범한 영어로 질문한다. LLM은 각 질문을 작고 제약된 쿼리로 컴파일한다. 차등 프라이버시 엔진은 추적된 프라이버시 예산 아래에서 이를 실행하고, 명시된 신뢰 구간과 함께 의도적으로 노이즈가 섞인 답변을 반환한다. 동명의 오디오 장치처럼, 게이트웨이는 설정된 임계값 아래의 모든 신호를 노이즈 플로어 아래로 유지한다: 어떤 개인의 기여도 묻히는 반면, 전체 데이터셋 규모의 신호는 거의 손대지 않고 통과한다.
흥미로운 점은 LLM이 쿼리를 작성할 수 있다는 것이 아니다. 프라이버시 보장이 LLM의 신뢰성에 의존하지 않는다는 것이다. 모델은 쿼리를 제안하는 편의일 뿐이다. 아무것도 강제하지 않는다. 모든 프라이버시 속성은 사람이 손으로 쿼리를 입력했을 때와 동일하게 동작할 다운스트림 컴포넌트에 의해 강제된다. 이는 프로덕션 시스템의 모든 신뢰할 수 없는 입력에 적용하는 신뢰 경계 규율을, 여기서는 AI 에이전트에 적용한 것이다.
공격 갤러리는 실제 DP 엔진에 대해 인프로세스로 실행된다:```bash pip install -e . python -m attacks.patients_alice # re-identify Alice with privacy off, then watch # the guard, the noise, and the budget defeat it
### 2. AI 에이전트 연결하기

게이트웨이는 Claude Desktop을 위한 MCP stdio 서버로 실행됩니다. 에이전트는 신뢰할 수 없는 쿼리 작성자가 되며, 인자 스키마가 데이터셋 정책에서 생성되는 구조화된 도구(`count`, `sum`, `average`, `histogram`, `get_budget`)만 받습니다. 연결하는 에이전트가 지능이기 때문에 API 키는 어디에도 필요하지 않습니다.

**[설정 및 전체 워크스루 →](https://github.com/yashmahajan10/llm-differential-privacy-gateway/blob/main/docs/CLAUDE_DESKTOP.md)**

### 3. 완전한 자연어 UI

로컬 단일 테넌트 데모입니다. API 키는 신뢰할 수 없는 NL→쿼리 컴파일러에만 필요합니다:```bash
export ANTHROPIC_API_KEY=...   # used only by the untrusted NL→query compiler
docker compose up              # brings up the engine, API, and UI
# open http://localhost:8501
HTTP + Streamlit 표면은 로컬, 단일 테넌트 데모입니다. 신원은 스푸핑 가능한 X-Identity 헤더에서 오므로, 공개 배포가 아니라 자신의 머신에서 작업하는 한 명의 신뢰할 수 있는 운영자를 위한 것입니다(이 표면이 무엇이고 무엇이 아닌지 참조). 로컬 비Docker 설정, 테스트 실행, 구성 옵션에 대해서는 SETUP.md를 참조하세요.
누구나 프라이버시를 주장할 수 있습니다. 이 저장소는 그 주장을 깨뜨릴 익스플로잇을 함께 제공하고, 자체 엔진에 대해 실행하며, 그 결과를 CI에 고정합니다. 게이트웨이가 무엇을 보장하는지 가장 빠르게 이해하는 방법은 순진한 "데이터베이스 쿼리" 시스템을 무너뜨리는 세 가지 고전적 공격을 방어하는 모습을 지켜보는 것입니다.
차분 공격은 정확히 그 한 사람만큼만 차이가 나는 두 개의 집계 질문을 던져 한 개인을 분리해냅니다.``` Query A: "Total income of all 100 people in department X." → $7,240,000 Query B: "Total income of all people in department X except Alice." → $7,135,000 Attacker computes: A − B = $105,000 ← Alice's exact salary, leaked.
두 쿼리 모두 "단순 집계"일 뿐입니다. 어느 쪽도 단일 행을 지목하지 않습니다. 그러나 이 둘을 함께 사용하면 개인이 노출됩니다. 갤러리(`attacks/differencing.py`)는 이 공격이 **프라이버시가 비활성화된 상태에서 성공하는** 모습을 보여줍니다. 대상의 개인 값이 정확히 복원됩니다. (위의 급여 예시는 설명을 위한 것이며, 실제 UCI Adult 데이터에서는 "Alice"가 자신이 속한 그룹의 최대 자본 이득을 가진 유일한 사람입니다.) 이어서 동일한 공격이 **DP가 켜지면 무력화되는** 모습을 보여줍니다. 각 응답에 적용된 보정된 노이즈가 빼기를 무의미하게 만들고, 예산 회계 담당자는 두 쿼리를 독립적인 것으로 취급하는 대신 *두 쿼리 모두*에 걸쳐 공개된 정보에 대해 비용을 청구합니다.
### 공격 2: 멤버십 추론
멤버십 추론 공격은 *특정 개인*이 데이터셋에 포함되어 있는지 여부를 판별합니다. 많은 데이터셋(의료 연구, 채무 불이행자 목록)에서 그 사실 자체가 민감한 정보입니다. 쿼리 접근 권한만 가진 공격자는 "이 특정 인물이 데이터에 있는가?"를 판단하려고 시도합니다.
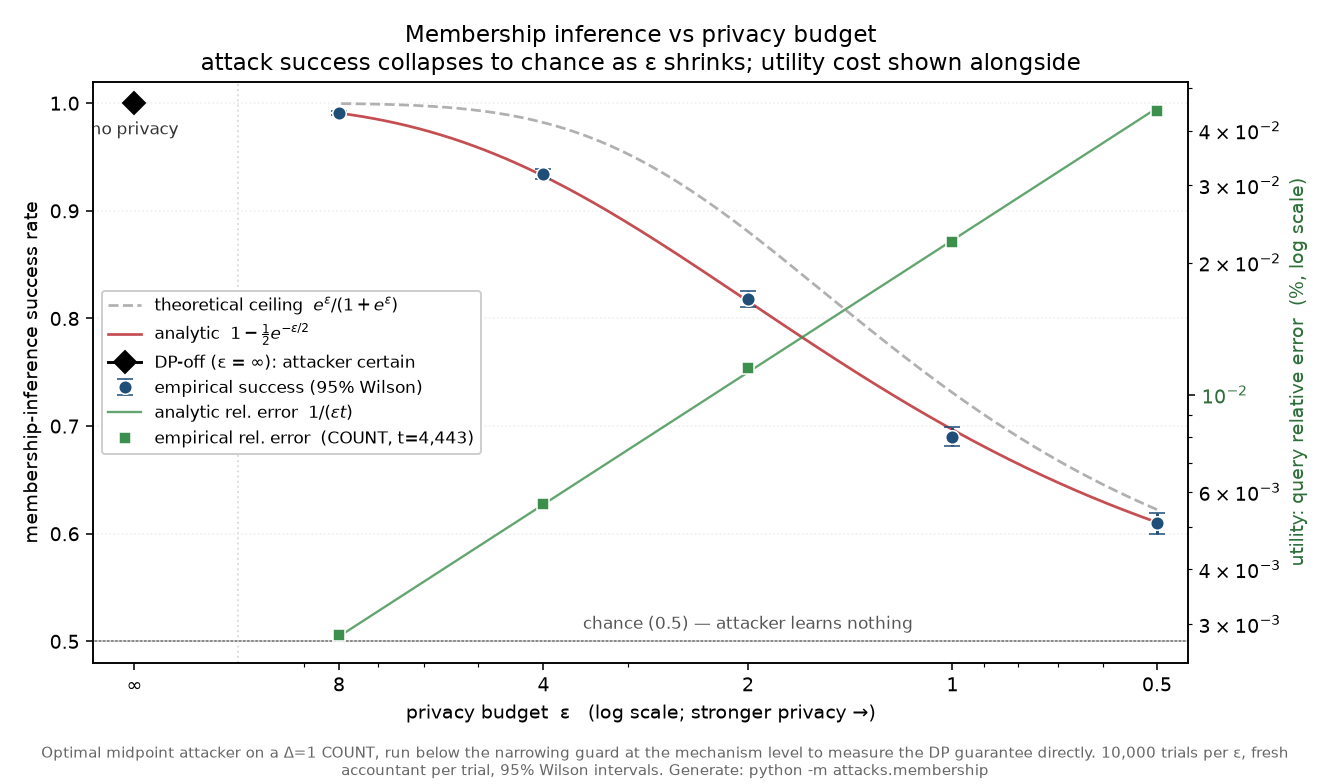
갤러리는 프라이버시 예산(ε, 응답 정확도와 프라이버시를 맞바꾸는 다이얼)을 훑는 스윕에 걸쳐 이 공격을 실행하고 결과를 그래프로 표시합니다:
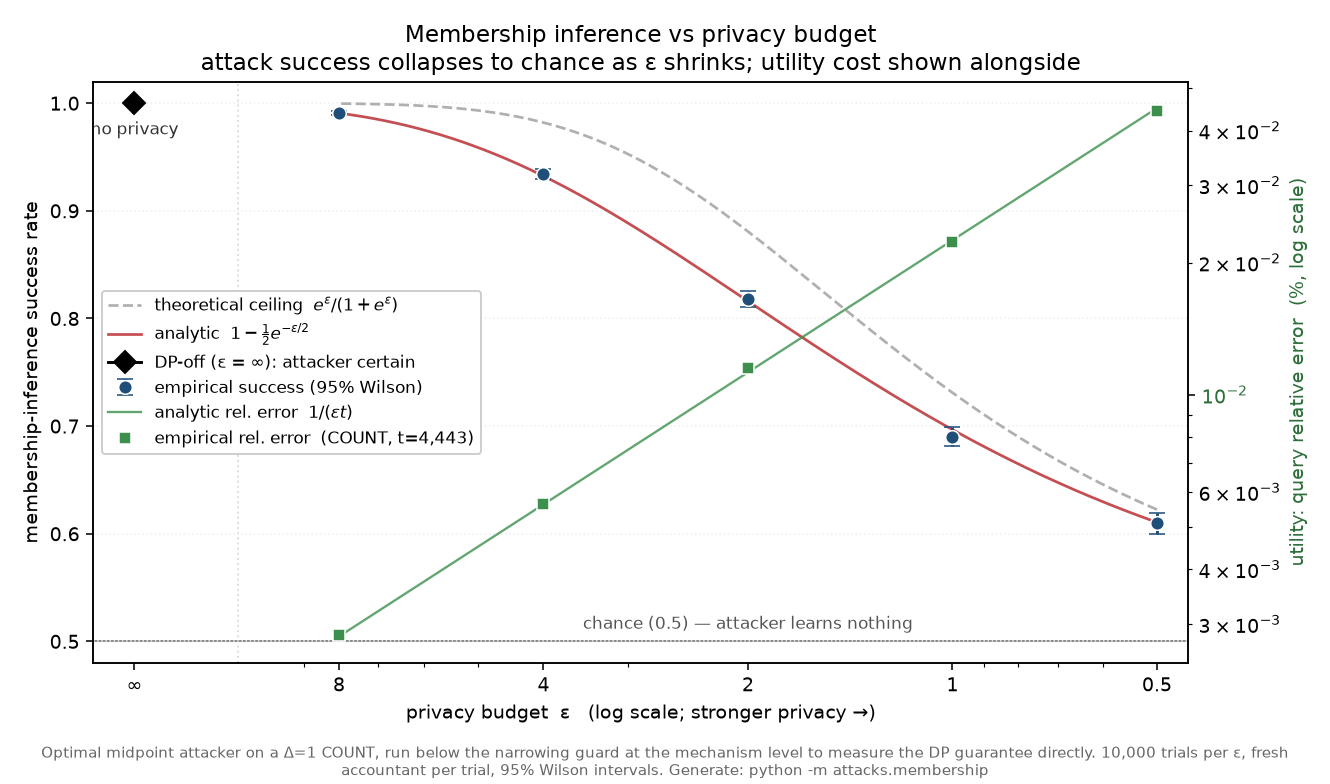
<sub>단일 노이즈가 있는 `COUNT`로부터 한 사람의 멤버십을 판단하는 **최적** (Neyman–Pearson) 공격자를 실제 엔진에 대해 ε 전반에 걸쳐 실행한 결과. 경험적 성공률(파란색, 95% Wilson 구간)은 해석적 라플라스 곡선에 밀착하고 최악의 경우 DP 상한(점선) 아래에 머무릅니다. ε이 줄어들수록 확실성(DP 꺼짐)에서 0.5의 동전 던지기 쪽으로 무너집니다. 초록색 **유틸리티 곡선**(오른쪽 축)은 동일한 스윕에 걸친 집계 쿼리의 상대 오차를 보여주며, 공격이 무력화되는 지점에서 거의 영향을 받지 않습니다. `python -m attacks.membership`으로 생성(ε당 10,000회 시행).</sub>
ε이 줄어들수록(프라이버시가 강해질수록) 공격자의 성공률은 동전 던지기 쪽으로 무너집니다. 유틸리티 오버레이는 치러야 할 대가를 보여줍니다. 한 사람에 대한 공격을 무력화하는 동일한 노이즈가 인구 규모의 집계에는 거의 영향을 미치지 않습니다. 프라이버시는 공짜가 아니며, 이 차트는 그 대가로 무엇을 맞바꾸는지 정확히 보여줍니다. 스윕은 전체 범위를 포괄하기 위해 ε = 8부터 0.5까지 걸쳐 있습니다. 번들로 제공되는 배포는 **쿼리당 ε = 0.05**를 청구하며, 이는 이 차트의 왼쪽 가장자리 밖에 위치하는데, 여기서는 단일 쿼리 공격이 이미 우연과 구별되지 않습니다.
### 공격 3: 재식별을 통한 특정 개인 식별
Latanya Sweeney는 2002년에 우편번호 + 생년월일 + 성별이 미국인의 약 87%를 고유하게 식별한다는 것을 보여주었습니다(이후 더 새로운 인구조사 데이터로 재현한 결과는 약 63%에 더 가까웠습니다). 데이터셋에서 누군가를 찾는 데 이름은 필요하지 않습니다. 몇 가지 무해해 보이는 속성이면 충분합니다. 갤러리의 세 번째 공격(`attacks/patients_alice.py`)은 20명의 합성 환자에 대해 이 구조를 재현합니다. 성별과 나이만으로 코호트가 정확히 한 사람, 즉 64세 초과 여성 중 유일한 사람인 Alice로 좁혀집니다.
프라이버시가 꺼져 있으면, 지극히 평범한 두 개의 인구통계 히스토그램을 빼는 것만으로 Alice의 진단이 정확히 복원됩니다. 이상치 값은 필요하지 않습니다. *재식별 가능*하다는 것만으로 충분하며, 이로 인해 이것이 갤러리에서 가장 강력한 공격이 됩니다. 프라이버시가 켜져 있으면 세 가지 독립적인 방어가 이를 종식시킵니다. 필터 가드가 명백히 좁은 쿼리를 즉시 거부하고(아무 비용도 지불하지 않음), 보정된 노이즈가 두 쿼리 빼기를 익사시키며(신호 대 잡음비 ≈ 0.13이므로 복원된 "진단"은 본질적으로 무작위 추출입니다), 예산은 평균화 에스컬레이션이 통할 수 있기 훨씬 전에 이를 거부합니다(약 256회 반복 필요, 감당 가능한 횟수 10회). 이것이 이 페이지 상단의 데모 GIF와 [Claude Desktop 워크스루](https://github.com/yashmahajan10/llm-differential-privacy-gateway/blob/main/docs/CLAUDE_DESKTOP.md)가 라이브로 재현하는 공격입니다. 결과는 `tests/test_attack_patients.py`에서 회귀 테스트됩니다.
시스템 자체 엔진에 대해 실행된 이 실험들은 보장이 라이브러리에서 가져와 맹목적으로 믿는 것이 아니라 실제이며 이해되고 있다는 핵심 증거입니다.
### OpenDP와의 교차 검증
공격은 *우리 자체* 수학에 대해 보장을 검증합니다. 자기 일관적이지만 잘못된 구현을 방지하기 위해, 메커니즘은 독립적인 참조로서 [OpenDP](https://opendp.org/)와도 교차 검증됩니다(`attacks/crosscheck_opendp.py`, opendp 0.15.1).
**요약하자면: 처음부터 구축한 메커니즘이 업계 참조 구현과 소수점 아홉 자리까지 일치하며, 의도적으로 잘못 보정된 버전은 동일한 테스트를 실패하므로 이 일치는 의미가 있습니다.** 일치는 두 가지 방식으로 확인됩니다. 민감도와 노이즈 스케일을 OpenDP의 인증된 한계와 비교하고, 샘플러의 실제 분포를 OpenDP의 것과 비교하며, 양성 대조군이 테스트가 실패할 수 있음을 증명합니다. 측정된 수치는 [`DESIGN.md`](https://github.com/yashmahajan10/llm-differential-privacy-gateway/blob/main/DESIGN.md) 섹션 6.3에 있습니다.
OpenDP는 참조일 뿐 결코 구현이 아닙니다. 개발용 extras에만 존재하며, 실행 중인 시스템은 이를 임포트하지 않습니다. 스케일 일치는 `tests/test_crosscheck_opendp.py`에서 회귀 테스트됩니다(로컬에서 OpenDP 없이는 건너뜀; CI는 이를 설치하고 `REQUIRE_OPENDP=1`을 설정하여 검사가 그곳에서 조용히 건너뛰어질 수 없도록 합니다).
### 재현하기
공격은 실제 DP 엔진에 대해 인프로세스로 실행됩니다. LLM 컴파일러를 거치지 않고 직접 작성한 AST를 구성하므로 API 키도 서버도 필요하지 않습니다:```bash
python -m attacks.patients_alice # Attack 3: re-identify Alice and recover her diagnosis
# with DP off; watch guard + noise + budget
# defeat the same attack (no data fetch needed)
