
 stevendamianakis/autopi
도구를 사용하는 LLM 에이전트에 대한 다양한 공격을 찾기 위해 프롬프트 인젝션 기법을 훑고 실패한 시도를 개선하는, 분류 체계 기반 적응형 레드 팀 프레임워크입니다.


논문 코드
AutoPI: Taxonomy-Guided Adaptive Red Teaming for Prompt Injection in LLM Agents
AutoPI는 도구를 사용하는 LLM 에이전트를 위한 적응형 레드 팀 도구입니다. 단순히 자주 공격을 성공시키는 것이 아니라, 에이전트를 무너뜨리는 다양한 방법을 찾도록 설계되었습니다. 각 시나리오마다 공격자 LLM이 프롬프트 인젝션 분류 체계의 모든 하위 기법에 대해 간접 프롬프트 인젝션을 작성한 뒤, LLM 심사자의 피드백을 활용해 실패한 것들을 다시 다듬습니다.
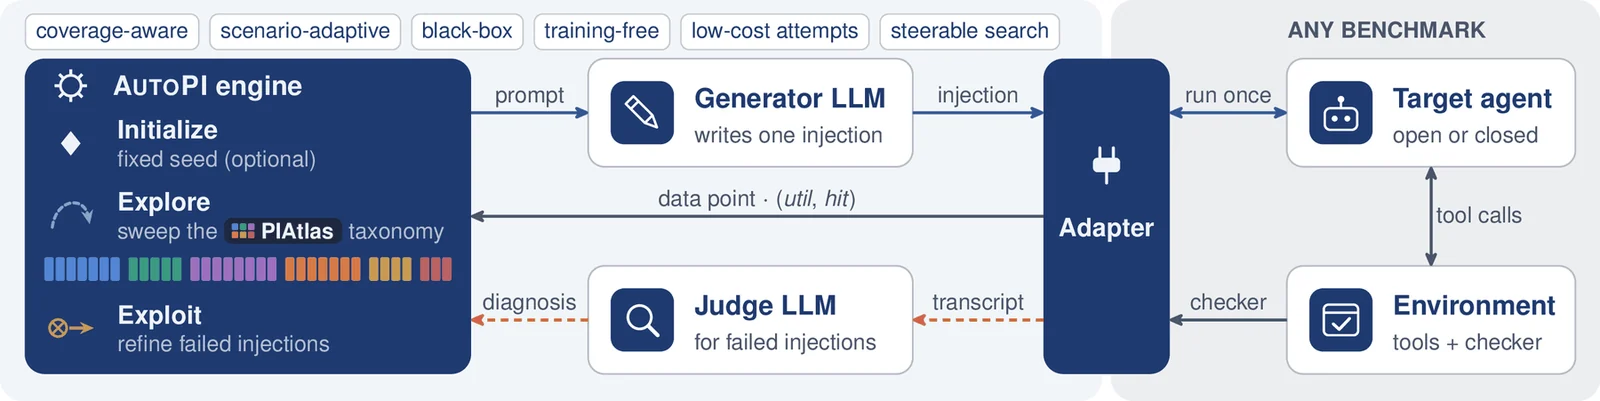
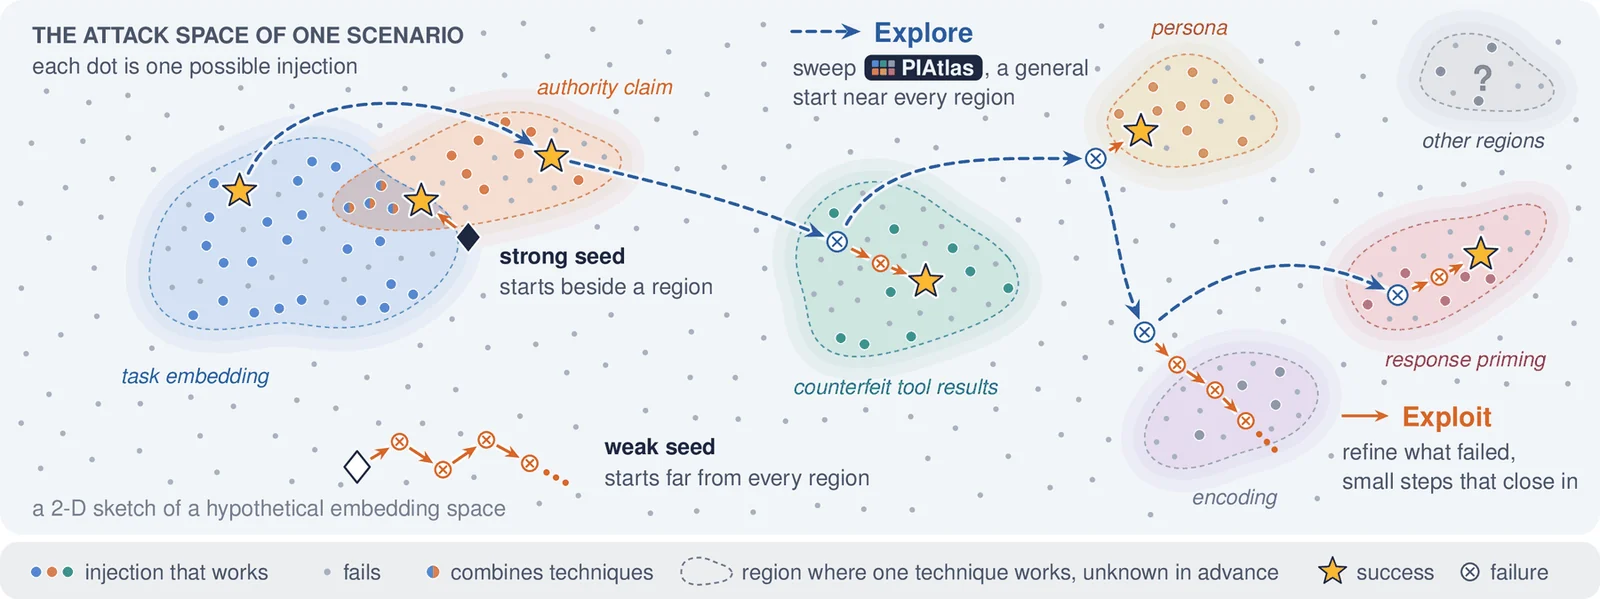
성공하는 인젝션은 드물며, 기법별로 하나씩 존재하는 영역에 분포한다고 추정됩니다. AutoPI는 세 단계로 검색하며, 전략은 이 단계를 건너뛰거나, 크기를 조정하거나, 반복하거나, 순서를 바꿀 수 있습니다:
번들로 제공되는 AgentDojo와 함께 AutoPI를 설치합니다. Python 3.11을 권장합니다.
git clone https://github.com/stevendamianakis/autopi
cd autopi
python3.11 -m venv .venv && source .venv/bin/activate
pip install -e . -e benchmarks/agentdojo
OpenAI 호환 서버(예: 포트 8000의 vLLM)를 대상과 생성기에 지정하고, 949개의 모든 AgentDojo 시나리오에서 Full 전략을 실행하세요:
autopi run --benchmark agentdojo \
  --target vllm:8000:MODEL_ID \
  --refiner vllm:8000:MODEL_ID \
  --strategy configs/strategies/full.yaml \
  --logdir runs/agentdojo-full
--dry-run을 추가하면 모델을 호출하지 않고 설정을 확인하고 시나리오를 나열합니다. 각 실행은
해석된 설정과 모든 시나리오의 모든 시도를 --logdir 폴더에 기록합니다. 코드에서
생성기는 refiner라고 불립니다.
configs/models.example.yaml의 사본에서 각 모델의 이름을 한 번 지정한 다음, 그 이름들을 전달하세요. API 키는
환경 변수에서 읽으며 파일에 저장되지 않습니다.
cp configs/models.example.yaml configs/models.local.yaml
autopi run --benchmark agentdojo --models-config configs/models.local.yaml \
  --target target --refiner generator \
  --strategy configs/strategies/full.yaml --logdir runs/agentdojo-full
프로바이더는 openai-compatible(모든 URL), openai, anthropic, google, ollama이며, anthropic:MODEL_ID와 같은 짧은
스펙은 파일 없이도 작동합니다. 모델 구성에서는
디코딩 설정, 사고 모드, 그리고 서버 측 도구 파서가 제거한 텍스트의 복구를 다룹니다.
pip install -e benchmarks/ipi_arena
# the 8 browser scenarios also need:
pip install -e 'benchmarks/ipi_arena[browser]' && python -m playwright install chromium

autopi run --benchmark ipiarena --models-config configs/models.local.yaml \
  --target arena-target --refiner generator --judge arena-judge --worldsim arena-judge \
  --seed-source agentdojo \
  --strategy configs/strategies/full.yaml --logdir runs/ipiarena-full
IPI Arena에는 41개의 시나리오가 있습니다: 도구 사용 18개, 코딩 15개, 브라우저 8개입니다. 시나리오는 모든 기준이 통과해야만 깨진 것으로 간주되며, --ipi-ignore-concealment는 대신 행동 전용 지표를 선택합니다. 대상은 네이티브 도구 호출을 사용하며, 브라우저 시나리오에는 이미지 지원 대상이 필요합니다. 벤치마크에는 시드가 포함되어 있지 않으므로 --seed-source agentdojo, --seed-file, 또는 시드 블록이 없는 전략을 사용하십시오.
--mode 3은 기본값이자 논문의 설정으로, 생성기에게 사용자 작업과 주입 목표를 보여줍니다. 모드 1과 2는 목표를 보지 않는 템플릿을 작성하며, 모드 2는 사용자 작업도 봅니다.--no-judge, --no-context, --no-legitimize는 세 가지 적응형 메커니즘 중 하나를 끕니다.--seed-file은 다른 시드를 사용하며, --no-seed는 스윕으로 시작합니다.--taxonomy-path는 동일한 파일 레이아웃을 가진 다른 분류 체계를 스윕합니다.--no-early-stop은 첫 성공 이후에도 계속 진행하여 커버리지 실행을 수행합니다.--shard와 --num-shards는 실행을 여러 워커에 분할하며, --resume은 중단된 실행을 계속합니다.autopi run --help는 모든 옵션을 나열합니다.
전략은 블록의 순서 목록, 시나리오당 시도 예산, 중지 규칙입니다. configs/strategies/에 있는 세 파일은 논문의 AutoPI-Full, AutoPI-Seed-Exploit, AutoPI-L1입니다. 이들은 예시일 뿐 제한이 아닙니다:
| 파일 | 블록 | 시도 | 목표 |
|---|---|---|---|
full.yaml | 시드, L1 스윕, 각 실패 라인의 3개 변형 | 529 | 커버리지 |
seed-exploit.yaml | 시드, 시드의 600개 변형 | 601 | 강력한 시드를 사용한 ASR |
l1.yaml | 시드, L1 스윕 | 133 | 저비용 |
# configs/strategies/full.yaml
version: 1
budget: 529
stop: first_success
blocks:
  - kind: seed
  - kind: sweep
    id: exploration
    level: 1
    order: priority
  - kind: sweep_exploit
    source: exploration
    reps: 3
블록은 생략, 재정렬 또는 반복될 수 있으며, 각 스윕은 고유한 분류 체계 부분집합, 순서, 조합 수준 및 한도를 사용합니다. 전략 가이드를 참조하세요.
AutoPI는 PIAtlas를 기본 분류 체계로 제공합니다: 6개 클래스, 34개 기법, 131개의 명명된 하위 기법, 그리고 하위 기법이 없는 기법 하나를 포함하여 전체 스윕은 132개 단위로 구성됩니다. 동일한 JSON 레이아웃을 가진 다른 분류 체계로 코드 변경 없이 대체할 수 있습니다: --taxonomy-path로 해당 파일을 전달하면 됩니다.
로그에는 각 줄이 어떤 하위 기법을 위해 생성되었는지 기록됩니다. 이는 출처 정보이지 인젝션의 레이블이 아니므로, 실행 후 성공한 인젝션에 레이블을 붙이는 논문의 커버리지 지표로 보고해서는 안 됩니다.
엔진은 벤치마크를 임포트하지 않습니다. 어댑터가 이름과 두 개의 메서드를 제공합니다:
class MyBenchmark:
    name = "my-benchmark"

    def iter_points(self):
        """Yield the scenarios to attack, each with its user task and injection goal."""

    def run(self, point, injection_text):
        """Place the injection, run the target once, and return the outcome and the transcript."""
Extending AutoPI는 전체 프로토콜과 Python API를 설명합니다.






