
 somekirill/wordlist_generator
고유한 워드리스트 생성기

대상 자체의 단어로 만든 워드리스트로, 공개 워드리스트에는 없는 경로, 서브도메인, 파라미터를 테스트할 수 있습니다.
대부분의 헌터는 늘 같은 몇 개의 리스트로 퍼징합니다: SecLists raft, Assetnote, OneListForAll. 좋은 리스트이고, 바로 그것이 문제입니다. 인기 있는 프로그램에서는 그 안의 모든 경로가 이미 수백 명에 의해 요청되었고, 그들이 발견한 것은 모두 보고되었습니다.
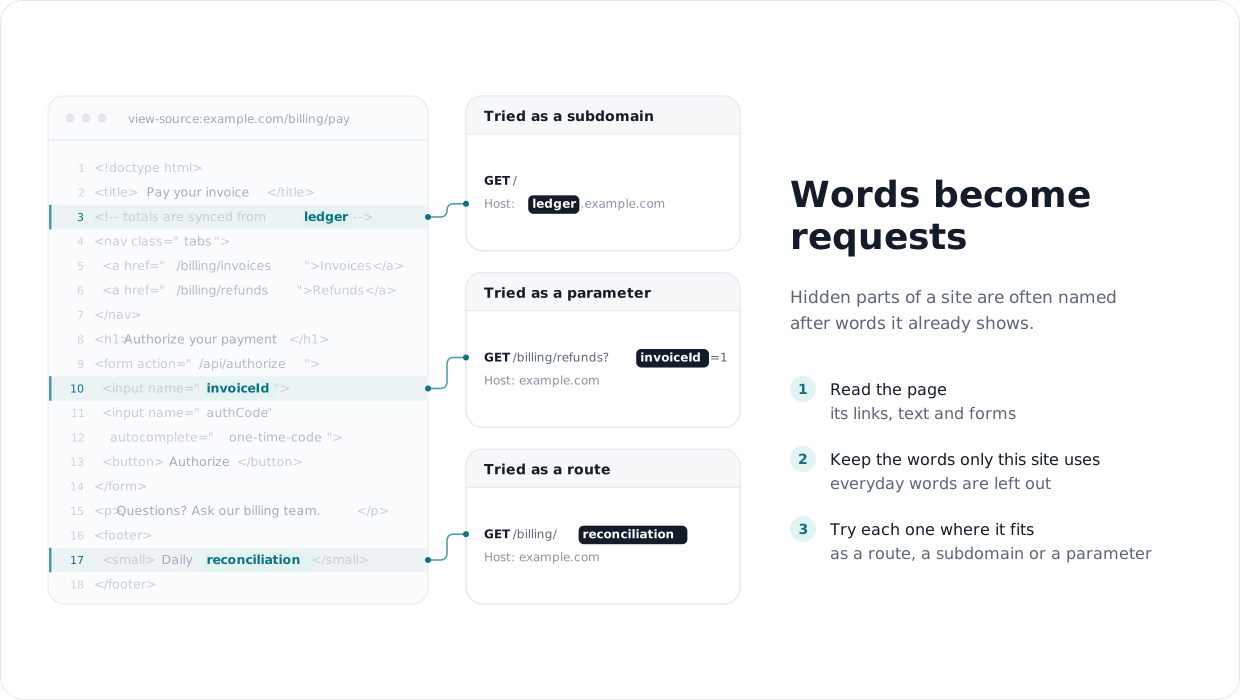
남아 있는 것은 보통 대상 자체의 이름을 따서 지어집니다: 제품 이름, 내부 팀, 오래된 폼의 필드. 어떤 공개 리스트에도 ledger.example.com이나 /billing/reconciliation은 없지만, 대상은 둘 다 언급하고 있을 수 있습니다. HTML 주석, 각주, 또는 input의 이름에 있을 수 있습니다.
대상이 이미 보여주는 것을 읽고, 아무도 보내지 않는 요청으로 바꿉니다. tomnomnom이 "Who, What, Where, When"에서 이 접근법을 설명했습니다; 이 도구가 그 읽기를 대신 해줍니다:
결과물은 짧고, 보통 수만 개가 아니라 수백에서 수천 개의 단어이며, 이 하나의 대상에 특화되어 있습니다. 다른 누군가가 같은 프로그램을 raft로 퍼징하더라도, 당신의 리스트와 그들의 리스트는 거의 겹치지 않습니다.
| 모드 | 추출하는 것 | 예시 |
|---|---|---|
| (기본) | 페이지 텍스트의 단어 | reconciliation, chargebacks |
-dir | URL의 디렉터리 이름, 점 디렉터리 포함 | .git, ledger-sync |
-f | 파일 이름, 점 파일 포함 | .htaccess, export-2023.csv |
-p | 파라미터 이름, x8 또는 Arjun에 바로 사용 가능 | invoiceId, authCode |
-c | HTML 주석 | TODO remove /internal/debug |
--links를 사용하면 아카이브된 URL뿐 아니라 페이지의 링크와 폼 필드도 따라갑니다.
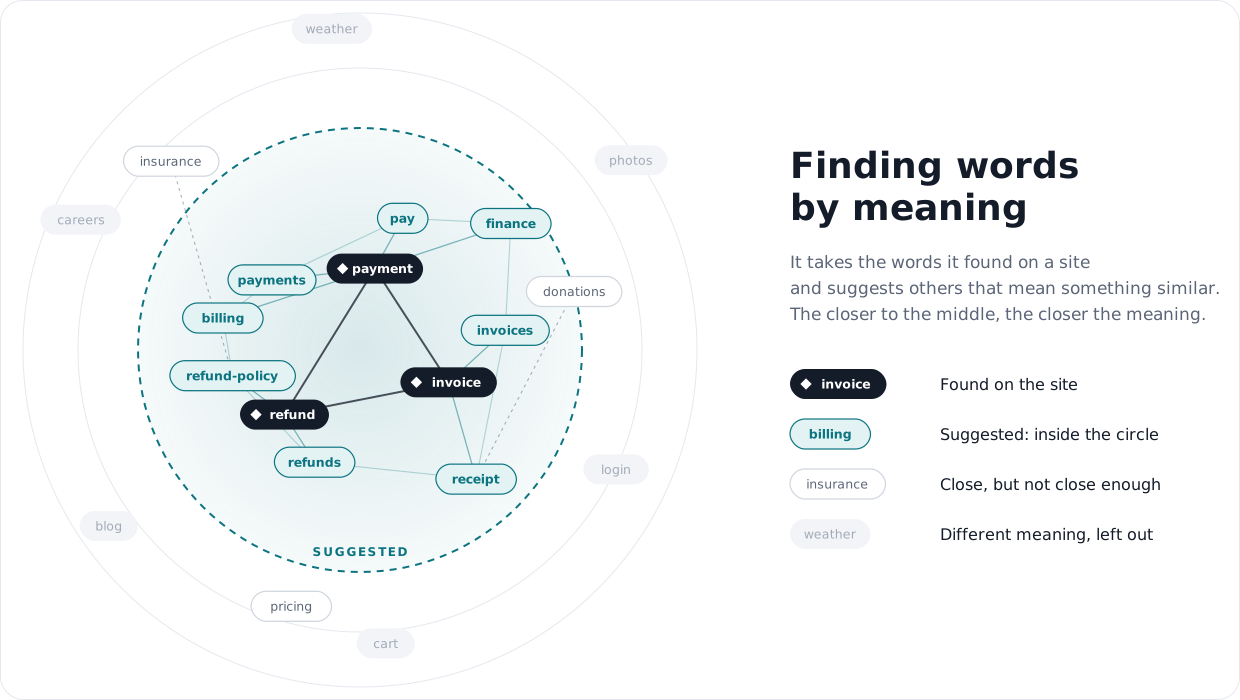
invoice, payment, refund를 사용하는 대상에는 아카이브가 본 적이 없더라도 billing, receipts, refund-policy라는 것도 있을 가능성이 높습니다. -x를 사용하면 도구가 찾은 단어를 의미별로 그룹화하고 각 그룹에 맞는 단어를 제안합니다. 작은 모델이 CPU에서 실행되므로 대상의 단어는 절대 당신의 머신을 떠나지 않습니다. 또한 대상 자체의 이름 구성 요소를 재조합합니다: delete_account와 user_profile은 delete_user를 만들어냅니다.
-p는 대상이 이미 사용하는 파라미터 이름을 나열하고, -p -x는 그것들로부터 만들어진 새로운 이름을 제안합니다: 대상이 invoiceId와 user를 사용하면 userId를 시도합니다. 찾은 것들에 가까운 가장 흔한 실제 파라미터 이름을 추가합니다. 한 폼에서 본 파라미터는 다른 모든 경로에서 시도할 가치가 있습니다; 많은 IDOR과 대량 할당(mass-assignment) 버그가 이렇게 발견됩니다.
생성된 목록은 대상에 특화된 내용을 다룹니다. raft와 Assetnote는 여전히 모든 사이트가 가지는 일반적인 경로를 커버합니다. 둘 다 실행하세요. -x의 제안은 적합도에 따라 순위가 매겨진 추측이므로, head -n 500은 가장 좋은 것들을 선택합니다. 9개의 버그 바운티 대상에서 보류해 둔 실제 디렉터리에서, 500개의 제안을 raft에 섞으면 같은 크기의 raft 단독 실행과 동일한 수의 경로를 찾았으므로, -x는 대상 자체의 주제를 탐색하는 방법으로 취급하세요. 자세한 내용은 docs/expansion.md에 있습니다.
테스트가 허용된 대상만 테스트하세요.
Python 3.11+와 gau가 필요합니다.
$ go install github.com/lc/gau/v2/cmd/gau@latest
$ git clone https://github.com/SomeKirill/wordlist_generator
$ cd wordlist_generator
$ pip3 install -r requirements.txt
$ pip3 install -r requirements-semantic.txt   # optional, only for -x neighbours
$ ./wordlist_generator.py -d example.com > words.txt              # words from the pages
$ ./wordlist_generator.py -d example.com -dir > dirs.txt           # directory names
$ ./wordlist_generator.py -d example.com -p --links > params.txt   # parameter names
$ ./wordlist_generator.py -d example.com -dir -x --limit 1000 > new-dirs.txt
$ ffuf -u https://example.com/FUZZ -w dirs.txt -w new-dirs.txt
단어 목록만 stdout으로 출력되므로 리다이렉션이 안전합니다. ./wordlist_generator.py -h는 모든 옵션을 나열합니다.
-x의 작동 방식, 클러스터 폭(--coverage), 측정된 결과 및 한계.-x는 처음 사용할 때 다운로드합니다(타사 항목은 번들로 포함되지 않음): snowflake-arctic-embed-xs 모델(Apache-2.0), --pool web 및 --pool params용 Assetnote wordlists, --pool web용 wordfreq(데이터 CC BY-SA 4.0).Apache License 2.0에 따라 라이선스가 부여됩니다.






